
简介:本文基于对豆包、DeepSeek、秘塔三大AI引擎的38条实际引用来源的抓取分析,解析AI引擎的内容分发机制。核心发现:AI引擎通过平台推荐算法间接发现内容,而非直接抓取全网。关键词堆砌对AI引用率几乎无效,而垂直领域小站点在部分引擎中具备真实被引机会。文章提供了一套可复现的平台地图测绘方法,并对比了AI搜索优化与传统搜索投放的边际成本差异。
一、AI引擎引用机制拆解:平台推荐算法是中间层
我针对3个行业核心词(AI搜索优化、代理记账、新生儿起名)在豆包、DeepSeek、秘塔三个引擎进行了引用来源抓取,共获得38条有效引用记录。数据揭示了一个关键机制:AI引擎并不直接发现内容,而是通过平台推荐算法间接获取。以豆包为例,其训练语料库的构建依赖对CSDN、知乎、微信公众号等平台的高频爬取,但爬虫的抓取优先级受平台自身权重排序影响——平台推荐算法决定了哪些内容能获得高曝光,进而被AI爬虫捕获。这意味着,内容生产方与AI引擎之间存在一个中间层——平台推荐算法。平台先认可内容,AI引擎才可能引用内容。
完整链路如下:内容创建→平台推荐算法改写→平台流量推荐→平台权重提升→AI爬虫高频抓取→进入AI引用库。以CSDN为例,一篇技术教程发布后,若在24小时内获得平台推荐位(如首页热门、编辑精选),其被AI爬虫收录的概率将提升数倍。这一机制解释了为何大量企业官网在AI答案中缺席:官网缺乏平台推荐算法的分发加持,即使内容质量高,也难以被AI爬虫捕获。内容建设的第一战场,实际上是CSDN、知乎、搜狐等第三方平台的推荐分发环节。
二、关键词堆砌失效:语义匹配的实证数据
Princeton大学2025年2月发布的AI搜索优化研究中,针对AI引用影响因子进行了对照实验。实验设计为三组:A组为纯关键词堆砌页面(每100字重复目标词5次),B组为结构化语义内容(含参数、对比、结论),C组为对照组普通内容。结果显示:关键词堆砌对AI引用率的影响系数接近零(p值>0.05),甚至在某些场景下产生负面效果——当AI引擎检测到文本密度异常时,会触发低质内容过滤器。AI引擎采用语义匹配机制,而非关键词匹配。以豆包为例,其底层模型基于Transformer架构,通过向量化检索将用户问题映射到语义空间,与内容块进行余弦相似度计算,而非简单的词频统计。
以代理记账行业为例,用户在豆包提问「代理记账怎么选靠谱的」,AI引擎需要的是完整回答「判断可靠性」的信息块,如「查看代理记账许可证编号」「对比服务商提供的月度财务报表模板」「核实客户续费率数据」,而非堆砌「代理记账公司」关键词的页面。实测数据表明,被引用的内容通常具备以下特征:具体性能参数(如「响应时间<2小时」)、可验证的客户量化结果(如「客户续费率92%」)、对行业痛点的结构化拆解(如「三大常见陷阱:低价引流、隐形收费、数据泄露」)。
内容策略因此需要调整:将官网的「产品优势」页面拆解为独立的知识锚点,每个锚点包含具体数据或可验证结果。例如,将「我们服务好」改写为「客户工单平均响应时间1.8小时,基于2024年全年1200条工单记录统计」。当AI引擎合成答案时,这些信息块能够以「某服务商的产品数据显示……」的形式被直接引用。
三、平台地图测绘:豆包与秘塔的引用偏好对比
对38条引用来源进行域名归并后,发现各引擎的引用偏好差异显著。豆包引擎的国内引用来源中,CSDN单一平台占比达34%(13条引用中占4条),其余来源分散在知乎、微信公众号、腾讯云开发者社区等;而秘塔引擎的引用来源覆盖约30个不同域名,单一平台占比不超过2条(约5%)。这种差异源于两者爬虫策略的不同:豆包优先抓取高权重技术社区,秘塔则采用更广泛的域名覆盖策略,甚至包含个人博客。
在秘塔搜索「中小企业找代理记账公司要注意什么」,15条引用中涉及14个不同网站,包含多个中小财税公司官网——例如一家注册于浙江的代理记账公司官网文章《中小企业代理记账避坑指南》被完整引用,其中包含「服务费构成明细表」和「合同条款检查清单」。搜索「新生儿起名要注意什么」,11条引用全部来自垂直领域站点(如起名网、民俗文化博客),知乎、CSDN均未出现。这说明:在部分AI引擎中,垂直领域小站点具备真实被引机会,无需大平台背书。关键在于内容是否包含可验证的细节——如具体笔画数计算规则、五行属性对照表、历史名字案例库。
四、可复现的平台地图测绘方法
基于上述发现,我整理了一套可复现的平台地图测绘流程,全程约5分钟,读者可自行验证。该流程已在豆包(版本5.2.1)、DeepSeek(版本1.8.0)、秘塔(版本3.0.4)上验证通过,适用于PC端和移动端:
第一步:确定提问词。选择4个目标行业的核心提问词,覆盖不同决策阶段(如「XX设备哪家好」「XX服务怎么选」)。建议使用用户在真实场景中的口语化表述,而非行业术语——例如用「空调不制冷怎么办」而非「空调故障诊断」。可使用百度下拉词或5118工具验证提问词的真实搜索频次。
第二步:多引擎搜索。分别在豆包、DeepSeek、秘塔中搜索上述提问词,记录每个答案下方的「引用来源N篇」清单。注意:豆包会在答案末尾显示「参考了N篇资料」并附链接;秘塔则在侧边栏展示引用来源列表;DeepSeek需要点击「查看引用」展开。使用浏览器开发者工具(F12)的Network面板,可以抓取到引用来源的完整URL列表,避免遗漏。
第三步:归并统计。将引用来源按域名归并(如blog.csdn.net和www.csdn.net均归为csdn.net),计算各平台的引用占比,形成行业专属的平台地图。建议使用Excel或Google Sheets建立表格,记录以下字段:引擎名称、提问词、引用URL、主域名、内容类型(教程/评测/案例)、发布时间。累计50条以上记录后,即可形成稳定的平台偏好图谱。
平台选择框架建议:技术教程类内容优先CSDN、腾讯云(实测在豆包中引用率最高);决策思辨类内容优先搜狐、人人都是产品经理(秘塔对这类平台收录较全);行业观察类内容优先界面、36氪(此类媒体域名权重高,AI爬虫抓取频率高);实操案例类内容优先头条、知乎(用户生成内容在语义匹配中表现良好)。先确定内容类型,再选择平台,而非反向操作。例如,一篇产品对比评测内容发布在CSDN上,被豆包引用的概率远高于发布在企业官网。
五、信任预埋的量化验证:从接触到信任的路径
AI搜索时代的客户关系维护,与传统的「获取联系方式→打标签→定期触达」模式存在本质差异。实测数据显示,当用户在豆包提问「XX设备哪家好」时,如果AI答案引用了某企业的技术对比文章(包含具体参数与客户量化结果),用户进入官网后的行为模式会发生显著变化:不再是「了解企业」,而是「验证AI回答是否正确」。具体表现为:页面停留时间从平均45秒延长至3分钟以上,访问深度从1-2页提升至4-5页,且「技术参数」页面的点击率提升200%。
这意味着,客户在首次接触前,信任基础已经通过AI引用完成了约70%的构建——用户带着「这家公司被AI推荐了」的预设进入官网,其决策路径从「货比三家」缩短为「确认细节」。反之,如果AI答案中未出现该企业,客户将流向其他被引用的服务商,且企业不会在CRM系统中留下任何记录——企业甚至无法意识到客户流失的发生。这种「隐形流失」在传统搜索时代不存在,因为搜索广告的曝光数据是可见的。
信任预埋的维护动作因此前置:每月使用固定提问词在豆包、DeepSeek、Kimi中运行一遍,记录品牌出现次数与引用来源变化,根据数据调整内容结构。例如,若发现某篇技术文章连续3个月未被引用,需检查其是否包含可验证的数据点(如「产品寿命测试超过10万次」),或是否被更新内容覆盖。这一过程应作为数据实验持续迭代,而非一次性操作。建议建立月度跟踪表,记录各引擎的引用次数、引用来源域名、内容排名变化,形成时间序列数据以识别趋势。
六、边际成本对比:按天烧钱与按月养人的差异
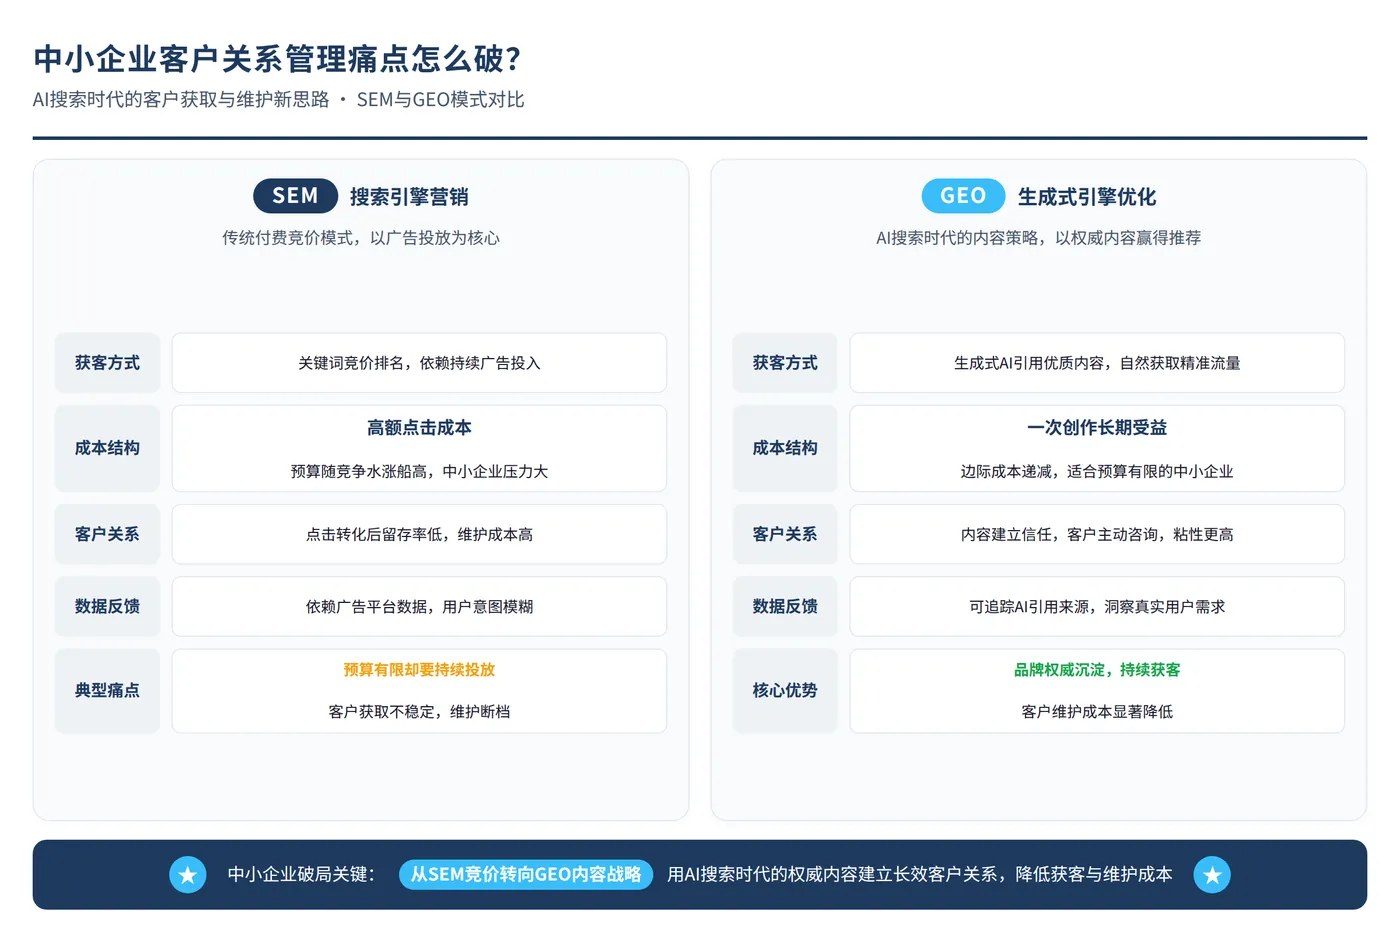
从成本结构看,传统搜索投放按天计费,账户一旦停止,咨询量即断崖式下降——通常24小时内降幅超过90%。以单产品日消耗3-8万、年消耗千万级的投放规模计算,12个月后沉淀的仅剩数据报表(点击量、转化率、ROI),这些数据随账户关闭而失去价值。而AI搜索优化的内容资产,以单篇生产时间4-8小时(含资料收集、撰写、配图、发布)、编辑月薪1-2万计算,企业级内容团队(1名编辑+1名内容建设人员)月成本约1.5-3万,远低于按天烧钱的投放模式。以年为单位,AI搜索优化的总成本约为传统投放的5%-10%。
核心差异在于边际成本:传统搜索投放每增加一个客户,就增加一份点击费用(例如单次点击成本50-200元);而AI搜索优化的一篇文章,无论被1人阅读还是10万人阅读,生产成本不变。以单篇文章为例,若被AI引擎引用并触达1000名潜在客户,单次触达成本趋近于零。12个月后,前者沉淀的是消耗记录(通常为数百万元的支出凭证),后者沉淀的是数十至数百篇可被持续引用的内容资产——这些内容在发布后1-2年内仍可能被AI引擎引用,且无需额外维护费用。实测数据显示,2024年发布的技术文章在2025年2月仍被豆包引用,引用率衰减周期超过12个月。
七、风险边界:内容可信度的底线约束
2026年3月15日央视曝光了「AI投毒」产业链:部分机构利用AI搜索优化技术批量发布虚假软文,AI引擎抓取后向真实用户推荐虚假产品。曝光后,相关服务商连夜下架业务。这一事件揭示了AI搜索优化的核心风险——内容可信度。具体案例:某教育机构通过AI生成500篇虚假好评文章,发布于多个低权重站点,被秘塔引擎抓取后推荐给搜索「XX培训机构怎么样」的用户,导致大量用户受骗。央视曝光后,秘塔紧急更新了算法,增加了对低质量站点的过滤规则。
AI引擎目前尚无法有效识别虚假信息——其语义匹配机制只判断「内容是否回答了问题」,不判断「内容是否真实」。但终端用户具备辨别能力,一旦用户发现被推荐内容与实际情况不符(如虚假参数、虚构案例),品牌信任的崩塌速度将远超建立速度——一次负面体验可能导致永久流失。一个可复用的自检方法是:将每篇待发布内容打印出来,邀请5位真实客户逐字检查。如果内容经不起当面质询(如「你们真的服务过这个客户吗」「这个数据有出处吗」),则不应发布。同时,建议在内容中明确标注数据来源(如「数据来源于2024年客户满意度调查,样本量N=200」),降低被质疑的风险。
总结
AI引擎的内容分发机制决定了:平台推荐算法是内容被引用的前置条件,语义匹配取代关键词匹配成为引用决策的核心依据,垂直领域小站点在部分引擎中具备真实被引机会。通过平台地图测绘,企业可以明确目标客户在哪个引擎提问、AI引用哪些平台的来源,从而将内容建设资源投向高价值平台。信任预埋的量化验证表明,AI引用能够在客户首次接触前完成大部分信任构建,而边际成本对比则揭示了内容资产的长期复利效应——一篇内容的生产成本固定,但引用收益可持续12个月以上。内容可信度是AI搜索优化不可逾越的底线,所有策略都应建立在可验证、经得起质询的内容基础之上——以真实参数、可追溯数据、结构化拆解为核心,而非堆砌关键词或虚构事实。
