前言:
在自然语言处理中,人类语言的意义高度依赖于词语的排列次序。“猫抓老鼠”与“老鼠抓猫”虽然包含完全相同的词汇,表达的物理事实却截然相反。然而,作为现代大模型核心引擎的自注意力机制(Self-Attention),其本质在数学上是一个对输入顺序完全“脱敏”的无序集合运算。若不人为施加时空线索,模型眼中的文章便只是一堆散落的拼图。本文从“电影院绝对座位号”到“高维时钟旋转指针”的生动演进切入,深度拆解为什么自注意力机制天生缺乏时序感知,透视 RoPE(旋转位置编码)如何利用复数旋转让相对距离自然浮现,并解析大模型突破百万 Token 上下文窗口的长文本外推秘诀。
1. 天生语序盲:自注意力机制的时序缺失
要理解为什么大模型必须引入位置编码,首先要正视 Transformer 基础架构在处理序列时的一大数学“缺陷”。
1.1. 词袋效应与置换不变性
在自注意力计算中,模型将每一个词转化为查询向量(Q)、键向量(K)与值向量(V)。当模型计算词语之间的关联度时,其核心算子是向量点积。
在数学上,向量点积只取决于两个向量本身的数值方向与模长。如果随意将一句话中的词语前后顺序打乱,甚至把整段文字颠倒过来输入模型,自注意力层计算出的每对词之间的相似度矩阵数值完全不会发生任何改变。这种特性在数学上被称为置换不变性(Permutation Invariance)。换句话说,如果不额外补充位置信息,大模型本质上只是一个高维的“词袋统计器”,根本无法区分谁是动作的发起者,谁是承受者。
1.2. 早期尝试:绝对座位号与正弦函数的硬编码
为了打破置换不变性,最初的 Transformer 架构引入了绝对位置编码(Absolute Position Embedding)。
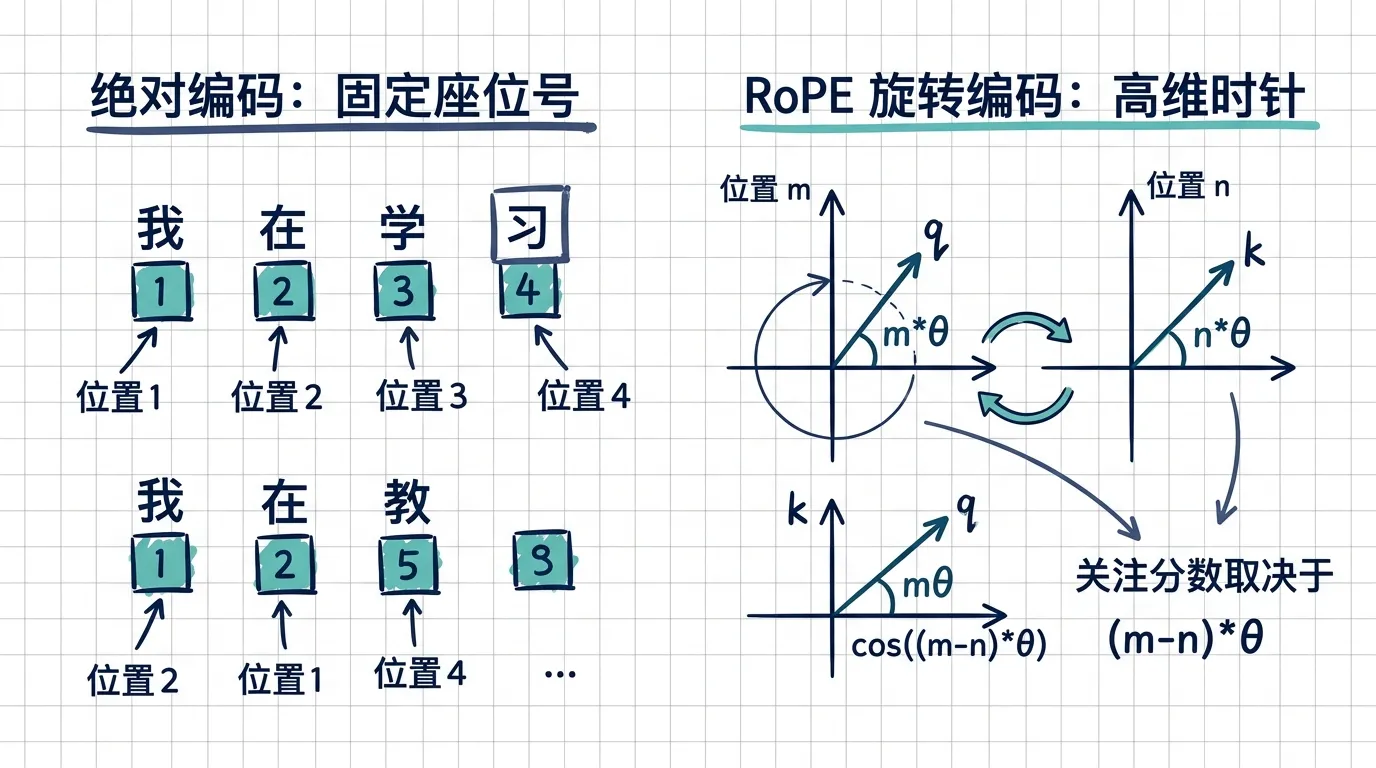
这一思路如同给电影院里的每一个观众发放一张固定编号的座位票。无论是第 1 个字还是第 100 个字,算法都会根据其所在的绝对序号,生成一个由正弦与余弦函数交织而成的绝对位置向量,并直接加到原始的词向量上。
这种做法虽然成功让模型知道了“谁坐在第几排”,但在处理长篇大论时暴露出了致命硬伤:模型死记硬背的是绝对物理编号,一旦推理时遇到的文章长度超过了训练时设定的最大座位数,模型便会面对从未见过的位置向量而彻底陷入逻辑混乱;更重要的是,语言交流的核心在于词与词之间的相对距离(例如“虽然”和“但是”相隔了多远),而非某个词到底位于全书的第几个字符。
2. 时空罗盘:RoPE 旋转位置编码的几何直觉
为了兼顾绝对位置的注入与相对位置的自然推导,开源大模型基座(如 Llama、Qwen、DeepSeek 等)全面转向了由中国学者苏剑林提出的 RoPE(Rotary Position Embedding,旋转位置编码)。
2.1. 将高维向量拆解为二维时钟平面
RoPE 的核心灵感在于:不要通过粗暴的向量加法去污染语义,而是通过纯粹的高维几何旋转来标记时序。
一个隐藏层维度为 4096 的词向量,可以在数学上拆解为 2048 个相互正交的二维子平面。每一个二维子平面都可以视为一个独立的圆形时钟表盘。
当一个词位于句子的第  个位置时,算法并不改变其向量的长度,而是根据其位置序号 与该维度的预设基准角速度,将这个二维向量在表盘上顺时针旋转对应的角度。位置越靠后,时针旋转的角度就越大。
2.2. 内积中的神奇对消:相对距离自然浮现
RoPE 最精妙的数学魅力在于两个词向量计算注意力得分的瞬间。
当位于第 个位置的查询向量(旋转了 个单位角度),去和位于第  个位置的键向量(旋转了 个单位角度)进行点积内积计算时,根据二维平面旋转矩阵与欧拉公式的正交性质,两个绝对角度在内积公式中会自然相减,最终留下的计算结果仅仅取决于两个位置之间的相对角度差值(
 )。
这就好比两位钟表观察者,无论他们各自顺时针转动了多少整圈,只要两根表针之间的相对夹角固定,他们之间的几何距离就恒定不变。这种设计让大模型既具备了感知绝对位置的能力,又在底层运算中天然获得了对相对距离的精准度量。
3. 算法推演:PyTorch 极简 RoPE 算子实现
在工业级工程落地中,RoPE 避免了昂贵的大矩阵乘法,而是通过逐元素相乘(Element-wise Multiplication)实现了极高吞吐的显存优化。
3.1. 旋转算子与复数乘法的工程映射
将一个二维向量旋转特定角度,等价于将其乘以一个正交旋转矩阵。在实际代码中,这可以通过提取向量的奇数与偶数维度,分别与对应位置的余弦(Cosine)和正弦(Sine)频率矩阵进行交织运算来实现。
以下代码完整展示了在 PyTorch 中构建 RoPE 旋转频率网格并将其实时施加在输入特征张量上的底层逻辑:
import torch
import torch.nn as nn
def precompute_freqs_cis(dim: int, end_pos: int, theta: float = 10000.0) -> torch.Tensor:
    """
    预先计算每个维度在不同位置上的旋转角度复数频率张量

    参数说明:
    - dim: 单个注意力头的特征维度(必须为偶数)
    - end_pos: 支持的最大上下文位置序列长度
    - theta: 频率衰减基数,控制高频与低频维度的角速度跨度
    """
    # 1. 计算每个二维子平面的基础角速度频率 (dim // 2)
    freqs = 1.0 / (theta ** (torch.arange(0, dim, 2)[: (dim // 2)].float() / dim))
    t = torch.arange(end_pos, dtype=torch.float32)

    # 2. 向量外积生成全量位置与维度的角度矩阵 (end_pos, dim // 2)
    freqs = torch.outer(t, freqs)

    # 3. 转换为极坐标复数形式 e^(i * theta)
    freqs_cis = torch.polar(torch.ones_like(freqs), freqs)
    return freqs_cis
def apply_rotary_emb(x: torch.Tensor, freqs_cis: torch.Tensor) -> torch.Tensor:
    """
    将预计算的旋转位置编码施加在 Query 或 Key 张量上
    """
    # 将输入张量切分为实部与虚部配对的复数张量 (B, Seq_Len, H, Dim//2)
    x_complex = torch.view_as_complex(x.float().reshape(*x.shape[:-1], -1, 2))

    # 截取当前输入序列长度对应的频率张量并广播相乘(等价于二维时针旋转)
    freqs_cis_slice = freqs_cis[:x.shape[1]].unsqueeze(0).unsqueeze(2)
    x_rotated = x_complex * freqs_cis_slice

    # 将旋转后的复数重新展平还原为原始维度的实数张量
    x_out = torch.view_as_real(x_rotated).flatten(3)
    return x_out.type_as(x)
if __name__ == "__main__":
    head_dim = 64
    seq_length = 8
    batch_size = 2
    num_heads = 4

    # 预计算频率并模拟生成 Query 向量
    freqs_cis = precompute_freqs_cis(dim=head_dim, end_pos=128)
    mock_query = torch.randn(batch_size, seq_length, num_heads, head_dim)

    # 施加 RoPE 旋转
    query_with_rope = apply_rotary_emb(mock_query, freqs_cis)
    print(f"RoPE 施加完成,张量形状与精度保持不变: {query_with_rope.shape}")
4. 远近有别:远程衰减与长文本外推突破
自然语言的一个基本规律是:相邻的词语通常语义关联极强,而相隔数千字的词语其直接句法关联往往会自然减弱。
4.1. 频率分级带来的天然长程衰减
在 RoPE 的频率设计中,低维度子平面的角速度极高(像秒针一样快速转动,捕捉相邻词的细微颠倒),而高维度子平面的角速度极低(像时针一样缓慢转动,捕捉宏观跨段落的主题)。
随着两个词的相对距离逐渐拉大,各维度旋转向量的点积在积分层面上呈现出天然的长程衰减特性(Long-term Decay)。这使得模型既能极其敏锐地感知眼前短语的语法结构,又不会被数千字之前的无关噪声干扰。
4.2. 从 4K 到 100 万:外推与内插插值技术
当模型需要在推理时处理远超预训练长度的超长文档时,如果直接外推,高速旋转的高频维度会进入模型从未见过的超大角度盲区,导致输出崩溃。
为了解决这一问题,工业界发展出了**位置内插(Linear Interpolation)**与 NTK-aware 频率缩放(YaRN) 技术。算法并不硬性拉大总旋转圈数,而是将原本 100 万字的高维表盘“分度值”等比例加密压缩回原本 4K 或 8K 的角度区间内。通过对高频维度保持局部精度、对低频维度进行宏观缩放,大模型得以在无需重新耗费巨资训练的前提下,平滑拓展出百万 Token 级的超长上下文理解能力。
核心对比维度 |
早期绝对正弦编码(Sinusoidal PE) |
早期可学习绝对编码(Learned PE) |
旋转位置编码(RoPE) |
位置注入方式 |
词向量与位置向量直接相加 |
随机初始化参数并在训练中学习相加 |
向量按维度切片并在二维平面正交旋转 |
相对距离感知能力 |
需多层自注意力层间接拟合 |
缺乏数学保证,长距离感知泛化弱 |
点积内积自动转化为相对距离函数 |
长程衰减特性 |
不具备严格的单调衰减 |
容易过拟合到特定序列长度 |
高低频分级设计天然具备长程衰减 |
长文本扩展性(外推) |
无法直接适应超长文本 |
完全无法外推至未见过的位置编号 |
支持 NTK-aware/YaRN 等多种免重训外推方案 |
5. 总结:高维几何的时序韵律
从词袋模型的置换无序,到绝对座位的僵硬硬编;从二维时钟旋转的精妙内积,再到多频缩放下的百万长文本纵横推演——RoPE 并没有采用增加复杂参数量的笨办法,而是凭借纯粹的欧拉几何与复数旋转之美,在大模型的无序高维空间中刻画出了时间的刻度,让冰冷的数字矩阵真正理解了人类语言跌宕起伏的叙事韵律。