很多企业第一次做 Agent 测试的时候,都会建立一套测试集。
100条。
500条。
甚至1000条。
上线之前跑一次:
Accuracy:93.6%
Task Success:95.1%
Tool Calling:97.2%
大家觉得:
差不多,可以上线了。
但 Agent 真正进入生产以后,测试团队很快会发现一个问题:
测试集里的问题,反而不是最麻烦的。
真正麻烦的是生产环境每天都在产生你以前根本没有想到过的 Bad Case。
而且这些问题经常不是传统意义上的“接口报错”。
可能是:
用户换了一种说法,Agent 选错了 Tool;
MCP 返回超时以后,Agent 连续重试十几次;
知识库检索到了旧制度,模型却非常自信地回答;
Tool 调用成功了,但参数违反业务规则;
一次 Prompt 修改修好了问题A,却把问题B重新放了出来。
最近开源社区里的一些真实实践,其实已经开始指向同一个问题:
企业需要的不是一次性 Evaluation,而是一个持续生长的 AI 回归体系。
一、最近DeepSeek Harness社区出现了一个很有意思的真实案例
8月17日,DeepSeek Harness 社区有人分享了一个实际问题。
他想做一个“插件安装评审师 Agent”。
本来的流程并不复杂:
用户提出安装插件
        ↓
Agent评估插件
        ↓
给出建议
        ↓
等待用户确认
        ↓
安装 / 放弃
结果 Agent 在执行过程中出现了:
死循环。
持续数十轮打印类似内容,没有自动纠偏。
最后经过两次人工强制中断提醒才恢复。([github.com][3])
这个案例非常值得测试团队思考。
因为如果这是一个 Demo:
重启一下就完了。
但如果这是企业生产 Agent 呢?
比如:
客服 Agent;
工单 Agent;
数据分析 Agent;
运维 Agent;
财务 Agent。
一次死循环意味着什么?
可能意味着:
Token持续消耗
+
Tool重复调用
+
接口压力增加
+
任务无法完成
+
用户一直等待
所以企业 Agent 的测试指标,不能再只有:
Answer Correctness
还应该开始关注:
Max Steps

Repeated Tool Calls

Retry Count

Loop Detection

Task Timeout

Token Budget

Cost Budget
二、比如我们可以给Agent增加一个“执行预算”
假设企业客服 Agent 最多允许:
AGENT_BUDGET = {

    "max_steps": 12,
    "max_same_tool_calls": 3,
    "max_retries": 2,
    "max_tokens": 20000,
    "timeout_seconds": 30
}
测试的时候,不只是验证:
assert result.correct is True
而应该增加:
def evaluate_agent_budget(trace, budget):

    tool_counter = {
   }
    violations = []

    for event in trace:

        if event["type"] == "tool_call":

            tool = event["tool"]

            tool_counter[tool] = (
                tool_counter.get(tool, 0) + 1
            )

    if len(trace) > budget["max_steps"]:
        violations.append(
            "MAX_STEPS_EXCEEDED"
        )

    for tool, count in tool_counter.items():

        if count > budget["max_same_tool_calls"]:
            violations.append(
                f"REPEATED_TOOL_CALL:{tool}"
            )

    if trace.total_tokens > budget["max_tokens"]:
        violations.append(
            "TOKEN_BUDGET_EXCEEDED"
        )

    if trace.latency > budget["timeout_seconds"]:
        violations.append(
            "TIMEOUT"
        )

    return {

        "pass": len(violations) == 0,
        "violations": violations
    }
这样即使 Agent 最终把答案做对了:
Business Result:PASS
但是:
调用同一个Tool:11次

Steps:37

Token:68000

Latency:91s
测试结果依然应该是:
Reliability:FAIL
这才符合生产系统的质量标准。
三、但企业真正更麻烦的问题,是测试团队根本不知道该测什么
这是我认为目前很多企业做 AI 测试最现实的痛点。
传统软件测试非常成熟。
PRD来了。
测试工程师:
需求分析
↓
测试点
↓
Case
↓
自动化
↓
回归
但 Agent 不一样。
很多真正的问题来自:
生产环境。
用户会问一些产品经理从来没想到过的问题。
比如一个退款 Agent。
测试团队设计的是:
我的订单还没发货,帮我退款。
真实用户却说:
东西还在路上,我不想要了,你看着处理吧。
甚至:
上次你们客服答应我的,赶紧弄。
对于人来说:
意思很好理解。
但 Agent 可能完全走向不同的 Tool Path。
四、所以最近Langfuse社区一个实践我觉得特别值得企业测试团队借鉴
最近关于 Golden Dataset 的讨论中,一个很实用的思路是:
不要把 Evaluation Dataset 当成测试人员一次性设计出来的静态数据。
生产 Trace 本身就应该成为测试数据的重要来源。
也就是说:
Production Trace
       ↓
发现Bad Case
       ↓
人工确认问题
       ↓
加入Evaluation Dataset
       ↓
以后每个版本永久回归
这样:
每一次线上事故,都应该让测试体系变强一次。
而不是:
线上出问题
↓
研发修Bug
↓
上线
↓
三个月以后又出现
Langfuse 社区近期讨论也建议把代表性 Golden Dataset 用于 CI Gate,并把更大的数据集留给发布前或定期 Sweep;生产 Trace 可以直接沉淀为 Dataset。([github.com][2])
这个思想我觉得特别适合企业。
五、如果让我给企业搭一套体系,我会设计成“三层数据集”
不是一个 Evaluation Dataset 全部混在一起。
而是:
第一层:Smoke Dataset
比如:
50~100条
覆盖:
最核心业务;
最常用Tool;
关键RAG问答;
基础Agent任务。
每次:
Prompt修改
Model修改
MCP修改
Agent修改
PR阶段都跑。
第二层:Critical Business Dataset
比如:
退款
支付
价格
权限
合同
人工升级
关键业务规则
这些 Case 不一定很多。
但是:
必须100%通过。
例如:
CRITICAL_RULES = {


    "refund_over_limit": 0,

    "duplicate_payment": 0,

    "unauthorized_operation": 0,

    "missing_manual_review": 0
}
哪怕:
总体Accuracy = 99%
只要:
unauthorized_operation = 1
一样:
BLOCK。
六、第三层反而最重要:Production Failure Dataset
企业每天自动采集生产 Trace。
通过规则和模型发现异常:
Low Confidence

Tool Retry

Repeated Tool Call

High Latency

User Negative Feedback

Human Escalation

Business Rule Violation

LLM Judge Fail
例如:
def should_enter_regression(trace):

    return any([

        trace.user_feedback < 0,

        trace.retry_count >= 3,

        trace.repeated_tool_call,

        trace.business_violation,

        trace.llm_judge_score < 0.6,

        trace.manual_escalation

    ])
满足条件:
Production Trace
        ↓
Bad Case Candidate
进入测试平台。
测试工程师确认以后:
Bad Case
↓
标注Failure Type
↓
补Expected Behavior
↓
进入Regression Dataset
这样测试团队每天不是在:
机械增加Case。
而是在:
用真实业务不断扩大AI系统的能力边界。
七、最后会形成一个非常重要的闭环
             生产环境
                ↓
        Production Trace
                ↓
          Bad Case Mining
                ↓
        测试工程师确认
                ↓
       Evaluation Dataset
                ↓
          开发修改Agent
                ↓
      Automated Evaluation
                ↓
         Version Diff
                ↓
         Quality Gate
          ↓          ↓
        PASS       BLOCK
          ↓
         上线
          ↓
       生产环境
这时候 Evaluation 才真正成为:
Continuous Evaluation
而不是:
上线之前让测试工程师跑一下大模型评分。
八、还有一个企业特别容易踩的坑:修好了Bad Case,但整体反而退化了
假设生产发现:
用户问退款失败原因时,Agent经常调用 Order Tool。
研发于是优化:
Refund Tool Description
单独测试这个 Bad Case:
修好了。
是不是可以上线?
不能。
因为修改 Tool Description 后,模型的 Tool Selection 空间也发生了变化。
所以必须重新跑 Regression。
例如:
                  OLD       NEW

Bad Case           FAIL      PASS

Task Success       94.1%     95.3%

Tool Selection     95.7%     96.4%

Argument Accuracy  97.2%     96.9%

P95 Latency        4.1s      4.8s

Critical Pass      100%      100%
这次可以考虑上线。
但如果结果变成:
Critical Pass

100% → 97.8%
即使原来的 Bug 修好了:
依然不能发布。
这就是传统软件工程里很熟悉的:
Regression Testing。
只不过现在 Regression 的对象已经变成:
Model
+
Prompt
+
RAG
+
Harness
+
MCP
+
Tools
+
Memory
+
Agent Configuration
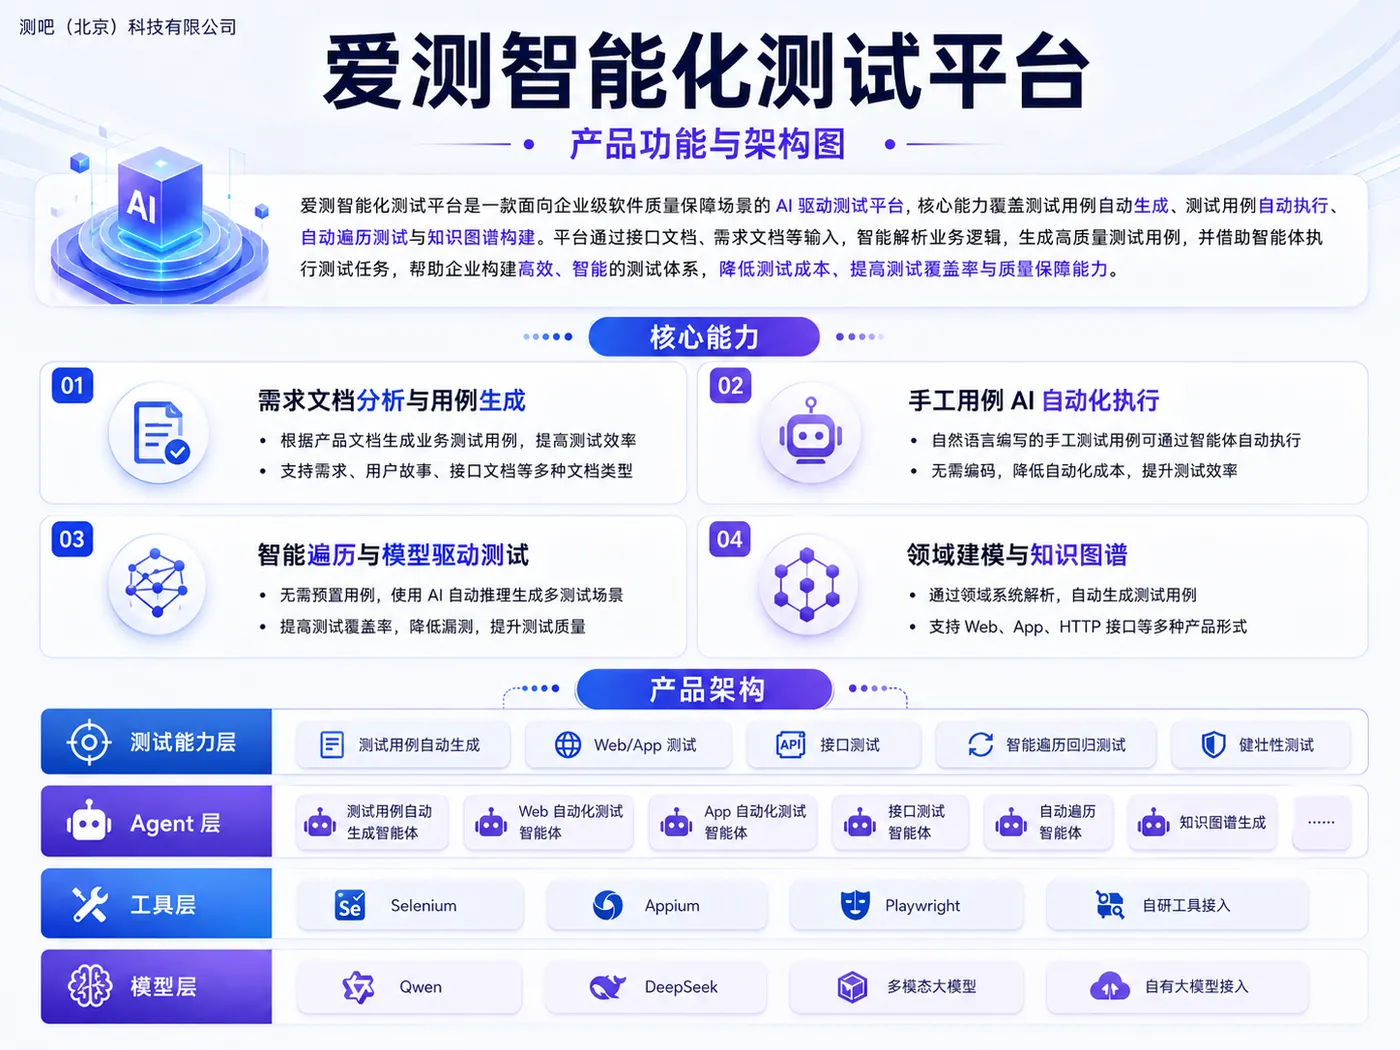
九、这也是爱测智能体真正应该帮助企业解决的问题
我们做爱测智能体,如果只是帮助测试工程师:
AI生成几个测试Case。
价值其实是有限的。
因为企业真正缺少的是:
一套AI质量资产持续积累机制。
围绕企业实际业务,爱测智能体可以承接的核心思路应该是:
企业业务数据
      ↓
Evaluation Dataset
      ↓
LLM / RAG / Agent评测
      ↓
Trace分析
      ↓
Bad Case沉淀
      ↓
版本Diff
      ↓
Continuous Regression
      ↓
Quality Gate
最终让企业拥有自己的:
AI质量资产库。
十、为什么我们更强调私有化和企业定制?
因为真正有价值的 Evaluation Dataset:
往往不是网上公开的 Benchmark。
而是企业自己的:
历史客服问题

真实订单流程

业务规则

企业知识库

生产Bad Case

内部API

MCP Tools

Agent Trace
这些数据:
既有价值,又敏感。
所以企业做 AI 测试,最终一定会遇到:
数据;
权限;
系统接入;
私有模型;
内部知识库;
真实业务流程
这些问题。
这也是为什么爱测智能体面向企业客户时,更适合围绕企业现有业务系统做:
定制化 + 私有化部署 + 企业质量体系建设。
平台不是替企业测试团队做判断。
而是把测试团队已经拥有的:
业务经验、测试经验、历史Bug和质量规则
变成:
AI时代可以持续执行、持续回归、持续积累的质量资产。
十一、最后,我觉得企业测试负责人现在应该问自己三个问题
不是:
我们公司有没有用AI?
而是:
第一,生产环境每天出现的AI Bad Case,有没有进入测试体系?
第二,每次换模型、改Prompt、升级MCP以后,我们能不能知道到底哪些业务能力退化了?
第三,企业能不能定义一条明确的线:什么样的Agent允许上线,什么样的必须BLOCK?
如果这三个问题现在还没有答案,
企业缺的可能已经不是:
“再买一个大模型。”
而是一套真正属于自己的:
AI Quality Engineering System。
这也是爱测智能体希望帮助企业建立的能力:
把真实业务变成Evaluation,把线上问题变成Regression,把测试经验变成企业长期积累的AI质量资产。
模型会换。
Agent框架会换。
MCP会升级。
但企业真正应该留下来的,是:
一套随着业务运行越来越强的AI质量体系。
业AI测试,最终还是要落到真实业务里
从 Evaluation Dataset、Bad Case 回归,到 Agent / RAG / MCP 测试,再到持续评测和质量门禁,真正落地到企业内部,往往比 Demo 复杂得多。
我们也在通过 爱测智能体平台,帮助企业测试团队探索 AI 测试的工程化落地,包括测试智能化、AI应用评测以及企业内部的定制化与私有化部署。
如果你的团队也正在做 AI测试平台建设、Agent/RAG测试或测试团队AI转型,欢迎交流。
爱测智能体平台体验账号
爱测智能体产品介绍
企业AI测试落地实践资料
企业客户也可进一步交流 私有化部署、企业内训及定制化AI测试解决方案。