大家好,我是晚安code。
上一篇我们把 ChatModel 跑通了,单次对话很爽。可一旦要写个真正能用的机器人,事情就没那么简单了:多轮记忆要自己存、输出 JSON 要自己解析、系统提示词要每个请求手动拼一遍,随便哪步写岔了都在线上炸给你看。这一篇要聊的 LangChain4j AiService,就是专门把这堆脏活收走的。点个收藏,我们开始。
一、为什么需要 AiService:从手写胶水到声明式
直接拿 ChatModel 写业务,代码会越写越肿。以「客服机器人」为例,你要自己维护一个消息列表、自己把历史拼进每次请求、自己从回复里抠出要用的字段。这些活跟业务没关系,却占掉一半代码量。
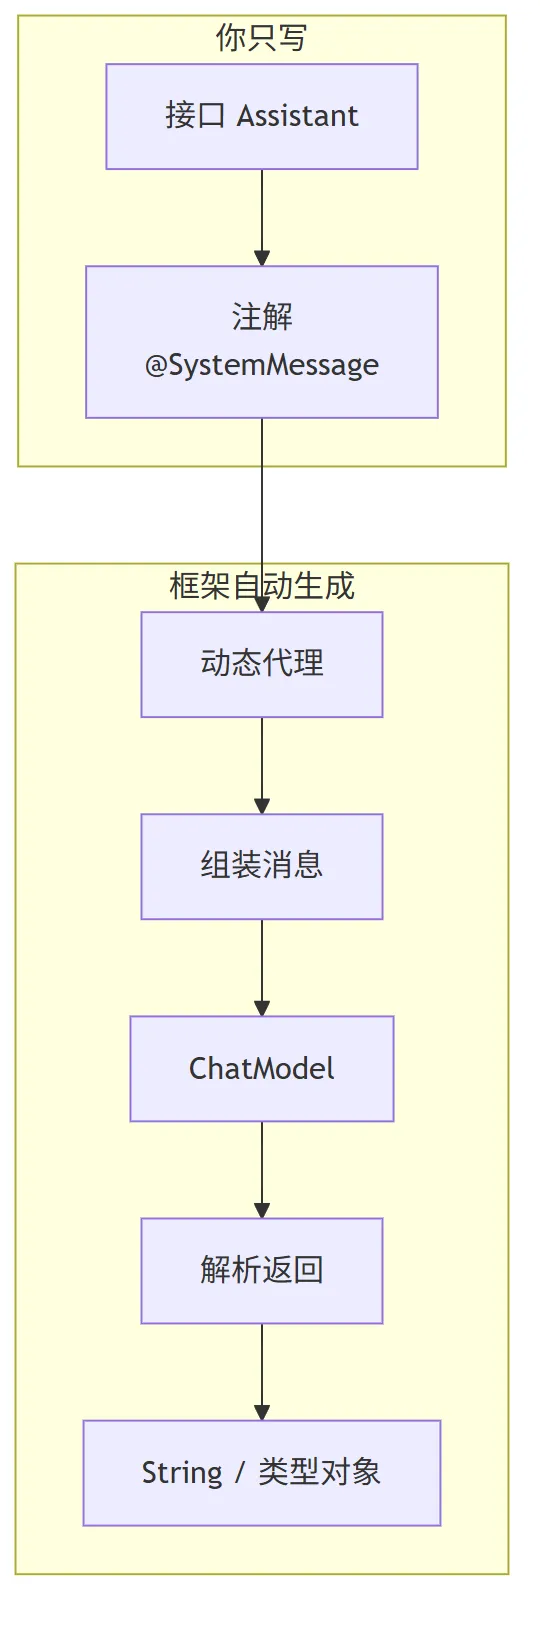
AiService 换了个思路:你只管定义一个 Java 接口、把需求用注解写清楚,实现类由框架在运行时生成。跟 Spring Data JPA 一个套路——你写 interface UserRepository,框架帮你生成数据库操作;这里你写 interface Assistant,框架帮你生成模型调用。
| 能力 | ChatModel 直调 | AiService |
|---|---|---|
| 多轮记忆 | 自己存消息、自己拼 | 配一个 ChatMemory 自动管 |
| 系统提示词 | 每次请求手动塞 SystemMessage | @SystemMessage 注解 |
| 结构化输出 | 自己写 JSON 解析 | 返回类型化对象,自动转换 |
| 工具调用 | 自己实现调用循环 | @Tool 注解自动接线 |
在 AI 应用里,这个对比的意义是:AiService 是 LangChain4j 所有高级能力的统一入口——对话、记忆、工具、知识库,都在这一个接口上装配,别再用低层 API 手工拼。
二、AiService 基础用法:一个接口跑通对话
AiService:LangChain4j 里用 Java 接口声明的 AI 服务。你定义接口、加几个注解,框架运行时生成实现类,替你完成消息组装、模型调用、结果转换。可以理解成「Spring Data JPA 的 Repository,只不过接的是大模型」。示例按 1.17.x 编写(2026 年 8 月),发布前记得核对官方文档。
最小用法,一个接口加一行创建:
public interface Assistant {

    @SystemMessage("你是贴心的小助手,用简体中文回复")
    String chat(String userMessage);
}

Assistant assistant = AiServices.create(Assistant.class, model);

String answer = assistant.chat("你好,介绍一下你自己");
System.out.println(answer);
AiServices.create() 是简版,要配记忆、工具的时候换 builder:
Assistant assistant = AiServices.builder(Assistant.class)
        .chatModel(model)
        .chatMemory(MessageWindowChatMemory.withMaxMessages(10))
        .build();
把接口定义出来,剩下的交给框架生成的代理——这就是声明式开发的甜头。我个人的体会(示例场景):第一次看到 AiServices.create 直接返回接口的实例,真有「写了个空接口它就跑起来了」的魔幻感。背后的动态代理做了三件事:组装消息、调模型、解析返回。
三、Prompt 提示词模板:把动态内容塞进提示词
写业务时提示词几乎都是带变量的:翻译的语言、总结的文本、要提取的字段,每次都不一样。LangChain4j 用 PromptTemplate 处理:
PromptTemplate template = PromptTemplate.from(
    "把下面这段话翻译成{
   {language}},只输出译文:\n{
   {text}}"
);

Prompt prompt = template.apply(Map.of(
    "language", "英文",
    "text", "你好,世界"
));

ChatResponse response = model.chat(prompt.toUserMessage());
System.out.println(response.aiMessage().text());
在 AiService 里更省事,注解里直接写模板,方法参数自动填进 {
{变量}}:
public interface Translator {

    @UserMessage("把下面这段话翻译成{
   {language}},只输出译文:\n{
   {text}}")
    String translate(@V("language") String language, @V("text") String text);
}
@V 是给变量起名,编译器开了 -parameters 的话可以省略(Spring Boot、Quarkus 默认带)。还有个偷懒写法:变量只有一个时用 {
{it}},方法参数自动顶进去。提示词模板的价值在于把「prompt 工程」沉淀成可维护的配置,而不是散落在代码字符串里。
四、ChatMemory:让 AI 记住你说过的话
ChatMemory(会话记忆):保存多轮对话历史的数据结构。大模型本身不记上下文,每次调用都是独立的,是记忆把之前聊过的内容带进下一次请求。
不加记忆的机器人,你上一句刚说完名字,下一句它就忘了,问「我叫什么」直接懵。加了记忆就不一样:
public interface Assistant {

    String chat(String userMessage);
}

Assistant assistant = AiServices.builder(Assistant.class)
        .chatModel(model)
        .chatMemory(MessageWindowChatMemory.withMaxMessages(10))
        .build();

assistant.chat("你好,我是程序员天天困");
assistant.chat("我叫什么名字?"); // 记得住
默认的 MessageWindowChatMemory 是消息窗口:只保留最近 N 条,老消息自动丢。想要更精确地控预算,用 TokenWindowChatMemory——按 token 数而不是条数截断,大模型按 token 计费,预算更好控。
可能有人会问:加了记忆是不是把历史全部塞给模型?
不是。窗口记忆只保留最近 N 条/N 个 token,超出就滚动淘汰。真正全部保留的是「持久化」的事:实现
ChatMemoryStore接口,把消息落库,重启也不丢。本地 demo 用内存版够了,生产按用户维度隔离,一个用户一条记忆。
多用户场景必须做隔离,否则 A 用户的消息串到 B 用户那里去了。用 @MemoryId + ChatMemoryProvider:
public interface Assistant {

    String chat(@MemoryId String memoryId, @UserMessage String message);
}

Assistant assistant = AiServices.builder(Assistant.class)
        .chatModel(model)
        .chatMemoryProvider(memoryId -> MessageWindowChatMemory.withMaxMessages(10))
        .build();

assistant.chat("alice", "你好,我是 Alice");
assistant.chat("bob", "你好,我是 Bob");
assistant.chat("alice", "我叫什么名字?"); // 回答 Alice,不会串到 Bob
窗口记忆是默认选择,但生产上更推荐按用户建记忆——消息窗口看条数、Token 窗口看预算,两者都别让单条记忆无限增长。
五、结构化输出三种方式:纯提示词 / JSON Mode / JSON Schema
从模型拿到的是自然语言,业务却要结构化数据:提取客户信息、解析天气、生成卡片 JSON。LangChain4j 给了三条路,严格度递增,对应不同场景。
方式一:纯提示词约束(最通用,最不稳)
在提示词里说清楚「只输出 JSON」,然后自己用 Jackson/Gson 解析:
String answer = model.chat("""
    从下面这段文本里提取客户姓名、手机号和城市,只输出 JSON:
    {
   "name": "...", "phone": "...", "city": "..."}

    文本:张三是杭州的用户,电话 13812345678
    """);

// 自己用 Jackson 解析
Customer customer = objectMapper.readValue(answer, Customer.class);
通用性最强,所有模型都吃这一套。问题也明显:模型可能不老实,多解释一句、加个 Markdown 代码块、字段名跑偏,你的解析器当场崩。

方式二:JSON Mode(保证是合法 JSON)
responseFormat 指定 JSON 类型,模型被约束输出合法 JSON:
OpenAiChatModel model = OpenAiChatModel.builder()
        .apiKey(System.getenv("OPENAI_API_KEY"))
        .modelName("gpt-4o-mini")
        .responseFormat(ResponseFormat.builder()
                .type(ResponseFormatType.JSON)
                .build())
        .build();
JSON Mode 只承诺「是 JSON」,不承诺「长什么样」——字段名、嵌套结构还得靠提示词兜底,解析仍要自己做。适合「只要合法 JSON 就行」的场景,能挡住一半的解析崩溃。
方式三:JSON Schema / 类型化对象(最严格)
把返回定义成一个 record,AiService 直接返回类型化对象,框架自动按 schema 解析、反序列化:
record Customer(
        @Description("客户姓名") String name,
        @Description("手机号") String phone,
        @Description("所在城市") String city
) {
   }

public interface CustomerExtractor {

    Customer extract(String text);
}

CustomerExtractor extractor = AiServices.create(CustomerExtractor.class, model);
Customer customer = extractor.extract("张三是杭州的用户,电话 13812345678");
System.out.println(customer.name()); // 张三
框架会把 record 转成 JSON Schema 描述给模型,模型严格按结构输出,连字段含义都通过 @Description 交代清楚。部分供应商(Gemini、Mistral 等)还要在构建模型时声明 supportedCapabilities(RESPONSE_FORMAT_JSON_SCHEMA) 才开启。
| 方式 | 严格度 | 输出保证 | 自己解析 | 兼容性 |
|---|---|---|---|---|
| 纯提示词 | 低 | 无 | 要 | 所有模型 |
| JSON Mode | 中 | 合法 JSON | 要 | 多数商业模型 |
| JSON Schema | 高 | 字段结构 | 不要 | 看供应商支持 |
我的取舍(示例场景):能用 JSON Schema 就别用纯提示词,解析崩溃的排查成本远高于配 schema 的成本;但本地部署的模型经常不支持严格模式,这时候降级到提示词约束最稳。三种方式不是替代关系,是按模型能力从高往低降级的关系。
六、小结
这一篇我们把 LangChain4j AiService 这个核心抽象拆开了:一个接口,提示词模板、会话记忆、结构化输出全自动装配。到这儿,一个「有记忆、能稳定吐 JSON」的对话服务已经成型。
下一篇是生产篇,也是系列最后一篇:RAG 知识库、工具调用、Guardrail 护轨、可观测性、SSE 流式输出,把 demo 真正推进生产。
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:你让 AI 吐结构化数据时,被格式坑过几次?