一、实时云渲染场景的选型标尺
实时云渲染的核心需求是“低延迟交互(操作指令与画面同步)、高画质流畅渲染、全终端兼容、低资源占用”,结合各方案的技术特性,从6个关键维度构建对比体系,明确选型边界: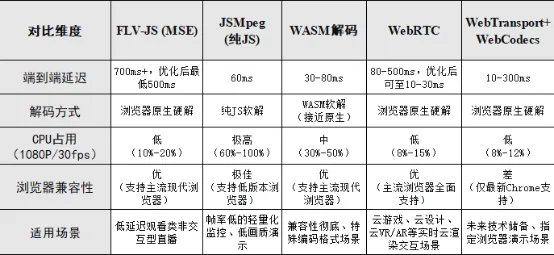
二、为何WebRTC是实时云渲染Web端的最优解?
结合上述对比与实时云渲染的核心需求,WebRTC成为最优选型,核心优势至少在三个关键层面:
1. 低延迟传输:匹配实时交互的核心诉求
实时云渲染的核心痛点是“操作与画面不同步”——云游戏中100ms以上的延迟会导致操作脱节,云设计中延迟过高会影响创作连贯性,云VR/AR场景更是要求延迟低于20ms以避免眩晕感。WebRTC基于UDP协议传输,无需像TCP那样进行多次数据确认,从传输层大幅降低延迟;同时支持快速重传机制,在30%丢包率下仍可保持流畅传输,远超其他基于TCP的方案(FLV-JS、WASM+WebSocket)。实测数据显示,原生WebRTC的端到端延迟可稳定在100ms以内,笔者在实际案例中,经过场景优化后甚至能达到10-30ms的局域网级延迟,完全覆盖实时云渲染的延迟需求。
2. 原生硬解+低资源占用:保障全终端流畅体验
实时云渲染需适配PC、手机、平板、VR头显等多终端,终端性能差异较大,低资源占用是保障全终端流畅的关键。WebRTC依赖浏览器原生硬解,相比JSMpeg纯软解和WASM软解,CPU占用降低60%以上,在低端手机上也能流畅支撑1080P/60fps的画质渲染;同时无需额外加载解码模块,首屏加载时间比WASM方案缩短80%,提升用户体验。
3. 双向交互+网络自适应:适配复杂场景需求
实时云渲染不仅需要“视频流下行”,还需要“操作指令上行”(鼠标、键盘、触控、VR手柄指令等)。WebRTC原生支持DataChannel双向数据通道,可将操作指令与视频流同步传输,指令延迟与视频延迟保持一致,实现“操作即反馈”的体验;同时内置网络自适应机制,可实时检测带宽变化,动态调整码率与帧率——当网络带宽下降时,自动降低画质以保障流畅,带宽恢复后立即提升画质,完美适配复杂的公网环境。
4. 兼容性与扩展性:支撑大规模商用落地
目前Chrome、Firefox、Edge、Safari等主流浏览器均已全面支持WebRTC标准,兼容性覆盖90%以上的终端设备,无需用户安装任何插件,可直接通过链接访问,大幅降低落地门槛。同时WebRTC支持自定义编解码参数与传输策略,可根据不同场景(云游戏、云设计、云VR)的需求进行深度优化,扩展性远超封闭的商业协议。
三、国产主流实时云渲染产品对WebRTC的场景化增强方案分析
原生WebRTC虽具备核心优势,但在实时云渲染的特定场景下仍存在优化空间——如复杂3D场景的编解码效率、弱网环境的画质保障、多终端适配差异等。笔者以目前国产实时云渲染主流厂商,如点量云流等厂商,对他们基于WebRTC标准,结合实时云渲染的场景需求进行的一些全链路深度优化做进一步分析,探讨在实时云渲染这类场景下,是如何进一步针对该特定场景适配和优化WebRTC,具体分析如下:
1. 传输层优化:智能拥塞控制
点量云流等厂商,一般会基于弱网的情况下,智能选最优传输策略,比如至少区分视频流与操作指令的传输优先级,确保操作指令优先传输。而针对云游戏、云VR等弱网容错需求,还会重点优化FEC(前向纠错)与重传协同机制,同时动态调整FEC冗余率(比如10%-50%自适应),平衡带宽开销与修复效果,在30%丢包率场景下仍能保障画面流畅度。
实测数据显示,经过优化后,公网环境下端到端延迟平均降低40%,北京到济南的跨地域端对端延迟稳定在30-50ms,局域网内延迟可控制在30ms以内。
2. 编解码优化:自适应编码+画质增强
针对实时云渲染的3D画质特点,如点量云流等主流厂商一般是很多策略从头到尾的优化。据介绍,其应至少包括如下策略:一是实现编码零拷贝,避免GPU和CPU态的切换;二是自定义自适应编码器,替代WebRTC内置的编码器,可动态切换H.264/H.265,并在编码器配置上,针对云游戏等高速运动画面优化运动估计算法,针对云VR的沉浸式场景强化边缘画质处理;三是智能帧策略优化,一方面确保帧可以即点即开,另一方面,避免帧的不均衡,传输导致延迟峰值。
在优化前后,实测显示,在5Mbps的弱网环境下,仍可稳定传输4K/60fps的画质,较原生WebRTC的弱网适配能力有明显提升。
3. 多终端适配兼容性优化:全场景兼容+交互同步优化
针对不同终端的浏览器差异,点量云流构建了WebRTC适配矩阵,通过动态降级策略——在支持WebRTC的主流浏览器上启用优化方案,在低版本浏览器上还保留有其它传输和解码方案,确保全终端覆盖,确保在常见浏览器上的兼容性。
实时云渲染Web端的协议选型,核心是“匹配场景需求的技术平衡”。一方面要兼顾低延迟、复杂网络环境;另一方面要考虑浏览器兼容性。
当然,在实践中我们发现,行业内如点量云流等一些头部厂商,还提供了客户端模式,据其官方介绍在客户端模式中,未使用WebRTC,而是基于其自研的DLCA协议进行的客户端实现;应该是考虑浏览器毕竟不是专门针对实时云渲染设计的,如果自研的客户端,应该可以在低延迟、交互性、实时性上可以做更多扩展。据相关资料介绍,DLCA模式,相比WebRTC在有些场景下,还可以降低1帧的延迟,将延迟进一步优化十几毫秒。
未来,随着WebTransport+WebCodecs的兼容性逐步完善,其可能成为WebRTC的补充方案,在特定高端场景中进一步提升传输与编解码效率;但就当前商用落地需求而言,经过场景优化优化的WebRTC仍是实时云渲染Web端目前主流厂商的主流选择。