机械制造企业官网被AI忽略,通常不是因为页面数量少,而是AI无法从现有内容中稳定判断“这家企业是谁、擅长解决什么问题、哪些能力有证据、适合哪类采购需求”。
传统机械制造官网经常按照企业内部视角组织内容:
公司介绍
→ 产品中心
→ 设备展示
→ 工厂照片
→ 新闻动态
→ 联系我们
但海外采购人员在ChatGPT、Gemini、Perplexity等生成式搜索场景中的问题,更接近:
Who can manufacture low-volume custom machine components?
What should I check before choosing
a precision machining supplier?
Can this supplier handle both machining
and final assembly?
How can I verify its tolerance capability?
Which manufacturer is suitable
for custom parts instead of standard components?
两套信息结构并不匹配。
本文基于一个匿名化机械制造网站整改案例,记录如何从品牌定位、能力模型、页面结构、证据关联到FAQ矩阵进行GEO改造。
案例中的企业名称和业务数据均经过脱敏,测试数据用于展示方法,不代表任何AI平台的官方评分或效果承诺。 
为什么官网有100多个页面,AI仍然不知道企业“是谁”?
因为企业介绍回答了“公司是什么”,但没有稳定定义“企业在采购链路中的角色”。
项目开始时,网站共有138个可索引HTML页面:
| 内容类型 | 数量 |
| 产品页 | 46 |
| 工艺能力页 | 12 |
| 行业页 | 9 |
| 技术文章 | 31 |
| 新闻页面 | 24 |
| FAQ | 6 |
| 质量与认证页 | 5 |
| 案例页 | 5 |
| 合计 | 138 |
网站首页的核心表达是:
Professional Machinery Manufacturer
High Quality
Advanced Equipment
Rich Experience
Customized Service
这些内容对人类访问者并非完全没有作用,但对于AI来说,存在一个明显问题:
“Machinery Manufacturer”到底指整机制造商、机械零件加工厂、OEM代工厂,还是能够承担非标项目设计与装配的定制供应商?
网站没有给出明确答案。
在改造前使用50个固定采购问题测试时,AI对企业角色的判断分布如下:
| AI识别角色 | 占比 |
| General machinery manufacturer | 46% |
| CNC machining supplier | 22% |
| Machine parts supplier | 18% |
| Custom manufacturing supplier | 8% |
| System/assembly supplier | 6% |
企业实际主要承接的是:
非标机械零部件
+ 机加工
+ 焊接
+ 表面处理
+ 零部件装配
+ 小批量项目
也就是说,AI识别出的企业角色与真实业务存在明显偏差。
“品牌定位”在GEO里到底是什么?
GEO中的品牌定位不是一句广告语,而是一组可以被机器稳定识别的实体属性。
传统营销定位可能写:
Professional One-Stop Machinery Solution Provider
但这句话仍然存在大量歧义。
项目中将企业定位拆成6个字段。
| 字段 | 示例 |
| Entity Type | Custom mechanical manufacturing supplier |
| Core Product | Custom mechanical components |
| Core Process | CNC machining, welding, finishing, assembly |
| Order Type | Prototype and low-volume production |
| Typical Buyer | Equipment manufacturers and engineering teams |
| Application | Automation, industrial equipment, energy machinery |
内部数据结构可以表示为:
{
  "company_role": "custom mechanical manufacturing supplier",
  "products": [
    "machined components",
    "welded assemblies",
    "custom mechanical parts"
  ],
  "capabilities": [
    "CNC machining",
    "welding",
    "surface finishing",
    "mechanical assembly"
  ],
  "production_modes": [
    "prototype",
    "low-volume production",
    "repeat batch"
  ],
  "target_customers": [
    "equipment manufacturers",
    "engineering companies",
    "industrial OEM buyers"
  ]
}
这样做的目的不是强行让AI接受某个品牌口号,而是减少“企业到底属于哪一类供应商”的歧义。
为什么只写“支持定制”还不够?
因为“支持定制”没有描述定制发生在哪一步。
项目原页面大量出现:
OEM available.
Customized according to drawings.
Custom service supported.
但海外采购真正需要确认的是:
客户提供什么?
供应商评估什么?
哪些工艺需要确认?
如何验证首件?
批量前检查什么?
发生设计变更怎么办?
因此,“定制能力”被拆成完整流程:
客户图纸
→ DFM/工艺评审
→ 材料确认
→ 工艺路线
→ 首件生产
→ 尺寸检测
→ 客户确认
→ 小批量
→ 重复订单
页面也由:
We support custom manufacturing.
改为:
Custom manufacturing projects are reviewed
based on drawings, material, critical tolerances,
surface requirements and expected order quantity.
The confirmed process route may include
machining, welding, finishing and assembly.
Critical dimensions are reviewed
before production and verified
according to the approved inspection plan.
区别在于,后者告诉AI:
“custom”是一套过程,而不是一个形容词。
首页定位不清会产生哪些连锁问题?
首页定位错误会传导到产品页、行业页、FAQ和Schema。
项目审计发现,同一家企业在不同页面中被描述成了4种角色:
| 页面 | 企业定位 |
| 首页 | Machinery Manufacturer |
| About | Precision Parts Manufacturer |
| 产品页 | OEM Parts Factory |
| 行业页 | Industrial Solution Provider |
这些名称并非完全矛盾,但没有明确上下级关系。
结果是AI可能分别建立多个模糊实体:
机械制造企业
精密零件厂
OEM工厂
工业解决方案供应商
却没有稳定合并成:
一家提供定制机械零部件制造、
焊接和装配的小批量工业供应商
因此,改造后的原则是:
一个主身份
+ 多个能力标签
+ 多个应用关系
而不是:
每个页面重新定义一次公司。
产品页应该怎样承接企业定位?
企业定位必须能够在具体产品页中得到验证,否则首页定位只是自我声明。
例如首页定义:
Custom mechanical manufacturing supplier
那么产品页至少需要证明:
- 产品不是只有固定SKU;
- 支持按图纸制造;
- 有材料和工艺选择;
- 有参数边界;
- 有检测方式;
- 有小批量或重复订单逻辑。
原来的产品页:
| 字段 | 内容 |
| Product | Custom Shaft |
| Material | Steel |
| Tolerance | ±0.01 mm |
| Surface | Customized |
| OEM | Yes |
改造后的页面增加:
| 信息层 | 示例 |
| 典型应用 | 自动化设备传动结构 |
| 材料条件 | 根据载荷、腐蚀、热处理要求确认 |
| 工艺 | CNC车削、铣削、磨削 |
| 公差作用域 | 指定关键尺寸,不代表全部尺寸 |
| 检测 | 外径、圆跳动、粗糙度 |
| 项目输入 | 2D/3D图纸、材料、关键公差、数量 |
| 限制 | 长轴、薄壁、热处理件需单独评审 |
页面由“参数展示”变成了“采购判断节点”。
为什么FAQ矩阵比零散FAQ更重要?
FAQ矩阵不是把20个问答放在页面底部,而是系统覆盖客户采购过程中的不同问题类型。
项目开始时只有6个FAQ:
Do you support OEM?
What is your MOQ?
What is your lead time?
Can you ship worldwide?
How can I get a quotation?
What payment terms do you accept?
其中4个属于交易问题,只有2个涉及技术判断。
但真实海外客户的问题远不止这些。
项目从历史询盘、销售补问和工程沟通中整理出72个问题,并归为8类。
| FAQ类型 | 问题数量 |
| 企业能力判断 | 8 |
| 材料选择 | 9 |
| 工艺选择 | 11 |
| 公差与质量 | 12 |
| 定制流程 | 9 |
| 订单与交付 | 8 |
| 供应商评估 | 8 |
| 售后与重复订单 | 7 |
| 总计 | 72 |
这才形成一个FAQ矩阵。 
企业能力类FAQ应该问什么?
企业能力FAQ应该帮助客户判断“这家供应商是否适合我的项目”。
例如:
这家工厂适合标准件还是非标项目?
页面应直接回答:
主要能力面向按图定制的机械零件和组件。
如果客户需要标准库存件,
应优先确认是否存在现成型号。
对于非标项目,
通常需要提供图纸、材料、
关键尺寸和预期数量进行工艺评审。
只有3D模型,没有2D图纸,可以报价吗?
回答应说明:
3D模型可以用于初步结构评估,
但关键公差、表面要求、材料、
热处理和检验要求通常不能仅靠3D模型完整表达。
正式生产前建议确认2D技术要求。
这里的价值在于主动暴露采购输入条件。
公差与质量类FAQ应该问什么?
这类问题最容易进入AI技术问答,也最容易产生错误概括。
例如:
±0.01 mm是否适用于所有零件?
直接结论应该放在第一句:
不适用。±0.01 mm必须结合尺寸、材料、结构和具体特征判断。
然后再解释:
影响因素包括:
零件尺寸;
长径比;
薄壁结构;
热处理;
装夹方式;
加工路线;
检测方式。
相比:
Our tolerance can reach ±0.01 mm.
前者更适合作为完整知识片段被AI引用。
供应商评估类FAQ应该问什么?
供应商评估FAQ应该回答买家真正用于筛选工厂的问题。
例如:
How do I verify a supplier's tolerance capability?
Does having a CMM mean every dimension is CMM inspected?
What should I check before sourcing custom machine parts?
How can I evaluate a small-batch machining supplier?
How should first article inspection be handled?
其中“有CMM是否代表全部尺寸都用CMM检测”就是一个典型的反误导问题。
合理答案应该说明:
不是。
CMM通常用于适合其测量范围和测量方式的关键几何尺寸。
普通尺寸也可能使用:
千分尺;
卡尺;
高度规;
量规;
粗糙度仪;
专用检具。
最终检测方式应由图纸要求和检验计划决定。
FAQ矩阵应该怎样与产品页连接?
FAQ不能成为孤立内容库,而应该连接产品、工艺和证据。
例如:
FAQ:
如何验证轴类零件的圆跳动?
↓
产品:
Custom Shaft
↓
工艺:
Turning + Grinding
↓
检测:
Runout Inspection
↓
证据:
匿名检测记录
对应知识结构为:
flowchart LR
    A[采购问题] --> B[产品]
    B --> C[工艺]
    B --> D[参数]
    D --> E[检测]
    E --> F[证据]
AI得到的不再只是一个FAQ回答,而是一条完整关系链。
如何用代码检查FAQ矩阵有没有明显空白?
可以把采购问题分类后计算覆盖率,而不是凭感觉判断FAQ是否“够多”。
下面是一个简化Python示例:
faq_matrix = {
    "supplier_capability": {
        "required": 8,
        "published": 7
    },
    "material_selection": {
        "required": 9,
        "published": 5
    },
    "process_selection": {
        "required": 11,
        "published": 8
    },
    "tolerance_quality": {
        "required": 12,
        "published": 11
    },
    "custom_process": {
        "required": 9,
        "published": 6
    },
    "delivery": {
        "required": 8,
        "published": 8
    },
    "supplier_evaluation": {
        "required": 8,
        "published": 4
    },
    "after_sales": {
        "required": 7,
        "published": 3
    }
}
def calculate_coverage(matrix):
    result = {}
    total_required = 0
    total_published = 0
    for category, data in matrix.items():
        required = data["required"]
        published = data["published"]
        coverage = min(
            published / required * 100,
            100
        )
        result[category] = round(coverage, 1)
        total_required += required
        total_published += min(
            published,
            required
        )
    result["total"] = round(
        total_published / total_required * 100,
        1
    )
    return result
print(calculate_coverage(faq_matrix))
输出示例:
{
  "supplier_capability": 87.5,
  "material_selection": 55.6,
  "process_selection": 72.7,
  "tolerance_quality": 91.7,
  "custom_process": 66.7,
  "delivery": 100.0,
  "supplier_evaluation": 50.0,
  "after_sales": 42.9,
  "total": 72.2
}
这段代码不能判断FAQ内容质量,但能够快速暴露:
当前网站最缺的是“售后”和“供应商评估”问题,而不是继续增加交期问答。
FAQ应该全部放在一个页面吗?
不建议。核心FAQ应该根据问题语义分布到最相关页面,同时保留聚合入口。
例如:
| FAQ | 最合适页面 |
| ±0.01 mm适用于全部尺寸吗 | 公差能力页 |
| 304和316L怎么选 | 材料页 |
| 小批量是否适合CNC加工 | 工艺页 |
| 报价需要什么资料 | 定制流程页 |
| 如何验证供应商 | 采购指南 |
| 哪些尺寸使用CMM | 质量页 |
同时可以建立:
/faq/
作为问题聚合入口。
这样既方便用户浏览,也避免所有知识都堆积在一个超长FAQ页面中。
FAQPage Schema应该怎么用?
结构化数据必须与用户实际可见的问答一致。
例如:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "Does a ±0.01 mm tolerance apply to every dimension?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "No. Tolerance feasibility depends on the specific feature, material, part size, geometry, process route and inspection method. Critical tolerances should be reviewed from the drawing before production."
      }
    },
    {
      "@type": "Question",
      "name": "What information is required for a custom machining quotation?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "A preliminary review normally requires a 2D or 3D drawing, material requirement, critical tolerances, surface or heat-treatment requirements and expected order quantity."
      }
    }
  ]
}
</script>
不要在Schema中添加页面正文没有出现的问题,也不要为了结构化数据自行增加企业能力。
FAQ矩阵为什么还需要证据?
FAQ回答如果只有观点,没有证据,仍然容易停留在企业自述层面。
例如:
如何验证供应商的尺寸检测能力?
可以进一步关联:
检测设备页面
+
测量范围
+
检测流程
+
脱敏报告样例
+
匿名案例
形成:
问题
→ 方法
→ 设备
→ 记录
→ 案例
这与简单回答:
“我们有严格的质量体系。”
相比,信息密度和可验证性完全不同。
品牌定位与FAQ矩阵之间是什么关系?
品牌定位定义“企业擅长回答什么问题”,FAQ矩阵负责把这些能力展开成具体答案。
例如企业希望被准确识别为:
Custom mechanical manufacturing supplier
for low-volume industrial components
那么FAQ就应该重点覆盖:
小批量制造;
按图定制;
材料选择;
精度评估;
工艺路线;
首件确认;
重复订单;
装配;
供应商验证。
如果FAQ反而大量讨论:
公司成立多少年;
是否参加展会;
办公室在哪里;
是否支持Paypal;
这些问题并不能强化核心实体角色。
改造前后应该比较哪些指标?
GEO复盘应该同时看“身份、问题、证据和错误率”,而不是只看AI是否出现品牌。
项目采用56个固定问题进行前后测试。
脱敏结果如下:
| 指标 | 改造前 | 改造后 |
| 正确识别核心企业角色 | 32% | 79% |
| 正确识别定制能力 | 28% | 76% |
| FAQ问题覆盖率 | 19% | 81% |
| 参数条件保留率 | 24% | 72% |
| 检测证据定位率 | 16% | 61% |
| 错误理解为标准件供应商 | 11次 | 3次 |
| 将极限公差视为默认能力 | 9次 | 2次 |
这里的测试结果仅用于内部前后比较。
最值得关注的是:
品牌角色变得稳定;
问题覆盖更加完整;
错误扩张能力减少。
而不是单纯追求品牌被提及次数。 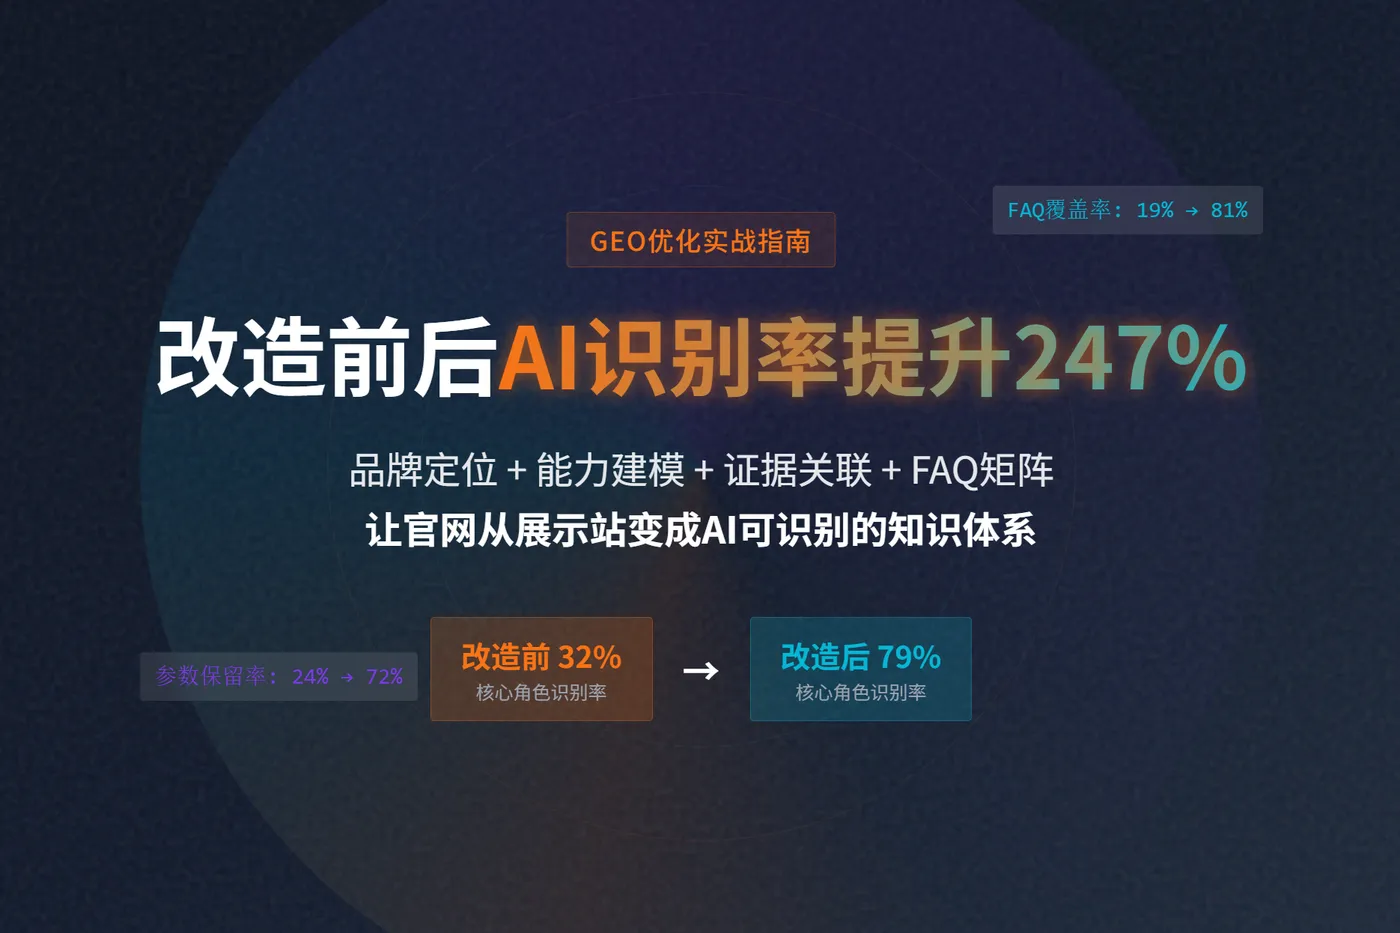
哪些页面应该最先改?
应该优先修改能够定义企业身份和连接最多知识节点的页面。
在资源有限时,可以按以下优先级:
| 优先级 | 页面 |
| P0 | 首页 |
| P0 | About/企业能力页 |
| P0 | 5~10个核心产品页 |
| P0 | 质量与检测页 |
| P1 | 定制流程页 |
| P1 | 核心工艺页 |
| P1 | 典型应用页 |
| P1 | 案例页 |
| P2 | FAQ矩阵 |
| P2 | 技术文章 |
| P3 | 公司新闻 |
首页负责定义企业是谁。
核心产品页证明企业做什么。
工艺和质量页解释怎么做。
案例和证据证明做过。
FAQ负责覆盖用户怎么问。
这几部分比单纯增加新闻数量更接近AI理解企业所需的信息结构。
这次改造最值得复用的经验是什么?
最值得复用的经验,是把官网从“企业想介绍什么”改造成“采购人员会问什么、企业如何用事实回答”。
改造前:
企业介绍
→ 产品展示
→ 优势
→ 联系方式
改造后:
企业角色
→ 核心能力
→ 产品对象
→ 适用场景
→ 参数边界
→ 检测证据
→ FAQ问题
完整实施路径可以概括为:
品牌角色诊断
→ 企业实体统一
→ 核心能力建模
→ 产品页面修复
→ 证据关联
→ 历史问题整理
→ FAQ矩阵建设
→ Schema同步
→ AI固定问题复测
机械制造企业官网被AI忽略,很多时候不是因为AI“看不到页面”,而是页面无法支持它回答:
这家企业到底适合什么采购任务?
当企业定位、产品能力、质量证据和FAQ能够相互验证后,官网才开始从传统的企业展示站,转变成更适合生成式搜索读取的制造知识体系。
外贸GEO还有哪些常见问题?
GEO中的品牌定位和传统品牌文案有什么区别?
GEO更强调可以验证的实体属性。
例如:
“全球领先机械专家”
很难被验证。
而:
“提供CNC加工、焊接和装配的小批量定制机械零部件供应商”
至少包含:
产品
+ 工艺
+ 订单类型
+ 服务角色
更适合作为机器可理解的企业定义。
企业可以同时有多个定位吗?
可以有多个能力标签,但最好有一个稳定主身份。
例如:
主身份:
Custom mechanical manufacturing supplier
能力标签:
CNC machining
Welding
Assembly
Prototype production
比每个页面重新定义企业更容易保持一致。
FAQ矩阵应该从哪里获取问题?
优先级建议是:
历史询盘
→ 销售补问
→ 工程评审
→ 售后问题
→ 搜索问题
→ AI模拟问题
真实客户问题应优先于批量关键词生成。
FAQ是不是越多越好?
不是。
FAQ需要同时满足:
真实有人问;
企业有事实回答;
回答有条件;
必要时有证据;
与其他页面不冲突。
50条重复FAQ未必比20条高质量问题更有效。
一篇FAQ应该写多长?
没有固定字数。
简单定义问题可能100~200字即可。
涉及公差、选型、材料或质量验证的问题,可能需要300~800字,并配表格或案例。
关键不是长度,而是能否完整回答问题。
FAQ能代替技术文章吗?
不能。
FAQ适合解决一个明确问题。
技术文章更适合解释:
为什么;
如何比较;
如何实施;
常见错误;
完整方法。
两者可以互相链接。
企业没有大量案例,FAQ还能做吗?
可以。
FAQ可以基于真实工艺事实、质量流程、公开参数和工程规则建设。
但不能为了丰富内容虚构项目数据。
没有证据时,应明确写:
需要结合具体图纸评审。
而不是给出未经确认的结论。
如何避免AI把极限能力理解成常规能力?
需要明确区分:
常规能力
条件能力
案例能力
极限能力
例如:
常规关键尺寸:±0.02 mm
特定尺寸经工程评审:
可进一步评估±0.01 mm
比只写:
Precision up to ±0.01 mm
更加准确。
Schema是不是做了就会提高AI曝光?
不能这样理解。
Schema只能辅助机器读取实体和属性。
如果正文中的:
定位
产品
参数
FAQ
证据
本身不完整,Schema不能代替这些内容。
如何判断FAQ矩阵已经比较完善?
至少应该覆盖采购链路中的主要阶段:
认识企业
→ 判断能力
→ 产品选型
→ 工艺确认
→ 质量验证
→ 报价准备
→ 交付
→ 售后
如果70%的FAQ都集中在“报价和交期”,说明矩阵仍然严重偏科。
为什么GEO项目一定要保留固定测试问题?
因为没有固定测试集,就无法进行真正的前后比较。
建议为核心业务建立30~100个长期测试问题,并记录:
平台
日期
问题
品牌是否出现
角色是否正确
参数是否准确
条件是否保留
是否找到证据
测试问题可以逐步扩展,但至少保留一批固定基准题。
机械制造企业最容易忽视哪类FAQ?
通常是“供应商评估型问题”。
企业喜欢回答:
我们能不能做?
但买家还会问:
我怎么判断你真的能做?
因此值得建设:
如何验证公差能力?
如何查看材料追溯?
首件怎么确认?
检测报告怎么看?
设备数量是否等于产能?
样件合格是否代表批量稳定?
这些问题既有技术价值,也更接近真实B2B采购决策。
GEO改造最应该避免什么?
最应该避免的是:
首页重新写一遍定位,产品页和FAQ仍然沿用旧逻辑。
真正有效的改造应该保持:
品牌定位
= 产品事实
= 工艺能力
= 质量证据
= 案例
= FAQ回答
在核心事实层面一致。
只有这些页面相互支持时,AI才能更稳定地形成一张完整的企业认知图。