
大模型行业已经完成从纯文本问答向多模态感知,再到智能体自主执行任务的演进。过去多数多模态模型仅仅可以完成图文问答,输入图片返回描述文字,只能做到“看懂信息”,却无法进一步处理信息、完成复杂业务流程。通义千问Qwen3.7‑Plus以多模态交互混合智能体作为产品核心定位,将视觉感知、逻辑推理、代码生成、工具调用、结果验证融为一体,构建“看、想、写、做、验”完整任务闭环,不只是被动应答问题,更能够自主拆解目标、执行操作并且校验输出结果。
作为Qwen3.7产品序列当中均衡向主力模型,它保留接近旗舰版本的文本、编程推理实力,同时完成视觉‑语言融合能力的跨越式升级。凭借合理的调用成本,可以覆盖绝大多数个人开发者、中小企业的高频业务需求,是具备很高工程落地价值的多模态大模型。本文将拆解它的技术底座、完整能力矩阵,梳理各类业务适用场景,同时提供可直接运行的API调用代码,帮助开发者快速完成集成。详情👉访问阿里云百炼大模型服务平台页面 了解。
一、核心定位与技术底座:统一多模态智能体基座
Qwen3.7‑Plus并非简单给文本模型叠加图像输入模块,而是打造一套视觉语言一体化的智能体基座,支持GUI图形界面、CLI命令行、工具函数三类环境下执行复杂任务,打通感知到交付结果的全链路。它基于Qwen3.7成熟的文本主干网络,搭配升级后的Qwen3‑VL视觉技术栈,实现三项关键技术突破。
第一,实现视觉‑语言深度对齐。区别传统OCR工具只做文字提取,模型可以同时完成空间位置感知、画面语义理解、图像编码,能够分辨UI界面控件排布、图表内部逻辑、复杂文档版式,甚至解析动态视频帧当中的动作与信息,把画面当中的空间关系、数据关系转化为逻辑推理依据。
第二,落地完整智能体闭环架构。遵循“感知‑推理‑规划‑执行‑验证”的工作流。拿到用户需求之后,先感知输入内容,再推理拆解子任务,规划执行步骤,调用代码、工具或者生成操作指令,执行结束之后自主校验结果,如果存在错误还会迭代修正,减少人工介入,完成端到端交付。公开测试案例中,该模型曾经连续十一个小时不间断自治运行,独立完成一款英语单词学习App的全部研发工作,产出上万行业务代码,覆盖需求梳理、编码、测试迭代全流程。
第三,做到全栈能力均衡输出。数学推理、长文本处理、代码生成的能力接近旗舰级别,视觉理解能力相比前代版本提升幅度显著,在同成本档位中,属于少数同时具备完整视觉智能体执行能力的模型。模型支持百万级token超长上下文窗口,能够加载完整代码仓库、整本长篇文档,同时兼容图片、多帧视频作为输入,适配复杂的真实业务输入条件。
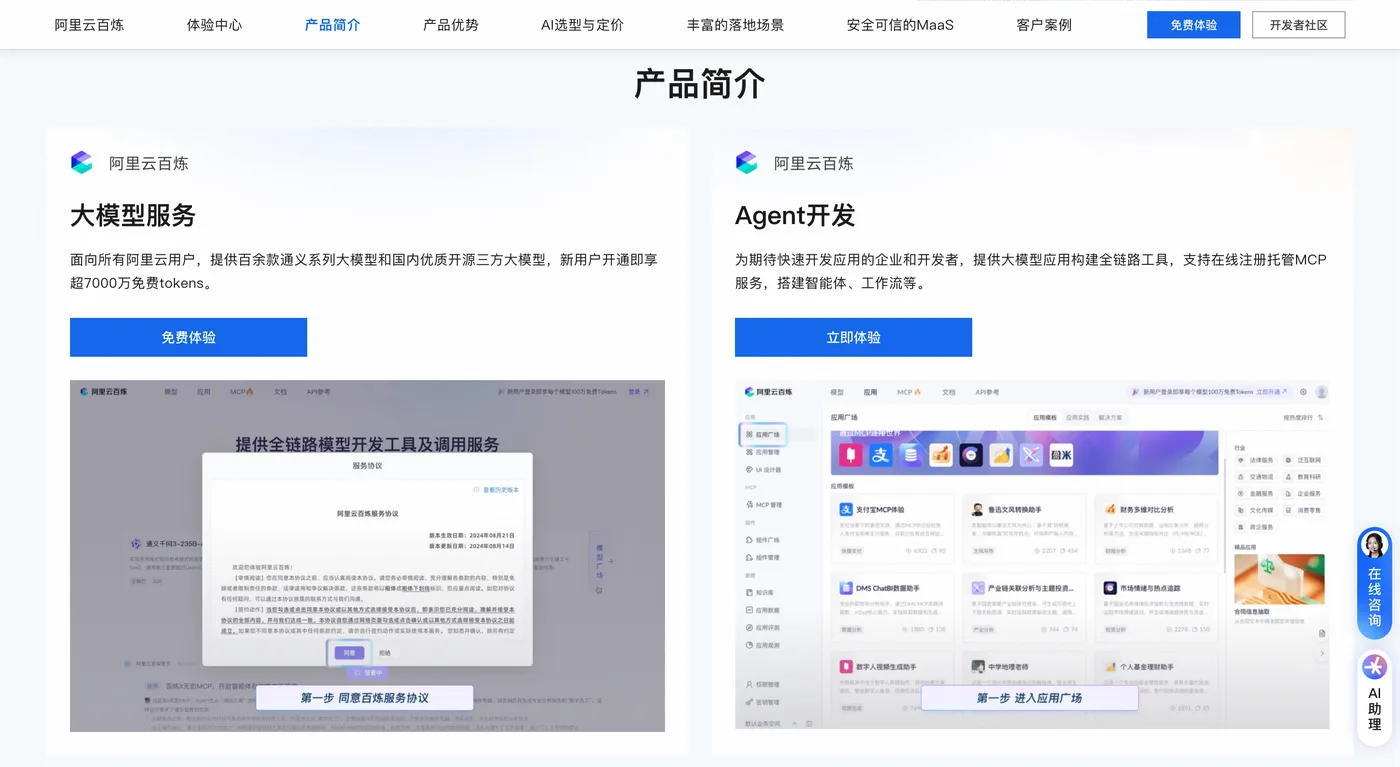
开发者可以在阿里云百炼大模型服务平台获取模型服务,平台同时配套知识库RAG、Agent开发、Token订阅套餐,降低模型应用落地门槛。
二、核心能力矩阵:感知、推理、编程、智能体执行全链路
2.1 多模态感知理解:面向真实世界的视觉能力
视觉能力是Qwen3.7‑Plus差异化的关键,在多项公开评测数据集当中取得不错成绩。BabyVision纯视觉推理评测得分64.7,对比上代提升73%;屏幕界面理解评测得分79;中文OCR识别理解得分67.1。视觉能力覆盖界面解析、文档图表处理、动态视频分析三大方向。详情👉访问阿里云百炼大模型服务平台页面 了解。
界面与场景理解:识别桌面软件、移动App、网页截图,分辨按钮、输入框、菜单、弹窗等UI元素,理解页面交互逻辑。只需要一张操作截图,模型就可以分析现有界面,输出对应的操作步骤指令,为自动化GUI智能体打下基础。
文档与图表解析:处理PDF文件、扫描件、合同文书、财报报表、工程图纸。不再局限提取文字,同时解析表格结构、图表数据、排版版式,做到图文联合推理。可以直接从财报截图提取结构化数据,完成统计、计算、总结,省去传统项目中OCR解析、文本二次处理的繁琐流程。
动态视觉分析:解析视频片段、录屏内容,提取关键时间节点、人物动作、核心业务信息,对视频内容做结构化总结。适合会议录屏、教学视频、业务操作录像的信息提取场景。
2.2 文本与逻辑推理:高性能通用理解底座
虽然主打多模态,但是文本能力没有妥协,数学、知识问答、超长文本、内容创作能力都保持很高水准。
数学与逻辑推理:Apex数学评测指标对比上代提升接近三倍,能够处理复杂应用题、逻辑证明、工程计算,输出完整推导步骤,不只是给出最终答案。
知识问答:搜索增强问答能力较上代提升两倍以上,处理开放性问题、垂直行业专业查询,提升答案准确性,减少幻觉问题。
长文本处理:百万token上下文窗口,一次性加载长篇合同、整套源代码、上万轮历史对话,在大篇幅内容中精准定位信息,完成摘要、改写、分析。
内容创作:支持报告撰写、文案、故事、多语种翻译润色,支持多种输出格式,满足个人内容产出以及企业业务文档生成。
2.3 编程开发能力:从需求、截图到可运行代码
编程能力经过深度调优,Terminal Bench 2.0、SciCode等编程评测数据集分数相比上代提升明显,足以应对绝大多数工程开发工作。
代码生成与调试:支持Python、Java、JavaScript、Go、C++等主流语言,生成完整项目模块、业务函数,自动定位并且修复程序缺陷,测试用例中对真实工程Bug修复表现优秀。
视觉编程能力:输入UI设计稿、页面截图,直接输出HTML/CSS/JS前端代码、小程序代码,识别页面尺寸、组件样式、交互逻辑,实现“看图产出代码”,大幅缩短原型开发周期。
工程化开发:理解项目目录结构、第三方依赖、开发规范,输出项目脚手架、配置文件、部署脚本,适配前后端分离、微服务等复杂工程架构。
代码解析优化:阅读晦涩源码,生成注释与技术文档,优化运行性能,修复安全隐患,帮助维护存量项目。
2.4 智能体执行与工具调用:从理解走向实际行动
智能体执行是模型最重要的突破,实现从“回答问题”升级为“完成任务”。提供Function Calling函数调用、内置工具、自主环境操作三类模式,打通GUI界面和CLI命令行两套操作环境。
完整端到端任务闭环,严格遵循“看‑想‑写‑做‑验”循环。比如拿到一张应用登录截图,识别页面控件,规划填写账号密码、点击登录按钮的操作;拿到软件开发需求,自主规划模块,编写代码,运行测试,发现问题再迭代修改。
丰富工具调用生态,内置联网搜索、代码解释器、文档解析、数学计算工具,同时支持接入开发者自定义业务工具。模型会根据用户的问题,自主判断是否调用工具,选择合适工具获取信息,整合工具返回结果,生成最终回复。
跨环境兼容,既可以理解图形界面完成模拟操作,也可以输出CLI命令执行服务器任务,桌面端、移动端、云端环境都可以适配,给Agent开发提供更大的发挥空间。
三、API接入实战:兼容OpenAI规范多语言调用
Qwen3.7‑Plus部署在阿里云百炼平台,API接口兼容OpenAI调用规范,Python、Node.js、Java都可以快速接入。下面给出完整实操步骤以及可直接运行的代码片段。
3.1 前期准备工作
- 登录阿里云百炼平台,创建应用,获取
DASHSCOPE_API_KEY密钥。生产环境不建议硬编码密钥,优先使用环境变量管理密钥。 - 安装依赖包
pip install openai python-dotenv - 在项目目录新建
.env环境变量配置文件DASHSCOPE_API_KEY=你的API密钥 BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
3.2 基础文本对话调用示例
import os
from openai import OpenAI
from dotenv import load_dotenv

# 读取环境变量
load_dotenv()
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url=os.getenv("BASE_URL")
)

response = client.chat.completions.create(
    model="qwen3.7-plus",
    messages=[
        {
   "role": "system", "content": "你是专业技术助手,回答简洁严谨。"},
        {
   "role": "user", "content": "解释什么是多模态智能体"}
    ],
    temperature=0.7,
    max_tokens=1000
)

print("Qwen3.7‑Plus回复:", response.choices[0].message.content)
3.3 多模态图文混合调用,解析截图界面
import os
import base64
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url=os.getenv("BASE_URL")
)

# 将本地图片编码为base64字符串
def encode_image(image_path):
    with open(image_path, "rb") as f:
        return base64.b64encode(f.read()).decode("utf‑8")

img_path = "ui_screenshot.png"
base64_img = encode_image(img_path)

resp = client.chat.completions.create(
    model="qwen3.7‑plus",
    messages=[
        {

            "role": "user",
            "content": [
                {
   "type": "text", "text": "这是APP登录界面截图,请分析界面元素,输出完整登录操作步骤。"},
                {
   "type": "image_url", "image_url": {
   "url": f"data:image/png;base64,{base64_img}"}}
            ]
        }
    ],
    max_tokens=1500
)

print("界面分析结果:", resp.choices[0].message.content)
3.4 启用代码解释器,执行复杂数学计算
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url=os.getenv("BASE_URL")
)

res = client.chat.completions.create(
    model="qwen3.7‑plus",
    messages=[{
   "role": "user", "content": "计算123的21次方,输出详细计算过程"}],
    extra_body={

        "enable_code_interpreter": True,
        "enable_thinking": True
    },
    stream=True
)

for chunk in res:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
3.5 Function Calling工具调用完整示例
import os
import json
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url=os.getenv("BASE_URL")
)

# 定义工具描述
tools = [
    {

        "type": "function",
        "function": {

            "name": "get_weather",
            "description": "查询指定城市天气情况",
            "parameters": {

                "type": "object",
                "properties": {

                    "city": {
   "type": "string", "description": "城市名称"}
                },
                "required": ["city"]
            }
        }
    }
]

# 第一步:模型判断是否调用工具
resp1 = client.chat.completions.create(
    model="qwen3.7‑plus",
    messages=[{
   "role": "user", "content": "北京今天天气怎么样"}],
    tools=tools,
    tool_choice="auto"
)

tool_call = resp1.choices[0].message.tool_calls[0]

# 模拟工具函数实现
def get_weather(city):
    return f"{city}今日晴天,气温25℃"

# 解析参数执行工具
args = json.loads(tool_call.function.arguments)
tool_result = get_weather(args["city"])

# 第二步:把工具返回结果交还给模型生成最终回答
resp2 = client.chat.completions.create(
    model="qwen3.7‑plus",
    messages=[
        {
   "role": "user", "content": "北京今天天气怎么样"},
        {
   "role": "assistant", "content": None, "tool_calls": [tool_call]},
        {
   "role": "tool", "tool_call_id": tool_call.id, "content": tool_result}
    ]
)

print("最终回答:", resp2.choices[0].message.content)
开发注意事项:正式业务环境,密钥禁止写死在源码中,优先使用环境变量、密钥管理服务保存API Key,避免密钥泄露带来安全风险。
四、业务适用场景:覆盖个人与企业大量高频需求
依托均衡的多模态与智能体能力,Qwen3.7‑Plus可以落地到很多实际业务当中,覆盖办公、开发、文档处理、教育、企业服务多个领域。
智能办公自动化:处理邮件批量摘要、表格数据分析、合同审阅、业务报告自动生成。对扫描版合同、报表截图直接提取结构化信息,减少人工录入,显著提升办公效率。
UI/UX与软件开发:根据设计稿、界面截图产出前端代码,定位界面交互缺陷,优化交互方案。也可以承担完整应用的原型开发,降低产品前期研发成本。
移动应用与低代码开发:接收产品需求,完成需求拆解、界面规划、代码生成、简单测试的闭环,助力低代码平台,实现业务快速搭建。
文档处理和企业知识库:解析PDF、扫描件、工程图纸,抽取结构化数据,对接RAG知识库,实现图文混合资料的智能检索问答,处理企业内部大量非标准化文档。
教育学习辅助:学科答疑、习题解析、知识点总结、编程教学。支持图文类习题输入,识别试卷截图完成解题讲解,适配从基础教育到职业技能培训。
多模态智能客服:可以接收用户截图、照片、文字咨询,理解图文混合的问题,自动生成工单,输出解决方案,提升客服处理复杂问题的能力。
五、产品核心竞争优势
对比同价位其他模型,Qwen3.7‑Plus有三项突出优势。
第一是高性价比。它在同档位产品中,完整具备视觉智能体执行能力,调用成本大约仅为旗舰大模型的三分之一,绝大多数普通业务场景都可以胜任,适合企业大规模API调用落地,不用承担高昂推理开销。
第二是能力均衡无明显短板。文本推理、视觉理解、代码编程、Agent工具调用四大模块全部拥有不错表现,不会出现某一项能力很强、另一项严重不足的情况,能够应对多样化混合业务,不用为不同任务切换多款模型。
第三是生态友好、迁移成本低。兼容OpenAI标准API,已经在用同类接口的项目改动少量代码即可完成迁移;同时配套百炼平台的工具、知识库、Agent开发套件,开发者可以快速搭建业务原型。
需要区分Qwen3.7‑Plus和同系列Max版本定位:Max版本偏向极致深度逻辑推理,适合复杂行业研报、高难度算法推演;Plus主打多模态与智能体执行,适合看图、编程、工具调用、自动化工作流场景,开发者按照业务侧重点选型。
六、总结展望
Qwen3.7‑Plus代表大模型从问答工具向多模态智能体基座的转变。不再局限接收指令返回文字,而是把视觉感知、逻辑规划、代码执行、工具调用、结果校验串联起来,完成完整任务闭环。百万级上下文、强大视觉编码、完整Function Calling,再加上友好的调用成本,既适合个人开发者做原型验证,也适合企业落地规模化AI业务。
随着后续迭代,模型视觉解析精度、长周期智能体自治稳定性、工具生态还会持续完善。多模态智能体将会成为很多数字化业务的底层能力,而Qwen3.7‑Plus就是面向这一趋势,兼顾实用性和成本的重要选择。开发者可以先通过百炼平台完成小规模业务测试,验证业务效果,再推进正式生产环境接入。
