前言
本文讲解:单链表的排序、求单链表的最大值、二维数组按行存入一维数组(如何输出三角形? ---> 传送门)

一、程序填空📝 --- 单链表的排序
难度:⭐⭐
题目📃
在这个程序里,函数 fun 的功能是对带头结点的单向链表结点数据域中的数据进行从小到大排序。
比如原链表结点数据域从头到尾的数据是 10、4、2、8、6 ,排序后链表结点数据域从头到尾的数据就变为 2、4、6、8、10。
请在程序的下画线处填入正确内容,并删除下画线,让程序能得出正确结果。
代码如下:
在1️⃣2️⃣3️⃣处填空
#include  <stdio.h>
#include  <stdlib.h>
#define    N    6
typedef struct node {
  int  data;
  struct node  *next;
} NODE;
void fun(NODE  *h)
{ NODE  *p, *q;    int  t;
/**********found**********/
  p = 1️⃣;
  while (p) {
/**********found**********/
      q = 2️⃣ ;
     while (q) {
/**********found**********/
        if (p->data 3️⃣ q->data)
        {  t = p->data;  p->data = q->data;  q->data = t;  }
        q = q->next;
    }
    p = p->next;
  }
}
NODE *creatlist(int  a[])
{  NODE  *h,*p,*q;        int  i;
  h = (NODE *)malloc(sizeof(NODE));
  h->next = NULL;
  for(i=0; i<N; i++)
  {  q=(NODE *)malloc(sizeof(NODE));
     q->data=a[i];
     q->next = NULL;
     if (h->next == NULL)  h->next = p = q;
     else    {  p->next = q;  p = q;   }
  }
   return  h;
}
void outlist(NODE  *h)
{ NODE  *p;
  p = h->next;
  if (p==NULL)  printf("The list is NULL!\n");
  else
  {  printf("\nHead  ");
     do
     {  printf("->%d", p->data); p=p->next;  }
     while(p!=NULL);
     printf("->End\n");
  }
}
void main()
{  NODE  *head;
   int  a[N]= {0, 10, 4, 2, 8, 6 };
   head=creatlist(a);
   printf("\nThe original list:\n");
   outlist(head);
   fun(head);
   printf("\nThe list after sorting :\n");
   outlist(head);
}
分析🧐
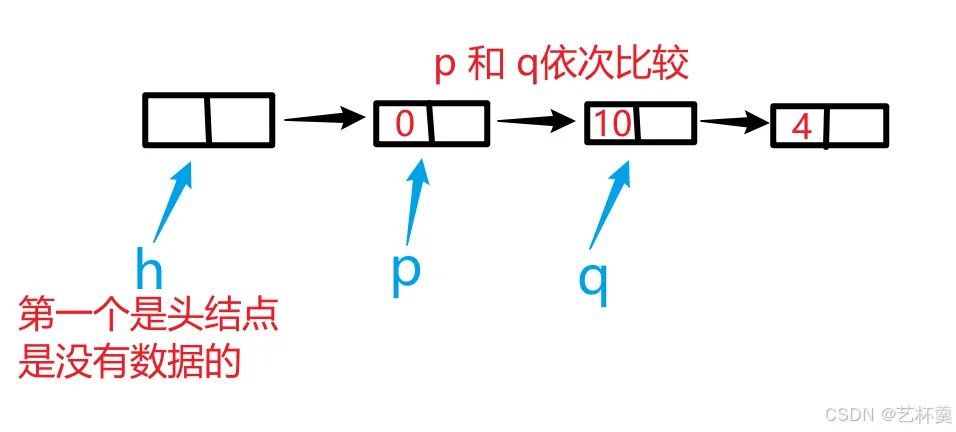
碰到这个单向链表题,可以直接根据题目到fun函数中,去填空
- 填写h -> next;
因为是带头节点的链表
所以要跳过头节点 - 填写 p -> next
因为从下方的循环,可以知道这里是比较前后两个数的大小
p 是当前的值,要和下一个进行比较,所以就是当前 p 的下一个 - 填写 >
根据题意是从小到大排序
当前值比后一个值要大,就交换
这样大的值就跑到后面去了
解答代码如下:
void fun(NODE  *h)
{ NODE  *p, *q;    int  t;
/**********found**********/
  //因为是带头节点的,第一个节点没有数据
  //所以跳过
  p = 1️⃣h -> next;
  while (p) {
/**********found**********/
      //因为要两个相邻的数比较
      //所以就是他的下一个
      q = 2️⃣p -> next ;
     while (q) {
/**********found**********/
        if (p->data 3️⃣> q->data)
        {  t = p->data;  p->data = q->data;  q->data = t;  }
        q = q->next;
    }
    p = p->next;
  }
}
二、程序修改🛠️ --- 求单链表的最大值
难度:⭐
题目📃
在此程序中,建立一个带头结点的单向链表,并用随机函数为各结点数据域赋值。函数 fun 的作用是求出单向链表结点 (不包括头结点) 数据域中的最大值,并且作为函数值返回。
请改正函数 fun 中的错误,使它能得出正确的结果。
代码如下:
在代码中找出2个错误并修改
#include <stdio.h>
#include <conio.h>
#include <stdlib.h>
typedef struct aa
{ int data;
  struct aa *next;
} NODE;
int fun (NODE *h)
{ int max=-1;
  NODE *p;
/*************found**************/
  p=h;
  while(p)
       { if(p->data>max)
             max=p->data;
/*************found**************/
          p=h->next;
       }
  return max;
}
void outresult(int s, FILE *pf)
{ fprintf(pf, "\nThe max in link :%d\n",s);
}
NODE *creatlink(int n, int m)
{ NODE *h,*p,*s;
  int i;
  h=p=(NODE *)malloc(sizeof(NODE));
  h->data=9999;
  for(i=1;i<=n;i++)
    { s=(NODE *) malloc(sizeof(NODE));
      s->data=rand()%m; s->next=p->next;
      p->next=s;  p=p->next;
    }
  p->next=NULL;
  return h;
}
void outlink(NODE *h,FILE *pf)
{ NODE  *p;
  p=h->next;
  fprintf(pf, "\n The LIST :\n\n HEAD");
  while(p)
    { fprintf(pf, "->%d",p->data);
  p=p->next;}
  fprintf(pf, "\n");
}
void main()
{ NODE *head; int m;
  system("CLS");
  head=creatlink(12,100);
  outlink(head,stdout);
  m=fun(head);
  printf("\nThe RESULT :\n");
  outresult(m,stdout);
}
分析🧐
这也是一个单向链表的,所以只在main函数中看下对应fun函数传递的值,然后直接看fun函数即可
- 第12行改成
p = h ->next;
因为题目给出的是带头结点
所以要跳过这个没有数据的头结点 - 第17行改成
p = p->next;
因为这是每次p自身移动
而不是用不动的h
解答代码如下:
int fun (NODE *h)
{ int max=-1;
  NODE *p;
/*************found**************/
  1️⃣p=h ->next;
  while(p)
       { if(p->data>max)
             max=p->data;
/*************found**************/
         2️⃣p=p->next;
       }
  return max;
}
三、程序设计💻 --- 二维数组按行存入一维数组
难度:⭐
题目📃
在此程序中,编写函数 fun,该函数的功能:
将 M 行 N 列的二维数组中的数据,按行的顺序依次放到一维数组中,一维数组中数据的个数存放在形参 n 所指的存储单元中。
例如,若二维数组中的数据为:
33 33 33 33
44 44 44 44
55 55 55 55
则一维数组中的内容应该是:33 33 33 33 44 44 44 44 55 55 55 55
代码如下:
在fun函数中编写
#include <stdio.h>
void  fun(int  (*s)[10], int  *b, int  *n, int mm, int nn)
{
}
void main()
{ int w[10][10] = {{33,33,33,33},{44,44,44,44},{55,55,55,55}},i,j ;
  int a[100] = {0}, n = 0 ;void NONO ();
  printf("The matrix:\n") ;
  for(i = 0 ; i < 3 ; i++)
  { for(j = 0 ; j < 4 ; j++) printf("%3d",w[i][j]) ;
    printf("\n") ;
  }
  fun(w, a, &n, 3, 4) ;
  printf("The A array:\n") ;
  for(i = 0 ; i < n ; i++) printf("%3d",a[i]);printf("\n\n") ;
  NONO() ;
}
分析🧐
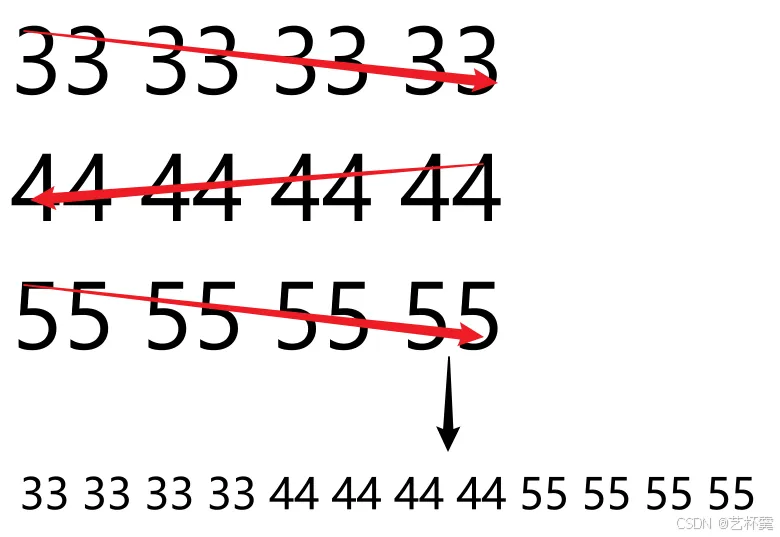
按行的顺序依次放到一维数组,那么就相当于是
从左往右依次将数据存储在另一个一维数组中
这道题还是挺简单的,就是要看到形参的作用
解答代码如下:
void  fun(int  (*s)[10], int  *b, int  *n, int mm, int nn)
{
    int i, j, flag = 0;
    //控制行
    for(i = 0; i < mm; i++)
    {
        //控制列
        for(j = 0; j < nn; j++)
        {
            //存入对应的数组
            b[flag++] = s[i][j];
        }
    }
    // flag刚好就是这个数组里数据的个数
    // 存入n指针,对应main函数的值,也会随之改变
    *n = flag;
}
最重要的是会画图,根据题目画出图来,就能很快的看出来怎么写了
希望本文对您有所帮助(* ̄︶ ̄)