
一个看似省事的做法
企业接入大模型时,最常见的起点还是这样的:
开发者找运维 / 管理员申请一个模型 API Key
(阿里云百炼 / DeepSeek / 智谱 GLM / OpenAI / Claude……)
把 Key 写进 .env 或配置中心
业务代码里直接用这个 Key 调用模型
对于一个 Demo 或者单人小项目,这样做完全没问题——简单、直接、几分钟就能跑通。
但当这种做法被复制到十几个业务系统、几十名开发者手里时,问题会成倍放大。很多企业的 AI 基础设施,最早的裂缝往往不是出在模型选型或 Prompt 工程上,而是出在这个最不起眼的环节:API Key 是怎么分发出去的。
直接下发 Key,问题出在哪?
1. Key 一旦泄露,可能产生直接经济损失
供应商签发的 API Key 通常直接绑定到企业的计费账户,这类 Key 最容易在这些地方泄露:
- 硬编码进代码,随手
git push到了仓库(哪怕是私有仓库,历史记录也很难彻底清理); - 打包进前端 / 移动端产物,被人反编译提取;
- 打印进日志、异常堆栈、监控系统;
- 员工电脑丢失、离职后配置未回收。
一旦泄露,攻击者拿到的往往不是"某个业务的调用权限",而是"整个企业账户的调用权限"——它可以用你的账单,跑别人的任务,而且这种盗用往往和正常业务流量混在一起,很难被及时发现,直到账单爆炸或者被供应商风控冻结。
2. 谁在用,用来做什么,用了多少,说不清楚
Key 一旦被硬编码进业务代码,调用记录就散落在各个系统自己的日志里。想回答下面这些问题,往往要跨好几个团队去对账:
- 这个月这笔大模型账单,主要是哪个业务系统贡献的?
- 某次调用到底是哪个业务场景在用、请求里传了什么内容,出了问题也说不清楚;
- 某个 Key 的调用量突然暴涨,是业务在正常增长,还是代码里出现了死循环重试,又或者 Key 已经泄露被盗刷?
- 某个员工离职后,他经手申请的 Key 有没有被停用?
没有统一的调用记录,这些问题只能靠"翻聊天记录、问经办人"来拼凑答案,而这在真正出现异常调用(无论是 Bug 还是安全事件)的时候,往往已经太晚了。
3. 换供应商、换模型,成了一场大工程
如果 API Key 和调用逻辑直接写死在每个业务系统里,供应商的任何变化都会直接传导到全公司:
- 想把某个业务从 GPT 切到 Claude 或国产模型,要在这个业务系统里重新接入一套 SDK、改一遍调用代码;
- 供应商突然限流、区域不可用,业务只能干等,没有自动切换到备用模型的手段;
- 想统一做密钥轮换(比如定期换 Key 以降低泄露风险),意味着要挨个通知所有接了这个 Key 的业务系统改配置、重新发布。
Key 直接下发的架构里,"换一次供应商"要在每一个业务系统里都重新做一遍
4. 数据出境与合规,无法在源头兜底
不同业务的数据敏感度是不一样的:营销文案生成可以放心调用海外公有云 API,但涉及客户身份信息、内部财务数据的请求,可能必须留在私有化部署的模型里处理,甚至完全不能出境。
如果每个业务系统各自持有 Key、各自决定调什么模型,这条合规红线只能靠"开发者自觉"来守住——没有任何机制能在技术上真正拦住一次违规调用。
问题的根源:把"凭证"和"调用逻辑"绑在了一起
以上所有问题,本质上都来自同一件事:业务系统直接持有供应商的真实凭证,同时自己决定怎么调用。
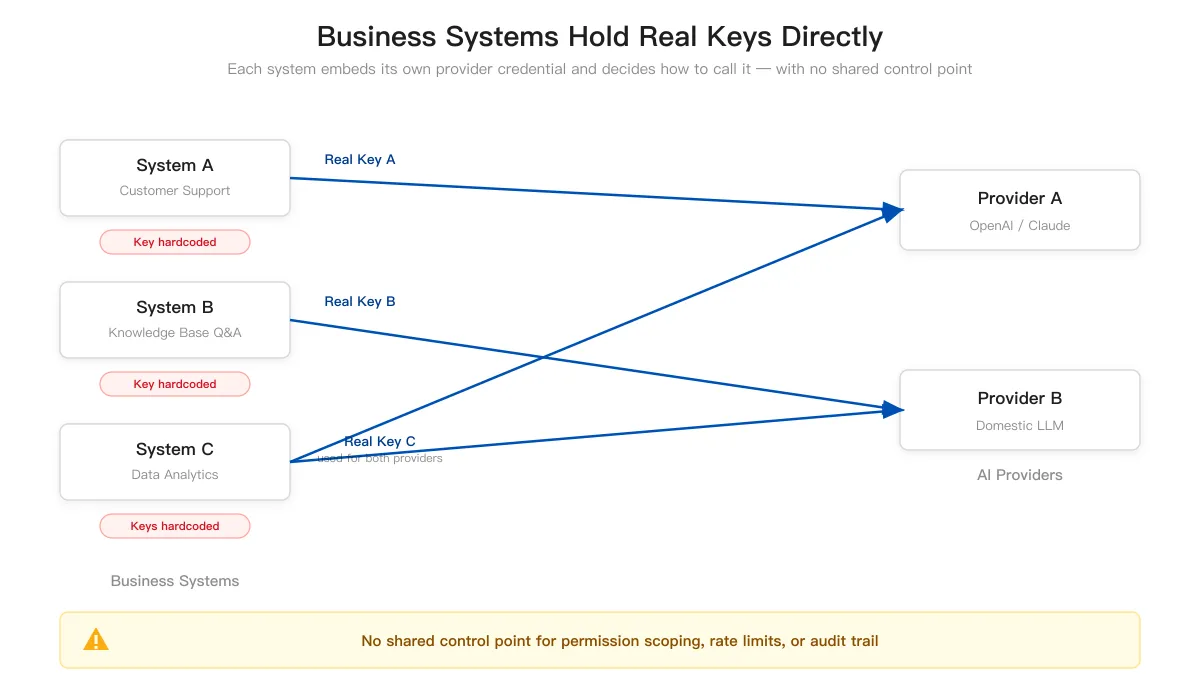
凭证泄露的面,等于所有业务系统代码 + 配置 + 日志的总和;权限、限流、审计,全都没有一个统一的地方去做。
更合理的做法:网关代持真实 Key,业务系统只拿"网关颁发的令牌"
一个更安全的架构是在业务系统和供应商之间加一层网关:真实的供应商 API Key 只保存在网关里,业务系统拿到的是网关为它单独签发的令牌。
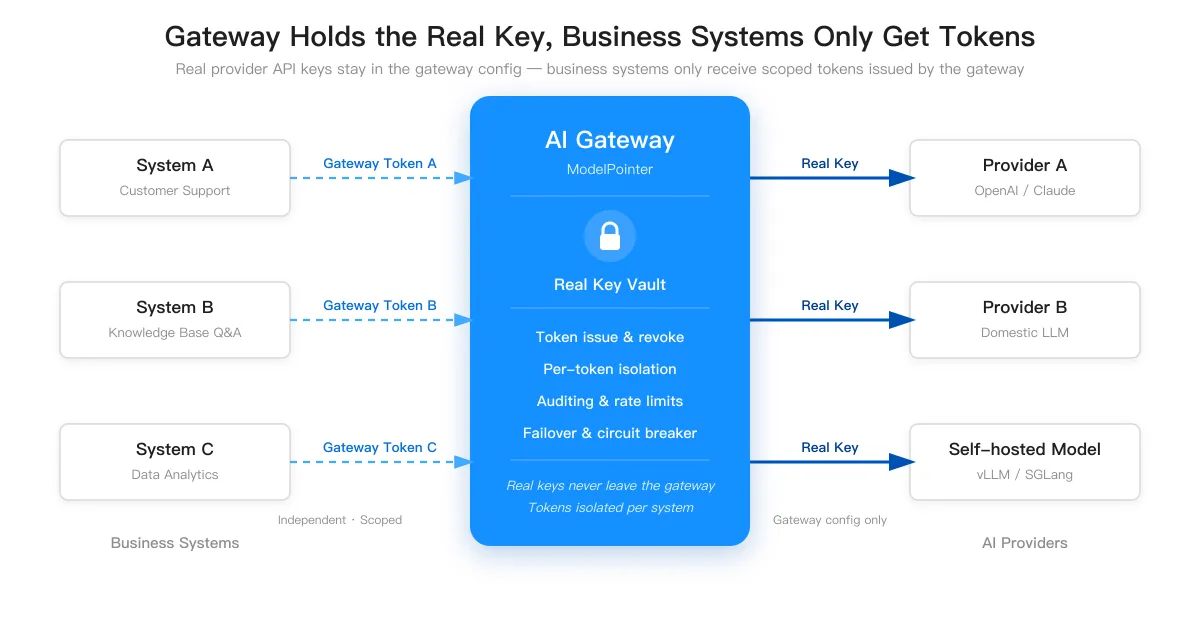
这个改动看起来只是"多加了一层转发",但实际上从根上解决了前面提到的每一个问题:
- 泄露面收窄:即使某个业务系统的令牌泄露,攻击者也只能在这个令牌被授权的范围内调用,无法拿到真实的供应商 Key,更碰不到其他业务系统的权限;
- 最小权限:网关可以为每个令牌单独配置能访问哪些模型、哪些接口,比如客服系统的令牌只能调用对外客服模型,调不到用内部经营数据 Fine-tune 出来的专用模型;
- 可审计:每一次调用都带着令牌身份经过网关,调用方、模型、Token 消耗、时延全部可以按业务系统精确统计,账单再也不用"对暗号";
- 限流可拆分:网关可以按令牌单独设置限流额度,业务系统 A 的流量高峰不会波及业务系统 B;
- 换供应商不用发版:真实 Key 只存在于网关配置里,切换供应商、做故障转移、灰度新模型,都只需要改网关配置,业务系统的代码和令牌完全不用动;
- 令牌可以随时收回:员工离职、业务下线,网关直接吊销对应令牌即可,不需要满仓库去找"这段代码是不是还在用那个 Key";
- 合规策略前置:哪些令牌只能访问私有化部署、哪些数据不允许出境,都可以在网关这一层统一配置和拦截,而不是依赖每个开发者自觉遵守。
ModelPointer 如何解决这个问题
ModelPointer 正是这样一层网关,专门用来收拢企业对大模型的调用凭证与访问策略:
- API Key 独立签发:为每个下游业务系统单独签发 Key,供应商的真实凭证只保存在网关配置中,业务代码里看不到、也用不到;
- 按 Key 精细限流:支持按 Key + 模型、按模型的滑动窗口限流(RPM / TPM),一个业务系统的流量高峰不会拖垮其他系统;
- 协议兼容、后端透明:兼容 OpenAI / Anthropic 协议(
/v1/chat/completions、/v1/messages、/v1/embeddings等),业务系统只对接网关的统一接口,背后是公有云 API 还是私有化部署,网关说了算; - 主 / 备分层路由与熔断:供应商限流或不可用时自动切换到备用后端,业务系统的令牌和调用方式始终不变;
- 完整访问日志:结构化 JSON 日志、Prometheus 指标、OpenTelemetry tracing,每一次调用都能追溯到具体业务、具体 Key。
结语
把 API Key 直接发给业务系统,短期看是"省了一层转发",长期看是把泄露风险、权限失控、审计缺失、供应商锁定这些问题一次性埋进了每一个业务系统的代码里,而且随着接入的业务系统越来越多,这笔债只会越滚越大。
业务系统需要的是"调用模型的能力",而不是"供应商账户的真实凭证"
把凭证收拢到网关一层,业务系统只持有网关签发的、权限收窄的令牌,是企业规模化使用大模型时绕不开的一步。
GitHub:https://github.com/modelpointer/modelpointer
关于这个系列
这是"AI Gateway 与企业 AI 基础设施"系列的第二篇。第一篇讲了这一层基础设施为什么会出现:
后面还会继续写这个系列,聊聊网关怎么做限流路由、多模型容灾、成本归因这些具体问题。


