💡 一句话总结:ArmorOCR 把对抗 OCR 从“能不能读出文字”升级为“能不能定位正确区域、读出内容并回答区域级问题”;两阶段训练把 8B 模型的 AdvSpot accuracy 从 31.2 拉到 55.7,但离解决还很远。
导语:猜对答案不等于看见证据
你把一张网页截图、AI 生成图或验证码式图片交给多模态模型,它输出了一段看似正确的隐藏文本。你是直接信,还是想追问一句:你说的到底是图里哪个区域?
这不是抬杠。安全审计、隐蔽信息抽取和对抗内容检测里,光有答案文本是不够的。如果模型靠上下文猜中,或者把两个相似区域混在一起,后续追溯就会出错。
ArmorOCR 抓住的正是这个缺口:对抗 OCR 需要 grounding,也就是同时输出内容与位置证据。论文标题里的 Grounded Adversarial Visual Perception,说的就是这种带区域依据的视觉感知。
想自己动手试?
这篇论文到底想解决什么问题?
论文要处理两个耦合问题:第一,如何系统评估多模态模型对对抗性视觉文本的感知;第二,能否把这种能力训练进单个模型,而不是每次推理都靠外部变换工具补救。
这里的“对抗性”不是攻击者刻意扰动像素,而是指视觉上特别难读的文本模式:符号编码、AIGC 融合文字、图案遮罩、旋转、镜像、极小字等。人类有时能借助上下文读出来,AI 却容易漏读、错读或误定位。
现有 OCR benchmark 多覆盖自然场景、文档或印刷体,对这些模式覆盖有限;而且多数评测只看答案文本,不检查模型是否定位到正确区域。
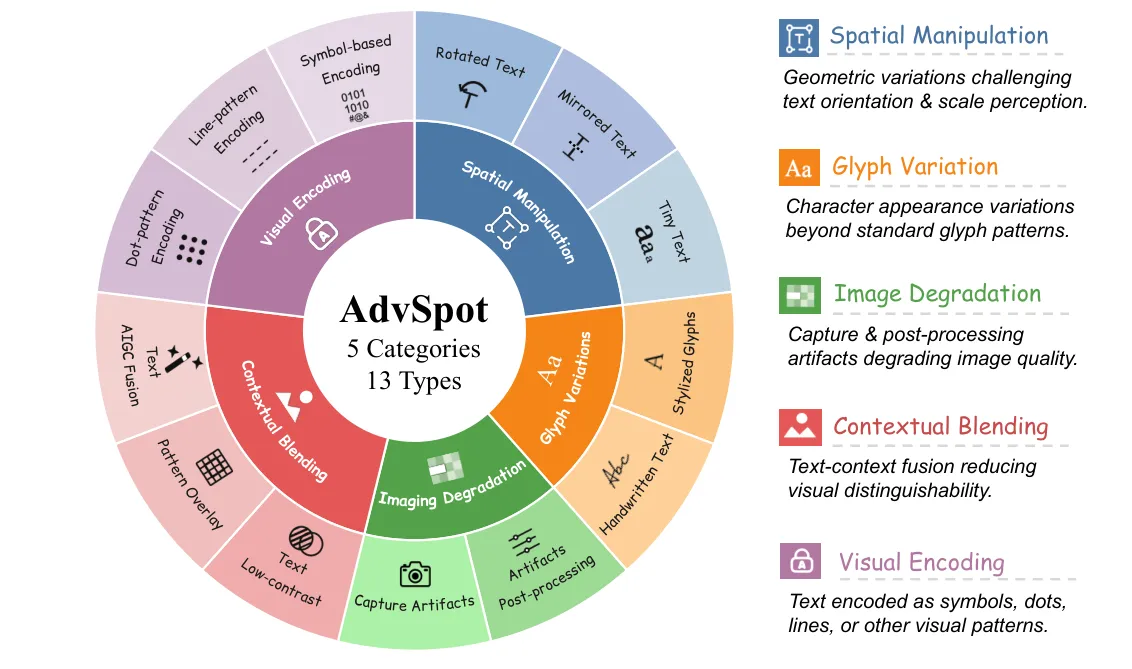
图说:AdvSpot 覆盖 5 个主类、13 种对抗 OCR 类型,把失败模式按视觉机制拆开。
论文的回应是 AdvSpot benchmark:390 张图、397 个 grounded VQA 对,每个样本带 bounding box、转录、感知类型标签和区域条件问题。标注由两人独立完成,只保留一致区域,再用 Qwen3-VL-235B 生成唯一指向该区域的 VQA,并经专家两轮审核。
评测也从一个任务变成四个:text-to-bbox 定位、bbox-to-text 识别、full spotting 同时输出文本与区域、grounded VQA 根据区域回答问题。四件事互相约束,避免“读对但定位错”或“定位对但读错”被总评掩盖。
它的思路是什么?
ArmorOCR 的训练分成两阶段,像先补感知,再学任务行为。
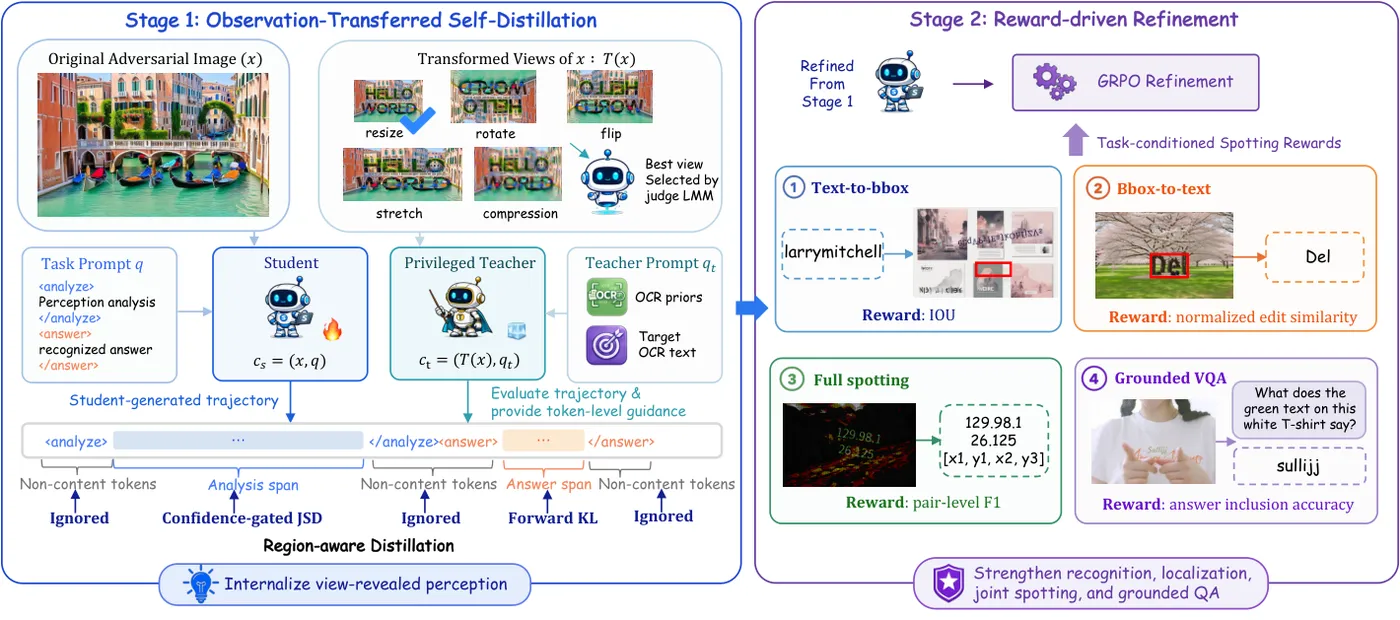
图说:Stage 1 用特权观察自蒸馏补感知缺口,Stage 2 用任务条件奖励优化定位、识别、完整 spotting 和 VQA。
Stage 1 是 Observation-Transferred Self-Distillation,观察转移自蒸馏。教师会看到特权信息:原始图的多种变换视图、最佳视角、对抗先验和目标 OCR 文本;学生只看原始图。训练目标,是让学生在部署时不依赖额外变换,也能复现教师借助特权视角得到的判断。
为什么需要特权视角?因为某些线索在原始分辨率或角度下确实难见,resize、stretch、rotation、flip、compression 后反而更容易读。系统先用 judge 模型选择最能揭示文本的视图,再让教师在这个“未来视角”上生成目标响应。
蒸馏时,ArmorOCR 对答案区域和分析区域分别计算损失,并用重要性权重强调对最终答案最有贡献的区域。这个设计避免标准蒸馏把 token 平等对待,被无关推理淹没。
Stage 2 使用 GRPO(Group Relative Policy Optimization,一种组内相对奖励的强化学习方法)。针对四类任务,每个 prompt 采样 8 个响应,分别计算 IoU、编辑距离、完整 spotting 和 VQA 正确性奖励。IoU(Intersection over Union)衡量预测框与真实框的重合度,越高越好。
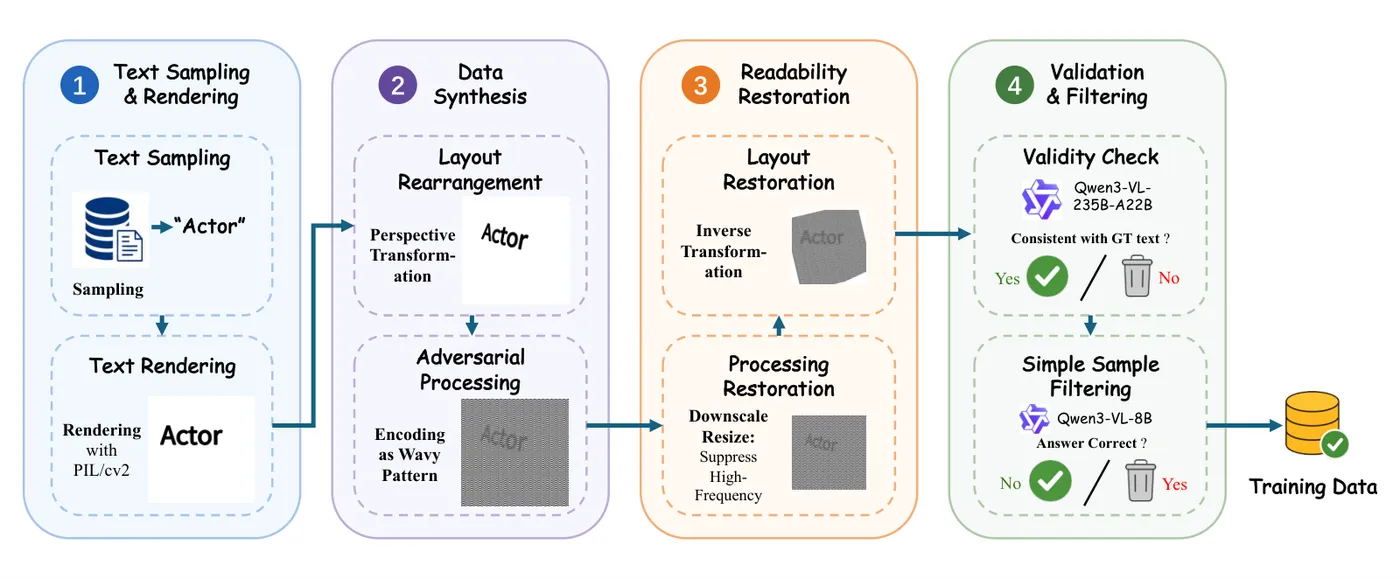
图说:合成管线生成文本与版面,记录边界框,施加遮罩、融合等对抗处理,再过滤过易样本。
训练数据由合成管线生成:渲染文本并记录 bounding box,碰撞检测后合成版面,施加 AIGC 融合、ASCII art、图案遮罩等处理,再恢复部分可读性,最后过滤 8B 模型已能轻松识别的样本。Stage 1 使用 50K 样本,Stage 2 使用 70K 样本。
效果到底怎么样?
先看阶段消融,这是最能解释方法的证据。
| 模型或设置 | AdvSpot Accuracy | AdvSpot IoU | 解读 |
|---|---|---|---|
| Qwen3-VL-8B base | 31.2 | 49.1 | 起点 |
| Stage 1 only | 48.9 | varies | 特权观察带来主要感知提升 |
| Stage 2 only | 39.8 | varies | 强化学习提升定位,但感知不足 |
| ArmorOCR full | 55.7 | 63.3 | 两阶段互补 |
Accuracy 衡量 VQA 答案正确率,越高越好;IoU 衡量定位质量,越高越好。完整模型两项都明显超过 base,但 55.7 的 accuracy 也意味着仍有超过四成 grounded VQA 错误。
论文还报告,现有开源和闭源 LMM 在 AdvSpot 上整体 accuracy 均低于 36%。Symbol Encoding 与 AIGC Fusion Text 对多数模型接近零准确率,说明这不是普通模糊问题,而是视觉编码和上下文融合机制上的系统性弱点。
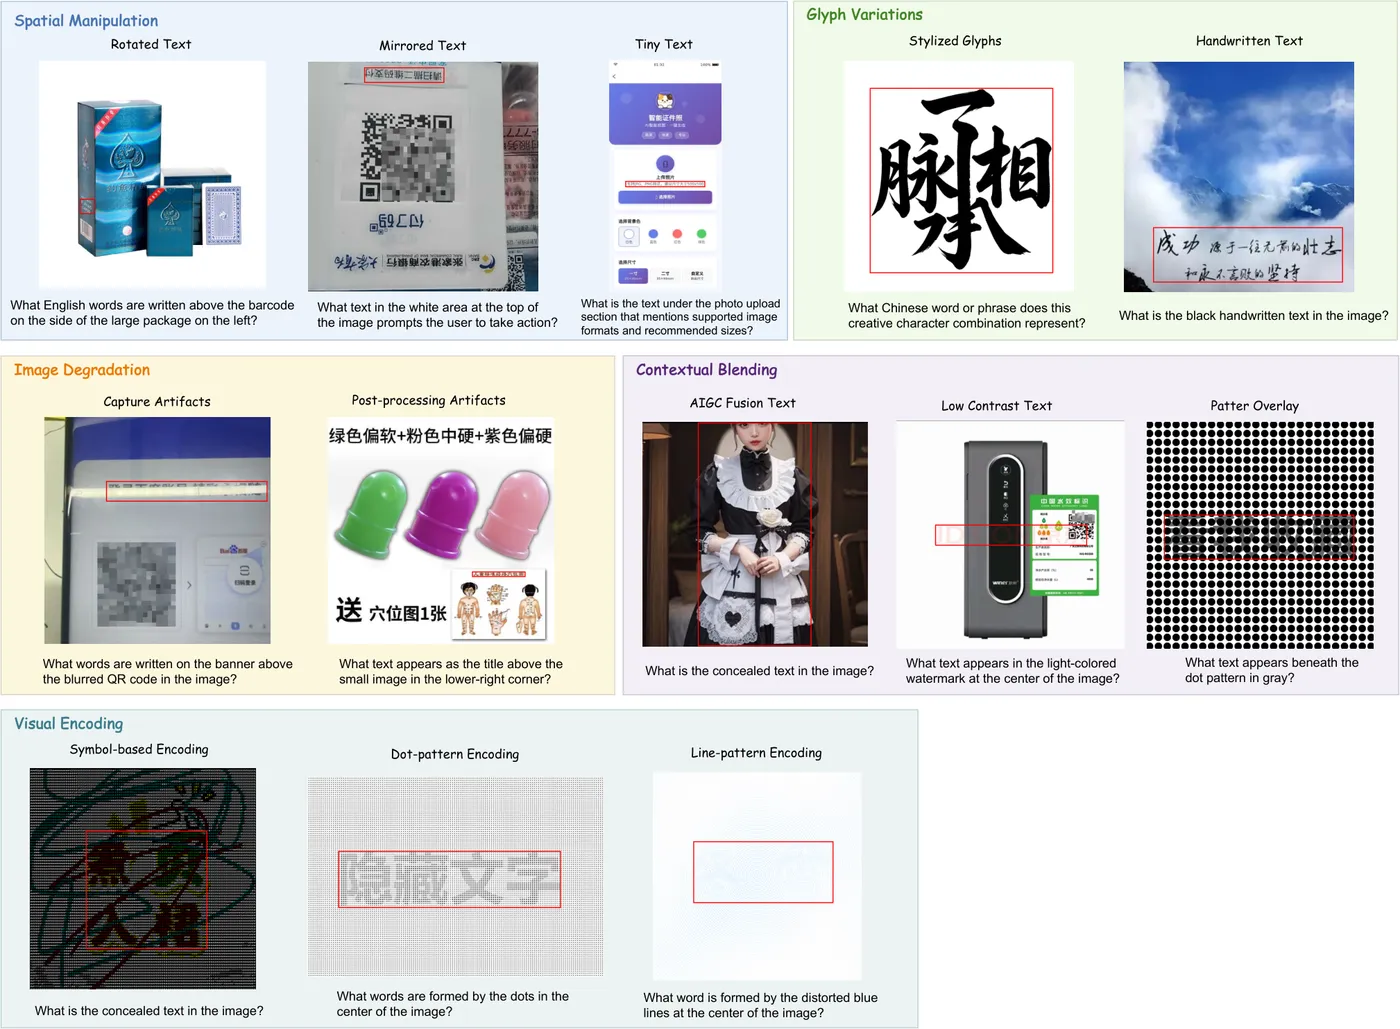
图说:样本覆盖符号编码、融合文本、遮罩和低对比等模式,要求模型同时给出区域和内容。
一个重要观察是 accuracy 与 IoU 并不同步。论文提到 Gemini-2.5 Flash 有竞争力的 accuracy,但 IoU 仅 28.0,低于 GPT-5。这直接支持论文主张:必须联合评估识别与定位。
外部 benchmark 上,ArmorOCR 在 AdvOCR average 达到 56.0,略高于 VACoT 的 55.0;synthetic split 为 68.0,比 VACoT 的 48.0 高 20 点。SmuggleBench average 为 17.1,高于 Smuggle-CoT 的 16.4,且使用更小模型。
我的读法是:这些外部结果证明能力没有只局限在自造 benchmark 上,但幅度不一,不能把 55.7 当成可用上限。
为什么你要关心?
如果你负责内容安全、截图理解、AIGC 审核或 OCR 鲁棒性,这篇论文有三块能直接借鉴。
- 🧪 把 grounded 输出纳入测试:只记录答案文本会掩盖猜测。让模型输出 bbox,再用 IoU 与文本正确性联合评估,能把定位错、识别错和问题理解错拆开。
- 🛡️ 为对抗模式建分层回归集:符号编码、融合文本、遮罩、旋转、镜像和极小字应该分开测。总分会掩盖接近零的子类。
- 🧠 借鉴特权观察自蒸馏:如果某些线索只有变换后才可见,可以把“变换后的知识”蒸馏回原始视角,推理期就不必携带复杂工具链。
从系统设计角度看,四任务 GRPO 也有参考价值。定位、识别、full spotting 和 VQA 的奖励互相约束,比单点优化更接近真实需要的能力组合。
理性看待
AdvSpot 只有 390 张图、397 个 VQA 对,子类样本更小;论文没有报告子类置信区间或模型间显著性检验,细分类结论应视为探索性。
训练数据由作者设计的合成管线生成,评测与训练分布之间可能存在偏向方法可解决类型的风险。AdvOCR 和 SmuggleBench 提供了部分外部效度,但样本量也偏小。
另外,Qwen 参与 QA 生成与训练可能带来模型家族偏置,部分专有模型与 PPU 环境也会限制完全复现。更稳妥的下一步,是在人工收集的非合成对抗图上做外部测试,并按“定位错、识别错、VQA 理解错、格式错”分解错误率。
作者:lusca
版本:lusca-paper-blog v1.5.0
出处:https://github.com/yjmm10/lusca-skill/tree/main/skills/lusca-paper-blog