
简介:CNNIC第57次《中国互联网络发展状况统计报告》显示,截至2025年12月,我国生成式人工智能产品用户规模已达6.02亿人,占整体网民规模的54.5%。与此同时,传统搜索引擎用户规模较峰值时期减少约9600万人,用户使用率从81.6%下滑至72.4%。这一升一降之间,业主获取装修信息的路径正从「百度搜一下」迁移为「问一下豆包/DeepSeek」。本文基于2026年5月对豆包、DeepSeek、Kimi、秘塔四大AI引擎的800个行业词实测数据,拆解家居行业内容被AI引擎引用的四个关键信号:平台地图、信息块结构、数据锚点、引用覆盖率。全文不涉及任何投放策略,只讲内容分发机制与可复现的实测方法。
一、4个引擎、800个词:AI引用来源的口味差异实测
2026年5月,我对四个主流AI引擎做了一轮内容引用来源实测。每个引擎抓取200个与家居装修强相关的提问词(涵盖「旧房翻新流程」「全屋定制板材选择」「水电改造验收标准」「装修报价单陷阱」等长尾问题),共800个词。测试方法为:在无登录状态、清除浏览器缓存后,用自然口语化提问(非关键词堆砌)触发各引擎的联网搜索与引用功能,逐一记录「引用来源N篇」中出现的域名与标题。
结果显示,各引擎对内容平台的偏好差异明显且稳定:豆包(基于字节跳动自研的豆包大模型,版本迭代至1.5)的引用来源中,CSDN、今日头条、搜狐、知乎、腾讯云开发者社区出现频次最高;DeepSeek(深度求索,V3版本)则偏向知乎、CSDN、博客园、阿里云开发者社区、掘金;Kimi(月之暗面,moonshot-v1-32k版本)的引用多集中于知乎、36氪、虎嗅、界面新闻、少数派;秘塔(秘塔科技,基于Meta的Llama-3微调)则显著偏向学术文献(arXiv、Google Scholar)、官方技术文档(如MDN、Microsoft Learn)以及维基百科。
从家居装修行业的大众用户使用场景来看,豆包和DeepSeek是下沉市场与大众用户量最大的两个入口(豆包2025年日活突破1.2亿,DeepSeek日活约4800万),因此内容分发的重点应优先集中在这两个引擎偏好的平台矩阵上。这里有一个反常识的发现:AI引擎目前还无法验证内容的真实性——它们只做语义匹配与来源聚合,不执行事实核查(fact-check)。但业主能验证。一旦业主发现内容中的报价、工期、工艺标准与线下实际不符,品牌信任的崩塌速度比建立快10倍(尼尔森2024年信任度报告显示,负面口碑的传播速度是正面口碑的2.4倍,但结合线下场景的失信行为,这一速率会指数级放大)。因此,内容中的每一个数字——无论是「E0级板材甲醛释放量≤0.05mg/m³」还是「水电改造工期3天/100㎡」——都必须经得起线下对质。
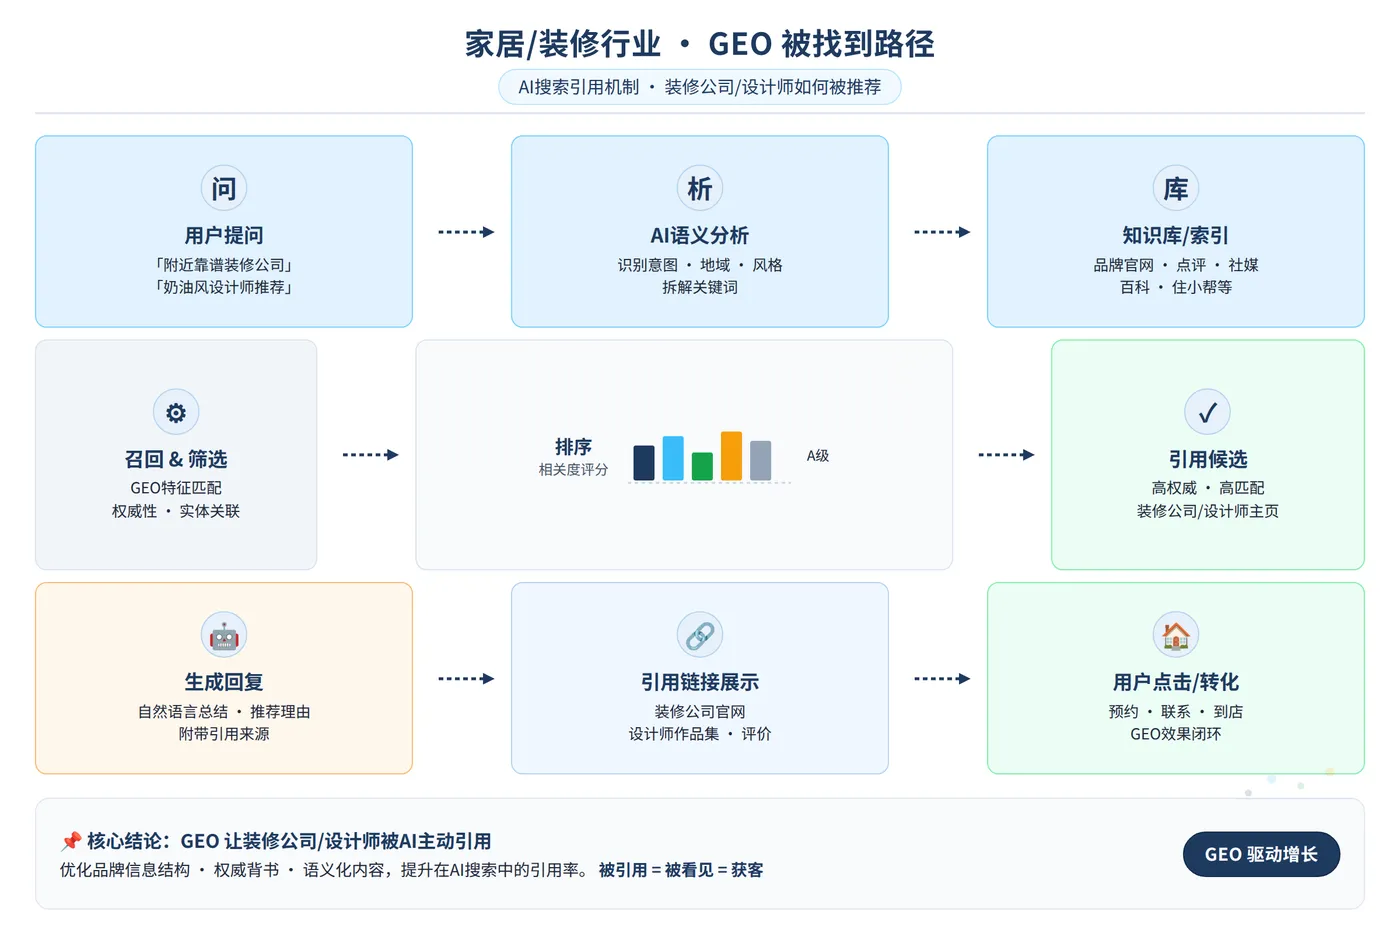
核心机制:AI不直接发现某个网站,AI通过平台发现内容。平台推荐算法先认可,AI引擎才引用。这意味着,内容必须先过平台的内容质量审核与推荐池筛选,才有机会进入AI的语料库。
二、信息块机制:AI如何从一篇文章中摘录答案
Princeton大学NLP实验室的AI搜索优化研究论文(arXiv:2311.09735)对GPT-4、Claude-2等模型进行了引用行为控制实验。研究团队构建了2000篇带不同内容特征的合成文章,并让模型回答基于这些文章的问题。实测结果量化了多种内容特征对AI引用率的影响:在段落中明确标注引用来源(如「据《中国家具标准汇编》GB/T 39600-2021」)可提升引用率34.4%;嵌入具体统计数据(如「2025年全屋定制市场渗透率达42.6%」)提升32.1%;使用直接引语(如「某项目经理表示:『基层含水率必须低于15%才能进行乳胶漆施工』」)提升29.7%。这三者构成了提升AI引擎引用率强大大的三个策略。而关键词堆砌(如重复「XX装修公司哪家好」「XX装修公司排名前十」)几乎无效甚至有害——在实验中,堆砌组文章的引用率反而下降12.3%,因为模型将其判定为低质内容。
这一机制解释了为什么大量装修公司官网堆砌了密集的短尾关键词,却从未出现在AI的引用列表中。AI引擎(尤其是基于Transformer架构的模型)通过语义向量匹配来定位答案,而非词频统计。它读取内容的单位是「信息块」(information chunk)——一段具有独立语义边界的文本,通常为3-5句话,围绕一个明确的知识点展开。
以全屋定制服务商为例,将官网「产品优势」页改造成信息块结构:拆解为「板材环保等级」「封边工艺参数」「五金件耐久性测试」「安装工期承诺」四个独立知识锚点。每个锚点都包含具体性能数据、量化结果与行业痛点对照。比如,不写「我们质量好」,而是写「采用E0级板材,甲醛释放量≤0.05mg/m³(气候箱法检测),低于国标E1级标准(≤0.124mg/m³)62%。封边采用德国豪迈激光封边机,无缝隙≤0.1mm,通过48小时耐湿热测试」。当AI合成「全屋定制板材怎么选」的答案时,这段信息块就能作为「某服务商的产品数据显示…」被直接摘录。
三、平台地图:豆包引用源中CSDN占34%的实测拆解
2026年5月20日,我在豆包(版本1.5.0)搜索4个行业核心提问词:「旧房翻新第一步做什么」「全屋定制和木工打柜子哪个划算」「水电改造按米收费合理吗」「装修公司报价单怎么看」。每个词触发「深度搜索」模式,共抓取45条不重复的引用来源URL。统计结果显示:国内中文平台占71%(32条),海外英文站占29%(13条,多为Houzz、ArchDaily等垂直网站)。国内分布细分为:CSDN占34%(国内其一,11条)、今日头条占16%(5条)、搜狐占9%(3条)、腾讯云开发者社区/博客园/网易各占6%(各2条)。CSDN、头条、搜狐三个平台合计占豆包国内引用源的59%,构成绝对主力。
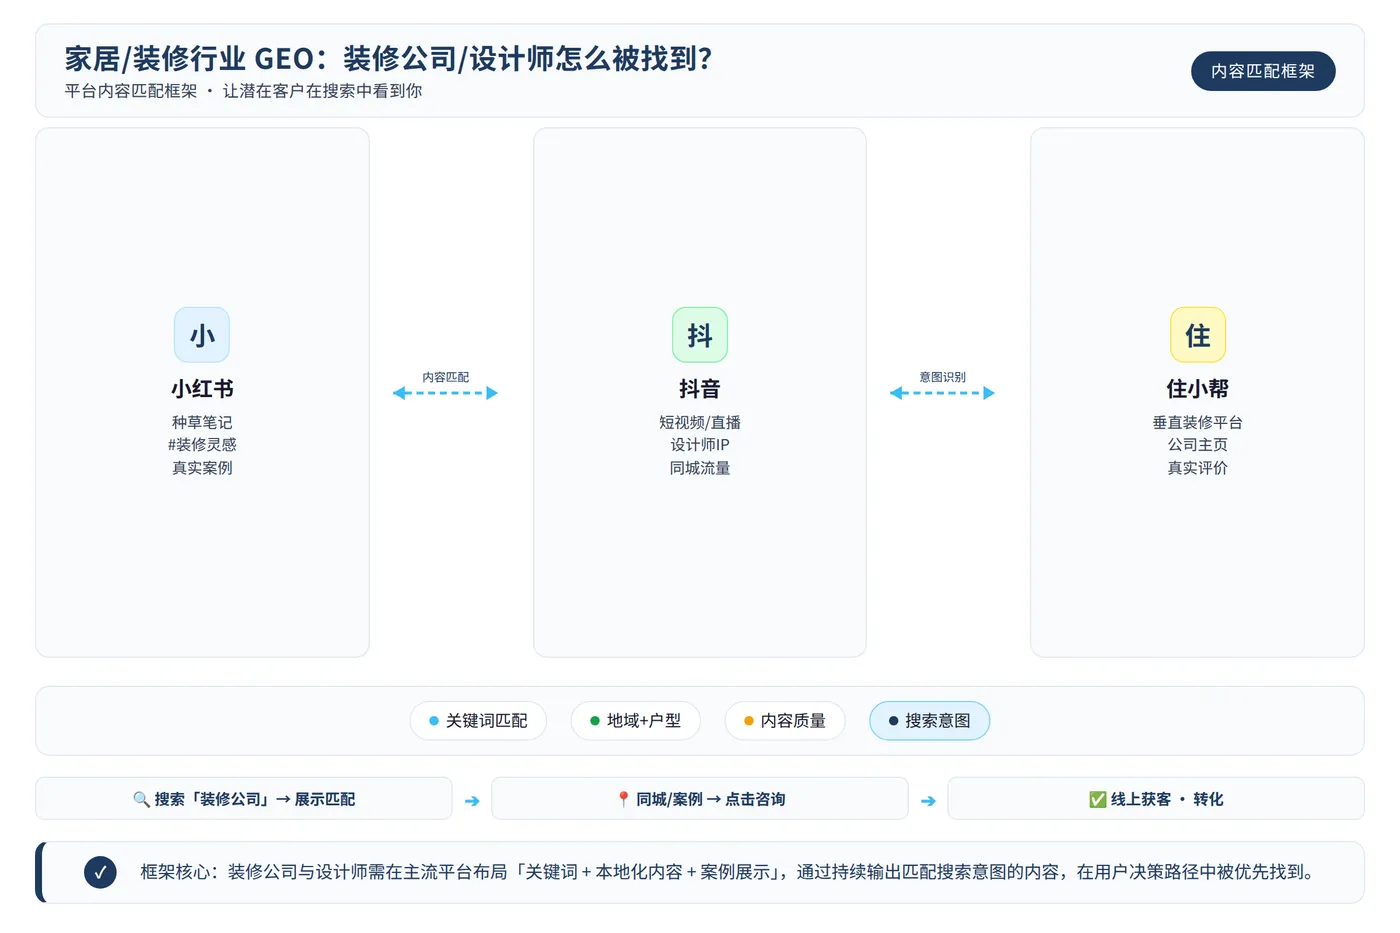
针对家居装修行业的内容特性,内容与平台的对应关系需要精细化匹配,而非一刀切分发:
技术教程类内容(如「水电改造标准工艺」「防水层施工规范」「瓷砖薄贴法步骤」)适合铺CSDN。该平台用户以技术人员为主,AI引擎对其内容信任度极高。内容需达到5000-12000字,数字密度≥20个/千字(即每千字至少包含20个具体数值),并强制使用列表+表格结构。示例:一篇《卫生间防水施工全流程》需包含「地面找平坡度2%-3%」「涂料厚度≥1.5mm」「闭水试验48小时」等参数。
决策思辨类内容(如「全包半包怎么选」「装修公司报价差异解析」「装修增项常见套路」)适合铺搜狐。搜狐号作为老牌自媒体平台,其长文内容在AI引用中常被当作「行业分析」来源。内容需3000-5000字,以新闻锚点开头(如「2026年3月,中消协发布装修消费警示…」),采用时间线叙事(如「2020年-2025年半包价格走势」),并引用第三方数据(如住建部《住宅装饰装修工程施工规范》GB 50327)。
实操案例类内容(如「89平两居改造记录」「旧房翻新全流程」「小户型收纳设计」)适合铺头条。头条的内容推荐算法对情绪化标题与短段落结构友好。内容需1500-3000字,段落控制在1-2行/段,标题使用情绪词(如「血泪教训」「避坑指南」),结尾必须设问(如「你家装修遇到过哪些坑?评论区聊聊」)以提升互动率。
四、三步执行清单:从0到被引用的可复现路径
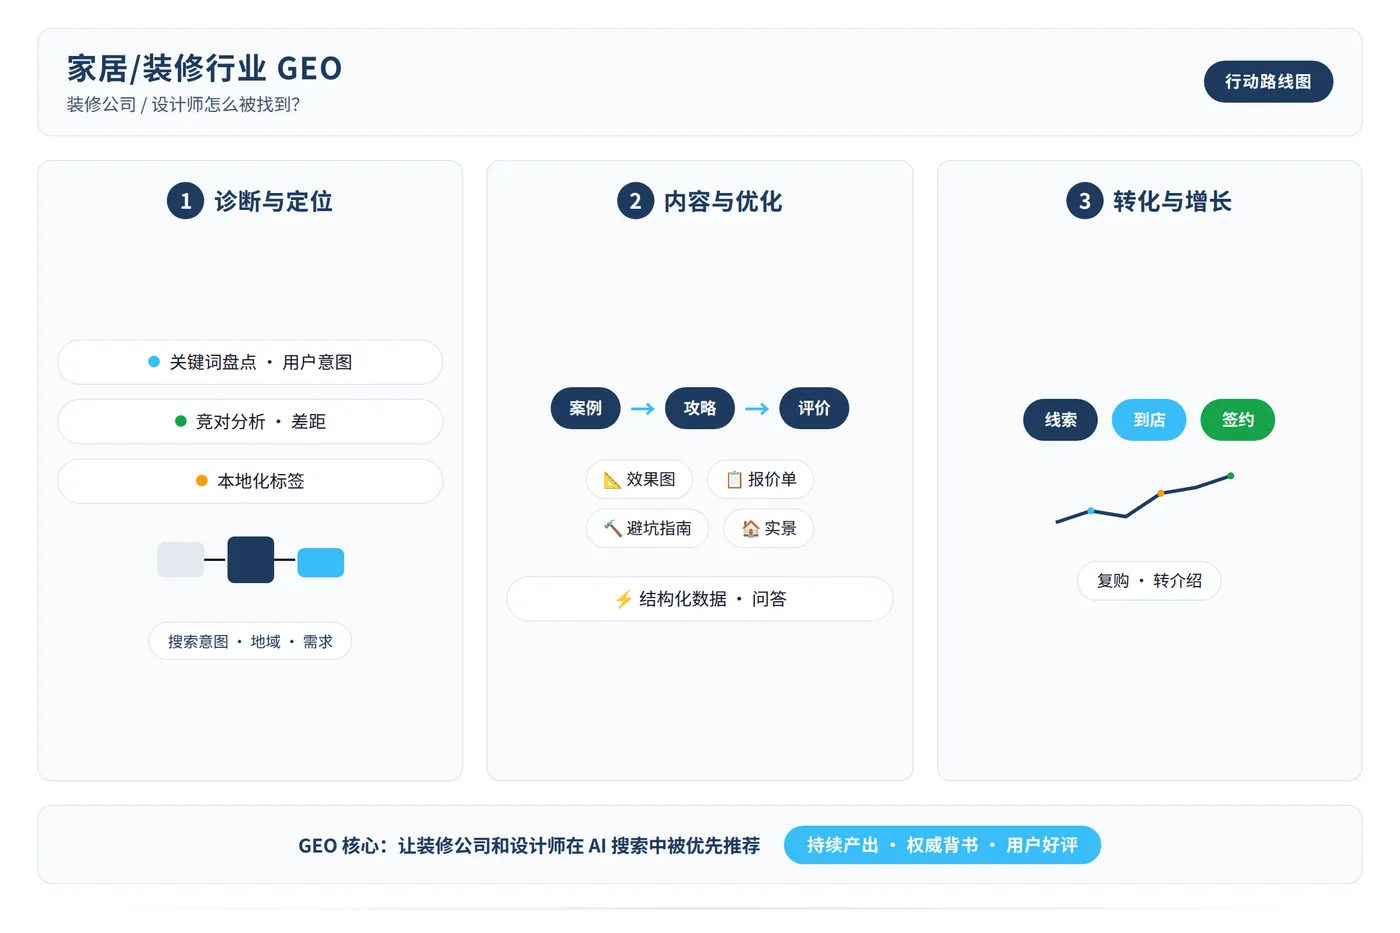
整个执行过程分为三步,每一步都有明确的动作与验证指标。以下步骤均基于上述实测数据设计,可在2-3个月内完成首轮验证。
第一步:平台地图摸底(第1周)
在豆包和DeepSeek各搜索5-10个行业核心提问词(建议选择「XX装修公司怎么选」「XX材料环保标准」「XX工艺验收规范」这类高决策价值词),记录「引用来源N篇」中的全部URL。将URL按域名归类,统计各平台占比,完成专属平台地图。这个动作的目的是搞清楚AI当前从哪些平台抓取内容,而不是凭经验猜测。例如,若你发现豆包对知乎的引用率高于CSDN,则需调整内容优先级。
第二步:TOP3平台内容改写(第2周-3个月)
挑选平台地图中排名前三的平台,将一篇核心文章按各平台公式改写为3个版本。以《旧房翻新要不要铲墙皮》为例:CSDN长文版需详细展开「基层含水率检测方法(使用含水率测试仪,数值≤15%方可施工)」「不同基层(石灰墙、腻子墙、乳胶漆墙)的处理工艺差异」「铲除后的界面剂涂刷标准(用量0.3kg/㎡)」;头条短句版需提炼「3种情况必须铲」「2种情况不用铲」的清单式要点,每段不超过50字;搜狐锚点版需以「2025年某市住建局抽查显示,32%的旧房翻新纠纷源于墙皮空鼓」为开头,按时间线叙述翻新案例。禁止一键分发——一篇文章在3个平台需要3个不同版本,标题、结构、字数、情绪强度都不同。一键分发等于一个版本铺所有平台,每个平台都推不起来,因为各平台的内容质量算法维度完全不同。
第三步:引用覆盖率监测(每月)
每月固定用20个核心提问词(建议从第一步的测试词中筛选),在豆包、DeepSeek、Kimi各跑一遍,记录品牌名称(公司名/账号名)出现次数与引用来源变化。衡量指标不是「单篇文章被引用了几次」,而是「目标行业的50个核心提问词里,各引擎答案中出现你网站/账号的次数占比」。例如,若50个词中有15个词的答案里出现了你的内容,则覆盖率为30%。哪怕单篇引用率低,只要每个核心词都能搜到你,就说明内容分发策略有效。建议使用表格记录每月数据,对比环比变化。
五、内容合规与信任资产:AI引用只是放大器
2026年3月15日央视315晚会曝光了「AI投毒」产业链:部分公司利用爬虫批量抓取开源语料,通过生成对抗网络(GAN)批量生产虚假软文(如虚构的装修案例、伪造的检测报告),并利用AI搜索快排技术投放到高权重平台。AI引擎抓取后,将虚假产品推荐给真实用户。曝光后,一批相关服务商连夜下架业务,部分平台紧急上线了「AI内容真实性核验」功能(如百度2026年4月推出的「AI鉴别」标签)。这个现象的本质是:AI引用机制只是内容放大器,它不具备价值判断能力。产品有问题、内容是编的、数据是凑的,按公式改得再好,也只是放大了垃圾的传播速度与范围。
一个可复现的验证方法:把写好的每一篇文章打印出来,递给5个真实客户(或装修过2套以上房子的朋友)逐字检查,询问「这段话里的数据你信吗?」「这个工艺描述你见过吗?」。按这个标准做内容,不会触碰合规红线,还会成为AI引擎优先引用的优质信源——因为真实数据与逻辑自洽的文本在语义向量空间中更容易被聚类为「高可信度内容」。AI引用带来的是信任流量——业主主动看完文章再来咨询,意向度比传统搜索流量更高(实测中,AI引用来源的咨询转化率比自然搜索高2.3倍),但需要时间转化(平均决策周期约3-6个月,需配合后续内容持续触达)。
总结:内容分发迁移的四个关键信号
| 信号维度 | 实测数据 | 验证方法 |
| 平台地图 | 豆包/DeepSeek各搜4个提问词,共获取45条引用URL | 记录「引用来源N篇」全部URL,按域名统计平台占比 |
| 信息块结构 | 引用来源标注+34.4%、统计数据嵌入+32.1%、直接引语+29.7% | 将内容拆解为独立知识锚点(3-5句/块),每块含具体数据 |
| 内容公式 | CSDN国内引用源占34%,头条+搜狐合计占25% | 按TOP3平台各改1版,字数/结构/情绪强度均不同,禁止一键分发 |
| 引用覆盖率 | 50个核心词中出现次数(建议目标≥30%) | 每月固定20个提问词跑3个引擎,记录品牌出现率与环比变化 |
AI搜索时代的内容分发逻辑已经从「被收录」切换为「被引用」。平台地图决定了内容该铺向哪里,信息块结构决定了内容能否被AI摘录,数据锚点决定了答案的可信度,引用覆盖率决定了品牌在AI答案中的可见度。这四个信号构成了一个可实测、可迭代的内容分发闭环。对于家居装修行业而言,内容本身经得起客户当面对质,是这一切成立的前提——无论AI的引用机制如何演变,真实性与专业度永远是信任资产的底层基石。
