摘要:生成式引擎正在重塑企业内容的可见性逻辑。普林斯顿大学发表于arXiv的《Generative Engine Optimization》论文实测数据显示:在内容中加入权威来源引用、统计数据、明确结论,AI引擎引用该内容的概率分别提升34.4%、32.1%和29.7%。本文基于这一机制,拆解一套30天可执行的AI搜索优化路径——第一周建立答案库、第二周重构存量内容、第三周生产三类高引用率语料、第四周搭建引用监控闭环。全文不涉及排名追踪与流量指标,只聚焦一个核心目标:让内容成为AI引擎愿意直接引用的答案源。
一、机制拆解:AI引擎的引用逻辑与搜索排名的本质差异
生成式引擎的信息检索机制与传统搜索引擎存在根本性差异。传统搜索将页面存入索引库后按权重排序,而生成式引擎需要从页面中提取一段结构清晰、独立完整、有数据支撑的文字,直接嵌入其生成的答案中。这意味着内容能否被引用,取决于页面中是否存在「可摘走即用」的答案块。
普林斯顿大学研究团队通过对照实验验证了这一机制:在相同内容基础上分别添加权威来源引用、统计数据和明确结论,AI引擎的引用概率分别提升34.4%、32.1%和29.7%。反之,关键词堆砌几乎无效,甚至可能产生负面影响。这一数据揭示了AI搜索优化的核心度量单位——不是收录量,而是引用次数。
实际操作中,我采用了一套可复现的诊断方法:将目标关键词逐一输入ChatGPT、Perplexity、Bing Copilot,记录答案中出现的每一个来源链接,整理成「AI引用清单」。以某B2B软件产品为例,诊断结果显示AI引擎引用了三个竞品的官网博客、两篇行业媒体测评和一个知乎回答,而该产品官网内容完全未被提及——原因在于其文章结构均为「产品介绍+功能列表+案例展示」,缺乏可直接摘引的结论性段落。
二、第一周:答案库定位与AI引用来源盘点
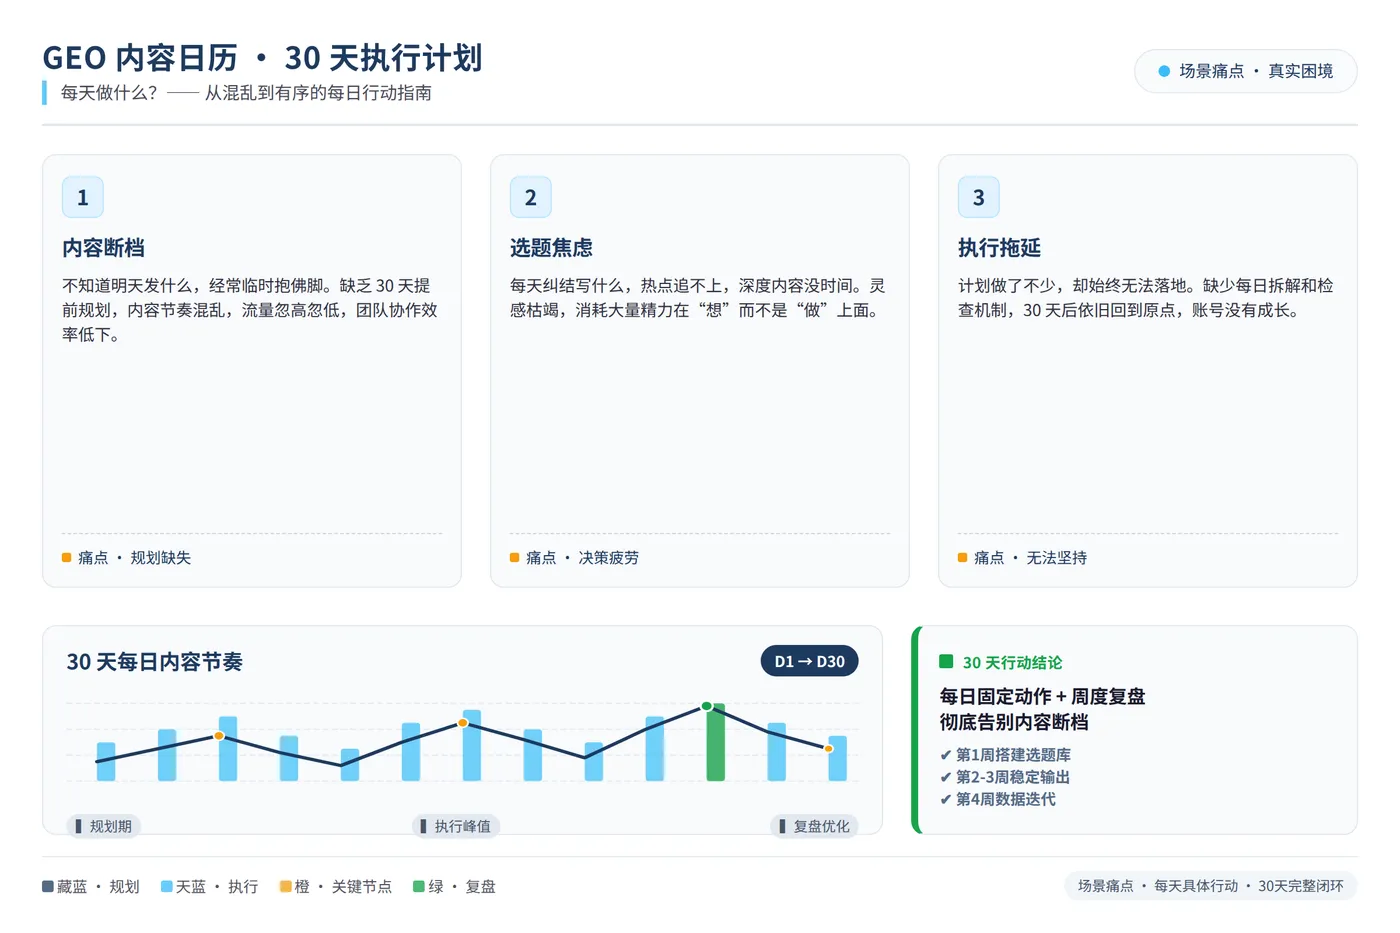
第一周的目标是建立「答案库存」——即用户真实问题及当前AI引用来源的完整地图。执行路径分为两个阶段:前三天收集真实问题,后两天完成AI引用来源盘点。
问题收集的渠道优先级为:AskReddit、知乎、行业论坛、客服聊天记录。以工业品B2B行业为例,常见问题形态包括「XX类软件怎么选」「A和B有什么区别」「XX方案的优缺点」等。收集标准是有明确答案指向的疑问句,而非泛化的行业话题。
引用来源盘点的操作要点:将收集到的问题逐一输入ChatGPT、Perplexity、Copilot,记录AI引用的来源域名、页面类型(博客/测评/问答/数据页)及引用段落的结构特征。这张清单将作为后续所有内容改造与生产的地图。
关键提示:此阶段严禁使用关键词搜索量作为目标指标。AI引擎的引用逻辑与搜索排名无直接关联——搜索看重外链与域名权威,AI引擎看重内容是否能形成完整的「答案块」。目标不是排名,而是提名。
三、第二周:存量内容的结构化改造
大多数企业已积累的产品文档、解决方案、服务案例,普遍存在「自我介绍式」结构问题:首段讲行业背景、中段讲产品功能、尾段讲客户评价。这类内容无法被AI直接摘引,因为缺乏独立完整的答案块。
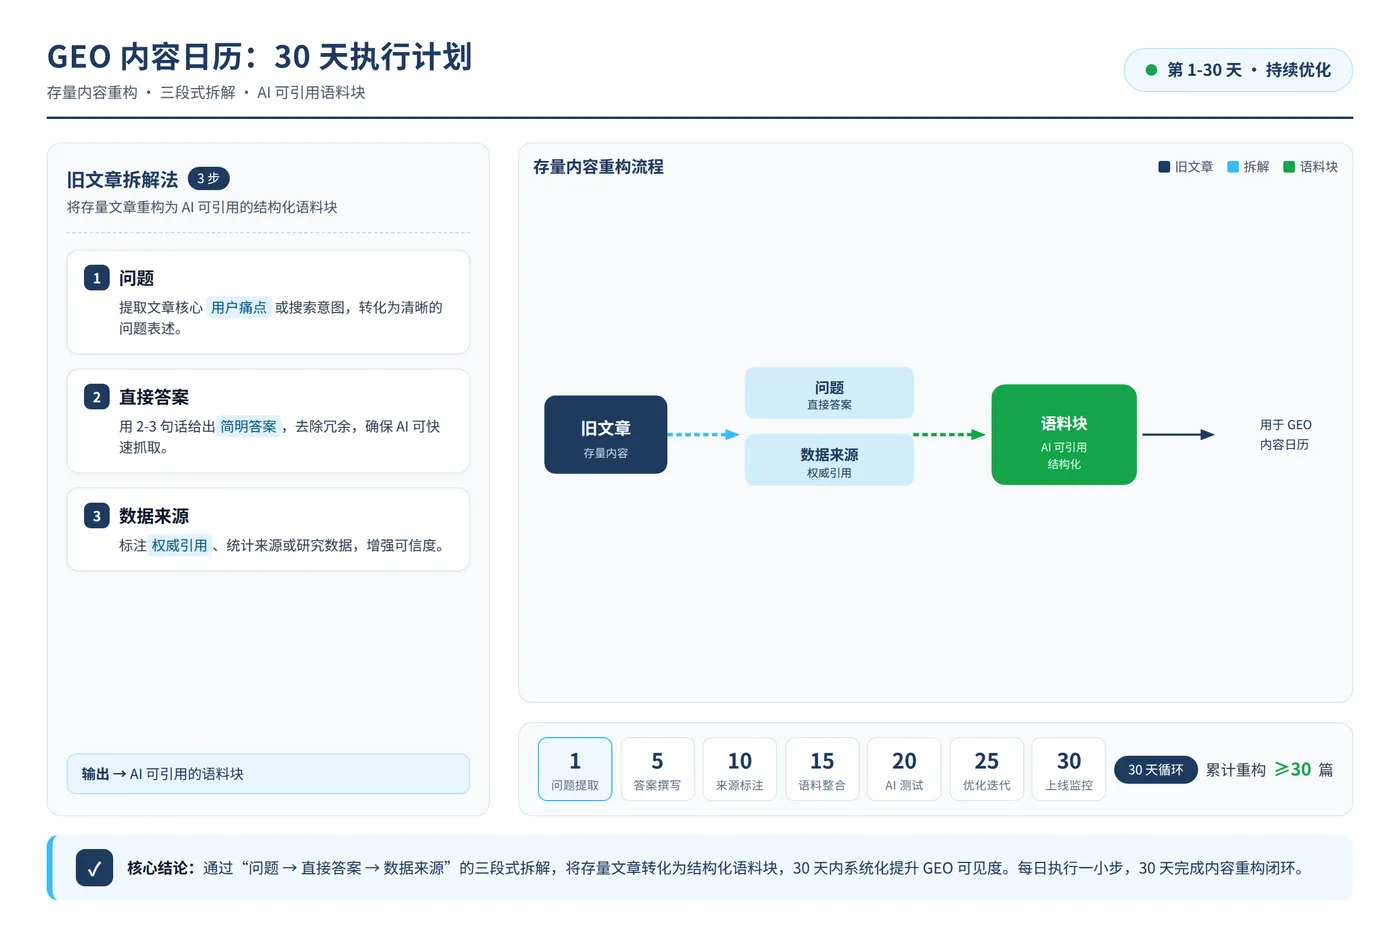
改造动作分为三步,每步对应一个可验证的机制原理:
第一步:提炼一句话答案。将全文核心结论压缩为一句话,置于文章开头。例如「选企业协作工具只需看三个维度:成员规模、项目复杂度、预算范围」。这类结论明确的句子是AI引用的最小单位。Ahrefs对AI Overviews的研究表明,生成式引擎优先引用带具体数字的句子,因其呈现更高的可靠性。
第二步:为结论配置可验证数据。将「产品性能良好」改写为「接口响应时间平均为120毫秒(内部测试环境)」。数字密度直接影响AI引擎的摘引概率,这是可复现的文本优化动作。
第三步:标注数据来源与年份。来源可以是行业报告、官方文档或自有研究数据,但必须明确出处和年份。普林斯顿论文实测中,来源标注带来的引用率提升为34.4%,是三项优化手段中增益最高的。
本周实操建议:不追求改造全部文章,仅针对第一周「AI引用清单」中与自身相关的10个问题,每个问题对应改造1篇旧内容。同时注意避免两个常见误区——其一,仅修改标题和meta描述而不重构正文,无法产生可引用段落;其二,使用「这篇博文将讨论……」等无信息量的开头句式,既不被搜索引擎青睐,也不被AI引擎引用。
四、第三周:三类高引用率内容的生产策略
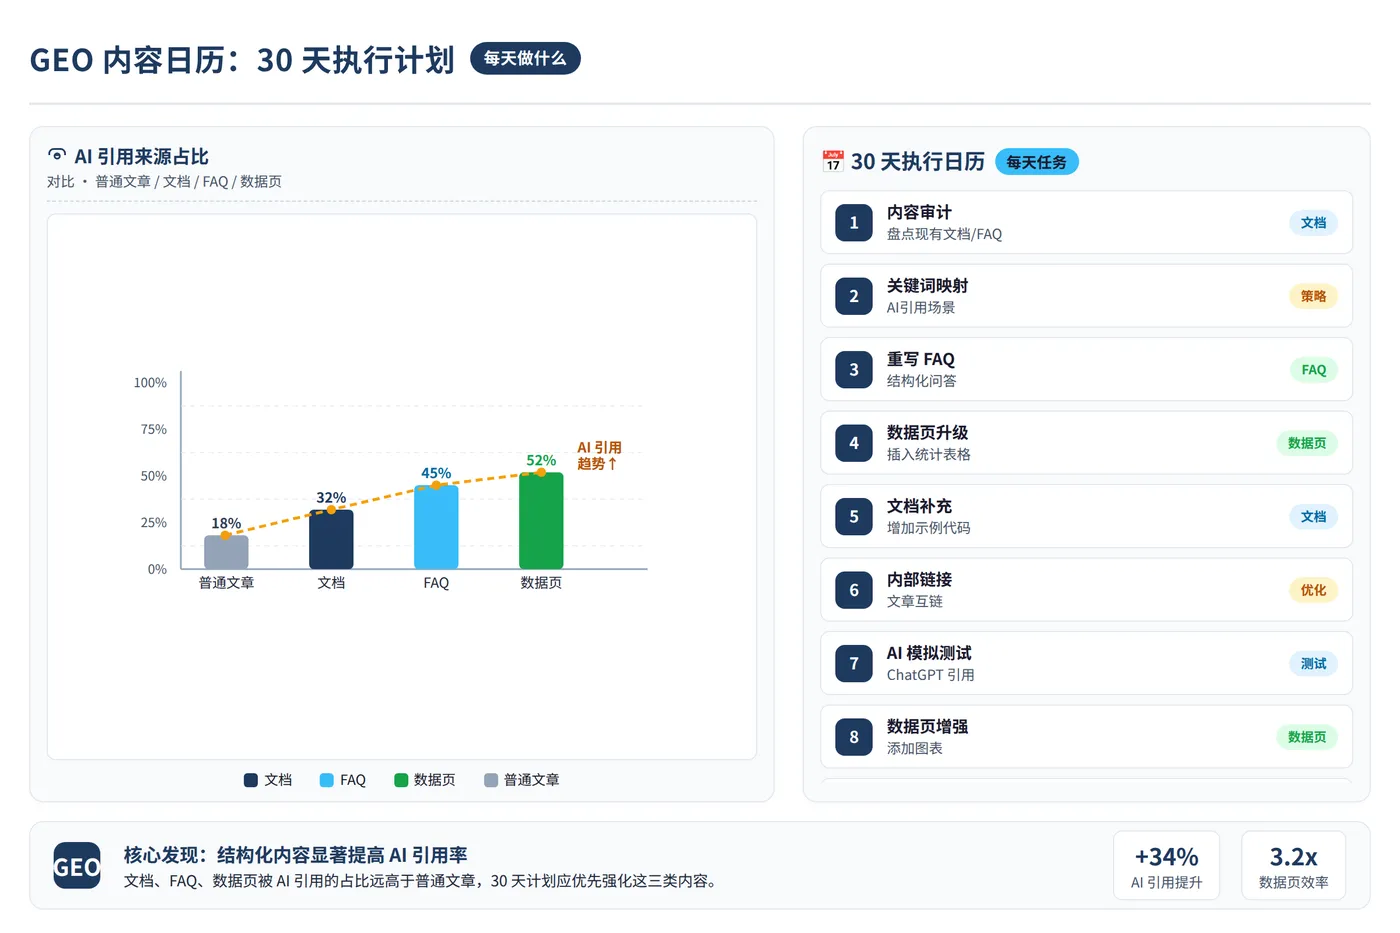
存量改造完成后,需要生产三类天生适配AI引擎引用逻辑的新内容。BrightEdge 2024年研究报告显示,AI Overviews中超过60%的答案用于回应比较类问题,这为内容生产提供了明确方向。
对比类内容:针对「A和B怎么选」「C和D有何区别」类高频问题,产出结构清晰的竞品对比文。标准结构为:一张对比表(维度+数据+结论),加上开头一句场景化建议(如「如果侧重X场景,选A;更看重Y指标,选B」)。
FAQ问答库:将客服高频问题转化为「问题+直接答案」结构,一个问题一个H3标题,答案控制在50至100字之间并加粗关键词。这类内容既满足AI引擎对结构化答案的偏好,也是FAQPage结构化数据的天然素材。
数据页:以中立语气呈现行业关键数据,不提及自身产品。例如「XX行业2025年核心数据」页面,包含市场规模、增长率、技术渗透率等指标。AI引擎在回答相关问题时,会优先引用这类干净、权威的数据源。
内容生产需遵循「一段一观点」原则。AI引擎的摘引逻辑决定了段落信息密度不宜过高——一个段落包含三个观点时,引擎反而难以判断该摘取哪句。实际案例中,某工业品B2B客户在第三周仅产出一篇「钢材采购常见误区」长文,拆分为12个问答对,两周后该页面出现在Perplexity的相关问题引用来源中。
五、第四周及以后:引用监控与迭代闭环
执行至第四周,核心工作从内容生产转向监控机制搭建。生成式引擎的语料库刷新周期不固定,热点型与专业型问题的答案来源替换较为频繁,因此需要建立可持续的引用跟踪流程。
监控方法:选取第一周清单中的10个核心问题,每周在ChatGPT、Perplexity、Copilot、Gemini及Google AI Overviews中各提问一遍,记录三项指标——答案来源域名、自身内容是否被引用、未被引用时AI引用了谁及其结构特征。记录工具用Excel即可满足需求。
迭代策略:将每周记录中被引用次数最多的外部来源进行拆解,分析其结构、数据密度、措辞风格,将可借鉴的特征回填至下一轮内容生产。这一过程形成「提问测试-记录来源-对比分析-回填优化」的完整闭环,使AI搜索优化从经验驱动转向数据驱动。
在此阶段需警惕两类指标陷阱:其一,不应关注「AI收录率」——生成式引擎不会公开页面收录数量,可观测的唯一指标是「答案中是否出现我的内容」;其二,需维护引用数据的时效性,在核心内容中标注「数据最后更新日期」字段,每年至少回填一次数据。
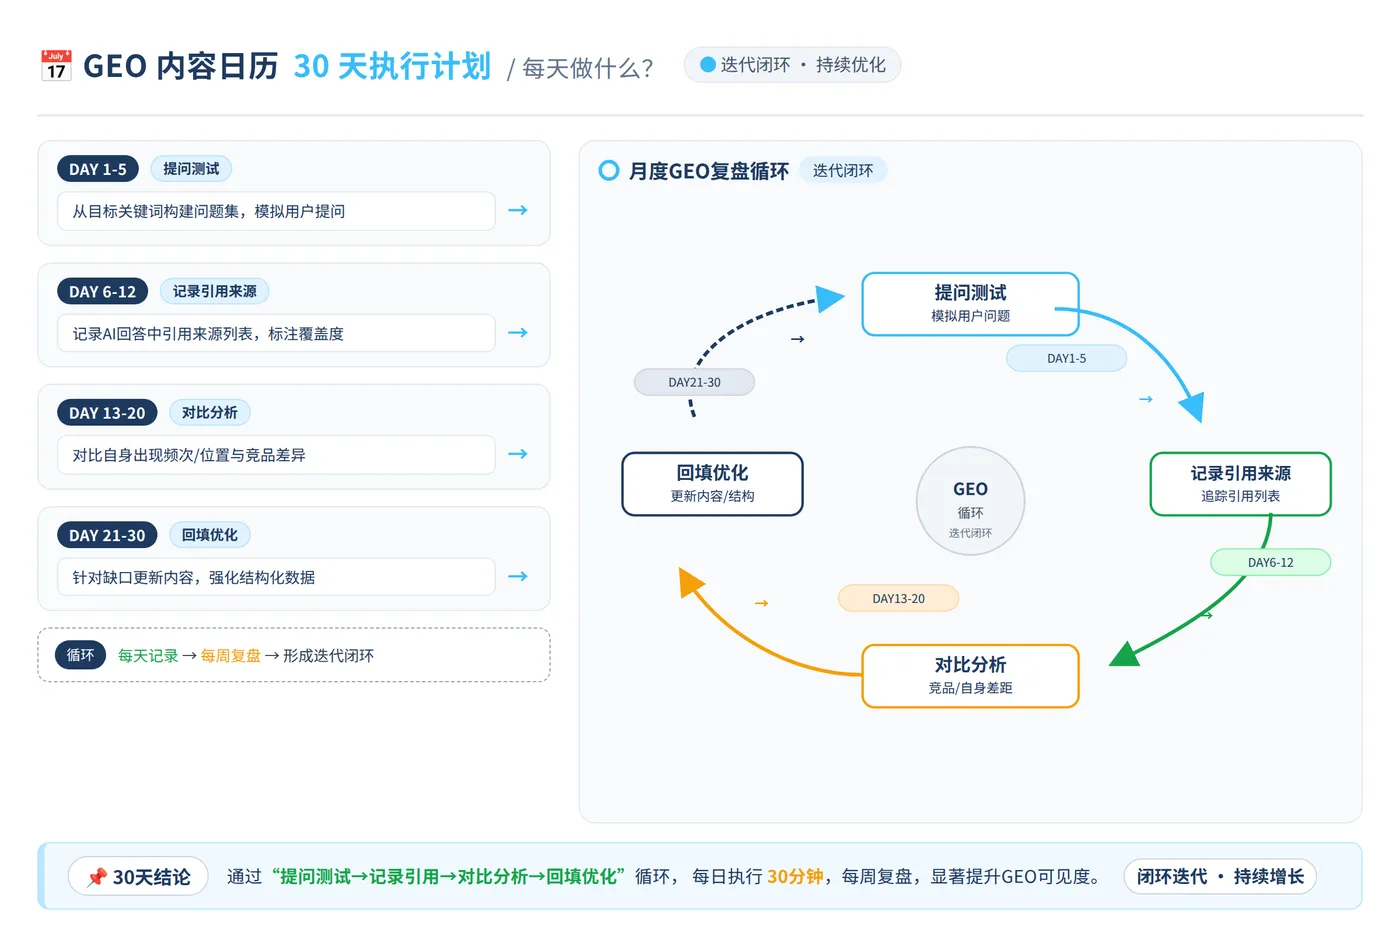
六、30天执行计划汇总
| 阶段 | 时间 | 核心动作 | 关键指标 | 避免事项 |
| 答案库定位 | 第1周 | 收集真实问题、盘点AI引用来源 | 答案库存数量(10-20个) | 关键词搜索量、排名变化 |
| 存量重构 | 第2周 | 三步改造旧内容为可引用语料块 | 可引用段落率≥30% | 大量删旧文、全站重写 |
| 新语料生产 | 第3周 | 生产对比文、FAQ库、数据页 | 新内容可引用段落占比 | 每日发布数量、字数KPI |
| 验证迭代 | 第4周 | 五大AI引擎引用复测、差异分析 | 核心问题引用次数 | 泛流量、域名权重 |
七、总结
30天AI搜索优化执行计划的核心逻辑,是围绕生成式引擎的引用机制构建一套可迭代的内容生产体系。第1周的答案库定位明确了「回答什么问题」,第2周的存量重构解决了「现有内容如何被引用」,第3周的新语料生产补充了「AI偏好的内容形态」,第4周的监控机制则建立了「持续被引用的保障」。四个阶段环环相扣,最终形成从问题定位、内容改造、语料生产到效果验证的完整闭环。
整个周期中唯一需要关注的核心指标,是自身内容在AI答案中的出现频率。这一指标不受外链数量、域名权重等传统搜索因素影响,完全取决于内容是否具备结论明确、数据支撑、来源清晰三个特征。普林斯顿大学论文的实测数据已给出明确的优化方向——引用权威来源、加入统计数据、直接说清结论,三项操作的引用率提升分别为34.4%、32.1%和29.7%。将这些机制内化为内容生产的标准动作,即可在30天内建立可验证的AI搜索可见性。
如果你也在推进AI搜索优化相关工作,欢迎在评论区分享你的实践经验。