
在大模型私有化部署、深度学习训练、AIGC图像视频生成、科学仿真计算等场景中,GPU云服务器已经成为开发者与企业最常用的弹性算力底座。自研大模型微调、本地私有推理服务、AI绘画、视频生成任务,对显存带宽、FP16/FP8算力、网络吞吐都有着硬性要求,很多新手在选型阶段很容易混淆共享vGPU与物理独占GPU、不同实例族的硬件差异,同时对按量计费、月付、包年、节省计划的实际支出预估偏差极大,经常出现选卡不当造成显存溢出、高峰算力不足、长期使用成本超预期等问题。本文将梳理主流GPU实例完整配置规格、明细计费标准,同时附上标准化基准测评方案、可直接运行的测试脚本,结合私有化大模型部署场景做横向对比,帮助使用者快速匹配训练、推理、渲染等业务,控制算力开支。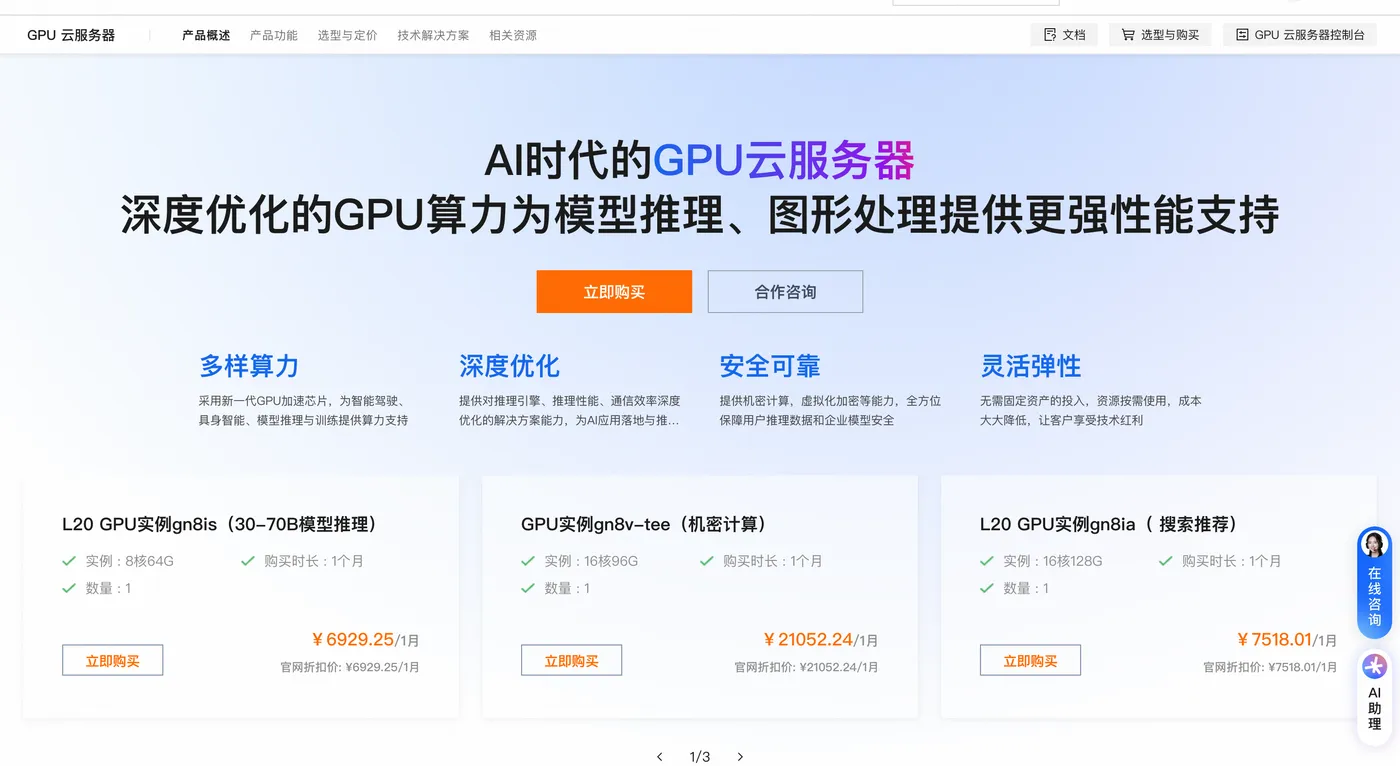
阿里云GPU云服务器,分为物理独占GPU实例、vGPU共享可视化实例两大品类,主流规格族包含gn7(T4)、gn7i(A10)、gn6v(V100)、gn8is、gn8v-tee以及sgn7i-vws共享vGPU系列,不同规格族搭载的NVIDIA加速卡、显存容量、显存带宽、算力规格、CPU内存配比差异明显,直接决定适配场景与最终租金成本。其中T4主打高并发轻量推理、视频转码、简单AI绘画;A10作为均衡主力,24GB显存适配中等规模大模型微调、SDXL、多模态推理;V100凭借HBM高带宽与NVLink互联,适合传统深度学习训练、科研仿真;A100高显存HBM版本面向超大规模基座模型预训练、多卡分布式训练场景;sgn7i-vws这类vGPU实例则支持显存切分,适合多人云工作站、轻量小模型测试,适合预算有限的前期原型验证。
先梳理主流实例核心硬件参数与收费口径,计费体系分为按量计费(小时结算)、包月、包年三大基础模式,叠加节省计划、预留实例券、新用户特惠折扣,不同计费模式价差明显。按量计费适合短期测试、临时模型验证、阶段性任务,用完即释放,无最低消费;包月适合稳定运行的常态化推理服务;包年长期使用单价最低,适合企业持续训练、长期私有化部署。vGPU共享实例价格远低于独占物理卡,但显存与算力按比例切分,不适合大规模模型训练,仅适合轻量演示、可视化设计、小型Demo调试。
以行业最常用几款实例作为参考:阿里云GPU云服务器,gn7系列搭载T4 16GB GDDR6,典型规格8核32G搭配单卡,适合RAG知识库、对话模型高并发推理、短视频转码;gn7i系列A10 24GB GDDR6X是大模型私有化落地最热门选型,16核60G单卡版本可承载FP8量化后的DeepSeek、千问系列模型本地推理与小参数微调;gn6v搭载V100 32GB HBM,自带NVLink互联能力,多卡组网适合中小基座模型训练;A100高显存规格拥有80GB HBM2e,显存带宽优势显著,面向超大规模MoE模型、多卡分布式训练场景;sgn7i-vws共享实例可以把一张A10切分为1/12、1/6、1/3显存份额,适合单人临时测试,成本门槛更低,但算力资源存在争抢,负载拉高后延迟会明显上升。
阿里云GPU云服务器,测评环节会围绕AI业务最关心的四项指标开展:显存承载上限、FP16/FP8推理吞吐、单轮首包延迟、多轮长上下文稳定性,同时实测磁盘IO与内网带宽,这些指标直接决定大模型部署后的体验。测评环境统一选用Ubuntu 22.04 LTS官方GPU优化镜像,预装NVIDIA CUDA Toolkit、cuDNN、vLLM推理引擎,关闭不必要后台服务,保证基准测试公平。在正式跑分之前,先执行基础环境校验命令,确认GPU硬件驱动、CUDA识别正常,这一步也是绝大多数用户部署模型前必做的自检步骤:
# 查看GPU硬件、驱动版本、显存信息
nvidia-smi
# 查看CUDA版本
nvcc -V
# 检测NVIDIA容器工具包,后续docker部署推理服务依赖
nvidia-container-cli info
nvidia-smi正常输出显卡型号、显存、驱动版本,代表底层硬件环境就绪;如果提示无法识别GPU,需要更换GPU专用镜像或者重新安装匹配版本驱动,普通通用镜像经常出现驱动缺失问题。
接下来执行显存带宽与算力基准测试,使用nvidia-smi自带监控+cuda-sample工具做算力跑分,同时用vLLM加载量化模型做真实业务场景吞吐测试,相比单纯理论TFLOPS,真实模型推理吞吐更贴近私有化部署的实际体验。下面是vLLM启动DeepSeek-V4-Pro FP8量化模型、开展推理吞吐压测的可复用命令,也是本次测评的核心测试脚本:
# 安装vLLM高性能推理引擎
pip install vLLM --upgrade
# 启动FP8量化DeepSeek-V4-Pro推理服务,开启日志输出用于性能统计
vllm serve ./deepseek-v4-pro-fp8 \
--host 0.0.0.0 \
--port 8000 \
--quantization fp8 \
--max-model-len 131072 \
--tensor-parallel-size 1 \
--log-requests
# 新开终端,使用curl发送批量测试请求,统计首token延迟与吞吐
curl http://127.0.0.1:8000/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model":"deepseek-v4-pro",
"messages":[{"role":"user","content":"详细解释MoE混合专家模型原理,附带伪代码实现"}],
"temperature":0.3,
"max_tokens":2048,
"stream":true
}'
实测结果可以总结出清晰选型边界:T4适合轻量、高并发短文本推理,FP8量化小模型吞吐稳定,但16GB显存难以承载大尺寸MoE模型,容易出现OOM显存溢出;A10 24GB是性价比平衡点,FP8量化后可以流畅运行主流大模型私有化推理,适合绝大多数开发者自建私有API、对接Chatbox、Codex、Qoder CN等AI工具;V100 HBM显存带宽优势在训练任务中明显,多卡NVLink组网时分布式训练效率提升显著;A100在超长上下文、大规模预训练场景优势突出,但单价偏高,适合企业级重度训练场景;vGPU共享实例在单用户低负载下表现尚可,多并发高负载时算力争抢明显,不适合生产环境正式对外提供模型服务。
磁盘与网络测评同样不可忽视,很多用户只关注GPU算力,忽略云盘IO与内网带宽,导致模型加载缓慢、多卡训练通信瓶颈。推荐搭配ESSD云盘存放模型权重文件,高速云盘可以大幅减少大模型初次加载耗时;多卡分布式训练场景,优先选择高带宽实例,保证卡间通信效率,避免NVLink/PCIe链路之外的网络拖慢训练速度。可以用下面命令测试ESSD云盘读写性能:
# 测试云盘顺序读写性能,评估模型权重加载速度
dd if=/dev/zero of=/mnt/data/testfile bs=1G count=1 oflag=direct
dd if=/mnt/data/testfile of=/dev/null bs=1G count=1 iflag=direct
在成本测算与计费避坑方面,很多使用者会忽略几个隐性支出项:云盘费用、公网流量费、弹性网卡费用、快照备份费用,这些项目不会包含在GPU实例基础租金内,长期使用会累积不少开支。按量计费模式适合临时测评、短期调优,任务结束务必及时释放实例,持续挂机将持续计费;如果确定长期稳定运行,优先对比包月、包年搭配节省计划,相比直接按量长期运行可以显著降低成本;新用户专属特惠额度适合前期测试,但特惠资源配额、地域库存有限,且特惠实例不支持迁移,到期后自动转为标准价格,需要提前规划业务迁移。同时区分清楚节省计划与预留实例券的适用场景,节省计划适合负载波动较大、无法预估长期资源占用的业务,预留实例券适合固定规格、7×24小时持续运行的稳定训练推理服务。
针对不同人群给出选型推荐清单:个人开发者、独立工程师做模型Demo、本地私有化推理、AI绘画,优先选择gn7i A10单卡实例,按量计费短期测试,业务稳定后切换包月;中小研发团队搭建私有大模型API、RAG知识库、内部代码助手,A10是首选,搭配vLLM做推理加速,对接各类OpenAI兼容客户端;科研团队、AI企业做模型微调、基座训练,优先V100或者A100多卡机型,利用NVLink提升分布式训练效率;设计、可视化、轻度演示场景,预算有限的前提下可以选用sgn7i-vws vGPU共享实例,仅用于原型演示,不建议承载线上正式推理业务。
日常运维与故障排查也是 阿里云GPU云服务器,GPU实例使用中的高频需求,常见问题集中在显存溢出、驱动版本不匹配、多卡并行报错、推理延迟突增。显存溢出优先采用模型量化(FP8/INT4)、调低max-model-len、拆分长上下文;驱动报错优先使用官方GPU预装镜像,不要手动随意升级CUDA版本;推理延迟波动大,排查是否存在磁盘IO瓶颈、公网带宽拥堵、后台快照备份抢占资源。日常监控可以通过nvidia-smi定时采集显存、GPU利用率数据,也可以接入云监控面板设置利用率告警,避免空载持续挂机浪费算力资金。
# 持续监控GPU利用率、显存占用,实时观测负载
watch -n 1 nvidia-smi

整体测评总结来看,阿里云GPU云服务器,的产品矩阵覆盖从轻量共享vGPU到旗舰多卡训练卡,适配从个人Demo验证、私有化大模型推理、AIGC生成到大规模分布式训练的全场景需求。选型核心逻辑不是盲目选择最高规格显卡,而是先明确业务是训练还是推理、模型量化后显存占用、预期并发量与运行周期,再结合按量/包月/包年的计费方案做成本测算。对于大多数想要搭建私有DeepSeek、千问推理服务,对接各类AI编程工具、可视化对话客户端的开发者,A10 24GB单卡实例综合性价比最高,能够兼顾显存容量、推理吞吐与租赁成本,是落地私有化AI应用的主流选择;而超大规模训练任务,再考虑升级V100、A100等高带宽HBM机型。在开通实例之后,优先用本文提供的基准脚本完成GPU环境自检、算力吞吐实测、云盘性能验证,提前发现硬件、驱动、网络层面的隐患,避免上线后出现推理卡顿、显存溢出、成本失控等问题。
