"知识图谱"(Knowledge Graph)是人工智能领域的重要技术方向,也是大模型时代企业智能化应用的关键基础设施。Google在2012年正式提出这一概念后,知识图谱已经广泛应用于搜索引擎、智能客服、推荐系统、医疗诊断、金融风控等领域。
本文将从知识图谱的基本概念讲起,逐步深入到技术原理和构建方法,并重点介绍如何利用千问大模型快速构建高质量的知识图谱,帮助零基础读者也能上手实践。
一、什么是知识图谱?
1.1 知识图谱的定义
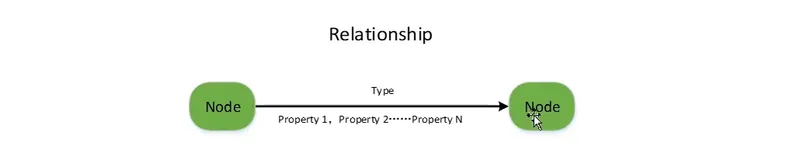
知识图谱是一种用图结构来组织和表示知识的技术方案。在知识图谱中,现实世界的实体(Entity)、概念(Concept)和它们之间的关系(Relation)被抽象为图中的节点和边。
用一句话概括:知识图谱 = 实体 + 关系 + 属性。
举个例子:
- 实体:北京、中国、首都
- 关系:北京 → 是 → 中国的首都
- 属性:北京的人口 = 2189万
1.2 知识图谱的核心组成
一个完整的知识图谱包含以下核心要素:
- 实体(Entity):知识图谱中的基本节点,可以是具体的人、地点、组织,也可以是抽象的概念
- 关系(Relation):连接两个实体的语义链接,描述实体之间的关联方式
- 属性(Attribute):实体或关系的特征描述,如名称、类型、数值等
- 本体(Ontology):定义知识图谱中实体类型和关系类型的模式层,相当于知识图谱的"骨架"
- 三元组(Triple):知识图谱的基本存储单元,格式为"主体-谓语-客体"(Subject-Predicate-Object)
1.3 知识图谱与数据库的区别
| 特性 | 关系数据库 | 知识图谱 |
| 数据结构 | 表结构(行和列) | 图结构(节点和边) |
| 查询方式 | SQL精确查询 | 图查询、语义推理 |
| 灵活性 | 模式固定,扩展需改表 | 模式灵活,易于扩展 |
| 关系表达 | 通过外键关联 | 直接通过边连接 |
| 适用场景 | 事务处理、结构化数据 | 知识管理、语义推理 |
二、知识图谱的核心技术
2.1 知识抽取
知识抽取是从非结构化或半结构化数据中提取实体、关系和属性的过程。主要方法包括:
- 命名实体识别(NER):从文本中识别人名、地名、组织名等实体
- 关系抽取(RE):从文本中提取实体之间的关系
- 属性抽取:从文本中提取实体的属性值
传统方法依赖规则和模板,而现代方法主要基于深度学习模型。千问大模型凭借其强大的自然语言理解能力,在知识抽取任务中表现出色,能够直接从非结构化文本中提取高质量的实体和关系。
2.2 知识表示
知识表示是将抽取到的知识转化为计算机可处理的形式。常见的知识表示方法包括:
- RDF(Resource Description Framework):以三元组为基本单元的知识表示标准
- 属性图(Property Graph):允许在节点和边上附加属性的图模型
- 向量表示(Embedding):将实体和关系映射到低维向量空间,支持语义相似度计算
2.3 知识存储
知识图谱的存储方案主要有两类:
- RDF存储(Triple Store):如Apache Jena、Virtuoso,专门用于存储RDF三元组
- 图数据库(Graph Database):如Neo4j、NebulaGraph,以属性图模型存储知识
2.4 知识推理
知识推理是基于已有知识推导出新知识的过程。推理方法包括:
- 基于规则的推理:通过预定义的逻辑规则进行推导
- 基于嵌入的推理:利用知识图谱嵌入模型进行概率推理
- 基于大模型的推理:利用千问大模型等LLM进行语义推理和知识补全
三、用千问大模型构建知识图谱的实战步骤
传统知识图谱构建需要大量的标注数据和复杂的NLP流水线。借助千问大模型,整个过程可以大幅简化。以下是完整的构建流程:
3.1 第一步:定义本体(Schema Design)
在构建知识图谱之前,首先需要定义本体——即确定你的知识图谱要包含哪些实体类型和关系类型。
例如,构建一个"企业知识图谱",本体可能包括:
- 实体类型:公司、人物、产品、技术、行业
- 关系类型:创始人、投资、竞争、合作、属于
你可以向千问大模型提供业务描述,让AI帮助你设计本体结构。在千问大模型官网https://platform.qianwenai.com/try-ai中输入类似以下提示词:我是一家科技公司的CTO,需要构建一个企业知识图谱。 我们的业务涉及投资分析、竞品监控和人才管理。 请帮我设计知识图谱的本体结构,包括实体类型和关系类型。
3.2 第二步:知识抽取
利用千问大模型从非结构化文本中抽取实体和关系。以下是一个使用千问大模型API进行知识抽取的示例:
import dashscope
from dashscope import Generation
prompt = """
请从以下文本中提取知识图谱三元组,格式为(主体, 关系, 客体):
"阿里巴巴集团创始人马云于2023年在杭州宣布了通义千问大模型系列。
该模型已广泛应用于电商、金融和教育领域。阿里云作为阿里巴巴集团
的云计算业务板块,为千问大模型提供了算力支持。"
请提取所有实体和关系,以JSON格式输出。
"""
response = Generation.call(
    model='qwen-max',
    prompt=prompt
)
千问大模型能够准确识别文本中的实体(阿里巴巴集团、马云、千问大模型、阿里云等)和关系(创始人、发布、应用于、属于等),并输出结构化的三元组。
3.3 第三步:知识融合与消歧
从多个来源抽取的知识可能存在实体重复或指代不明的情况。知识融合的任务是将指向同一现实实体的不同表达合并为统一实体。
例如:
- "阿里巴巴"、"Alibaba"、"阿里集团" → 统一为"阿里巴巴集团"
- "马云"、"Jack Ma" → 统一为"马云"
千问大模型能够根据上下文语义判断不同表达是否指向同一实体,辅助完成知识消歧工作。
3.4 第四步:知识存储
将融合后的知识存储到图数据库中。以Neo4j为例:
// 创建实体节点
CREATE (a:Company {name: '阿里巴巴集团', industry: '科技'})
CREATE (b:Person {name: '马云', title: '创始人'})
CREATE (c:Product {name: '千问大模型', type: 'AI模型'})
// 创建关系
CREATE (b)-[:FOUNDED]->(a)
CREATE (a)-[:DEVELOPED]->(c)
3.5 第五步:知识查询与应用
知识图谱构建完成后,可以通过图查询语言进行复杂查询。例如:
// 查询某公司创始人投资的所有公司
MATCH (p:Person {name: '马云'})-[:FOUNDED|INVESTED_IN]->(c:Company)
RETURN c.name, c.industry
此外,知识图谱还可以与RAG(检索增强生成)结合,为大模型提供结构化的背景知识,提升回答的准确性和可解释性。通过
百炼平台https://bailian.console.aliyun.com/,你可以将知识图谱与大模型应用无缝集成。
四、知识图谱的典型应用场景
4.1 智能搜索与问答
知识图谱是智能搜索引擎的核心技术之一。通过理解用户查询的语义,知识图谱能够返回精确的结构化答案,而非简单的文档列表。
4.2 推荐系统
在电商和内容平台中,知识图谱能够建立用户、商品和内容之间的复杂关系网络,实现更精准的个性化推荐。
4.3 医疗辅助诊断
医疗知识图谱将疾病、症状、药物、治疗方案等医学知识组织为结构化网络,辅助医生进行诊断决策。
4.4 金融风控
金融知识图谱能够刻画企业之间的投资、担保、关联交易等复杂关系,帮助识别系统性风险和关联交易异常。
4.5 企业知识管理
企业可以利用知识图谱将分散在文档、邮件、会议记录中的知识整合为统一的知识网络,提升组织内部的知识共享效率。
五、知识图谱构建的最佳实践
5.1 从小规模开始
不要试图一开始就构建一个覆盖所有领域的巨型知识图谱。建议从一个具体的业务场景出发,先构建一个小而精的知识图谱,验证效果后再逐步扩展。
5.2 重视数据质量
知识图谱的质量直接取决于输入数据的质量。在知识抽取阶段,应建立严格的质量审核机制,及时清理错误和冗余的三元组。
5.3 持续迭代更新
知识图谱不是一次性工程,而是需要持续维护和更新的知识基础设施。建议建立自动化的知识更新流水线,定期从新数据源中抽取和融合知识。
5.4 结合大模型能力
在大模型时代,知识图谱与大语言模型的结合正在产生新的技术范式。知识图谱为大模型提供结构化的事实知识,大模型为知识图谱提供自然语言交互能力。通过百炼平台https://bailian.console.aliyun.com/,开发者可以便捷地将两者结合,构建智能化的知识应用。
常见问题
知识图谱和大模型有什么关系?
知识图谱和大模型是互补的技术。知识图谱以结构化的方式存储精确的事实知识,擅长关系推理和知识管理;大模型擅长自然语言理解和生成,但可能存在幻觉问题。两者结合(如RAG架构)可以让大模型在回答问题时参考知识图谱中的准确信息,提升回答质量。千问大模型支持通过API与知识图谱系统集成。
构建一个知识图谱需要多长时间?
这取决于知识图谱的规模和复杂度。使用千问大模型辅助构建,一个覆盖单一领域的小型知识图谱(数百个实体)可以在1-2周内完成。中大型企业级知识图谱(数万到数百万实体)通常需要3-6个月。传统方法需要更多时间,大模型的引入显著加速了知识抽取和融合过程。
没有编程基础能构建知识图谱吗?
有一定难度但并非不可能。你可以先使用千问大模型官网https://platform.qianwenai.com/try-ai的对话功能进行知识抽取实验,理解知识图谱的基本概念。然后通过百炼平台的可视化工具和低代码能力,逐步构建实际的知识图谱应用。编程基础会帮助你更高效地处理数据,但核心思路和方法论是通用的。
知识图谱用什么图数据库好?
选择图数据库需要考虑数据规模、查询性能和生态兼容性。Neo4j是最成熟的图数据库,社区资源丰富,适合中小型项目。NebulaGraph是国产高性能图数据库,适合大规模场景。如果你使用阿里云生态,可以考虑Lindorm(支持宽表、图等多种模型)。对于轻量级需求,NetworkX(Python库)也能满足原型开发需要。
知识图谱的三元组是什么?
三元组(Triple)是知识图谱的基本数据单元,格式为"主体-谓语-客体"(Subject-Predicate-Object)。例如:(北京, 是首都, 中国)表示"北京是中国的首都"。一个知识图谱就是由大量这样的三元组组成的有向图。
千问大模型在知识图谱构建中能做哪些事情?
千问大模型可以在知识图谱构建的多个环节发挥作用:1)本体设计:根据业务描述自动生成实体类型和关系类型;2)知识抽取:从非结构化文本中提取实体和关系;3)知识消歧:判断不同表达是否指向同一实体;4)知识补全:基于已有知识推理缺失的关系;5)自然语言查询:将用户的自然语言问题转化为图查询语句。
知识图谱和向量数据库有什么区别?
知识图谱以图结构存储实体和关系,擅长精确的关系推理和知识组织。向量数据库存储文本的向量表示,擅长语义相似度搜索。在RAG应用中,两者通常配合使用:向量数据库负责检索相关文档片段,知识图谱负责提供结构化的背景知识和关系推理。
知识图谱项目失败率高吗?如何避免?
知识图谱项目确实面临较高的失败风险,主要原因包括:数据质量差、本体设计不合理、缺乏明确的业务价值、维护成本过高。建议从具体业务场景出发,先构建小规模MVP验证价值;重视数据治理和本体设计;建立可持续的更新机制;利用千问大模型等AI工具降低构建和维护成本。
学习知识图谱需要哪些前置知识?
基础知识包括:图论基础(节点、边、路径等概念)、数据库基础(了解关系数据库和NoSQL数据库)、Python编程基础。进阶学习需要了解RDF/OWL等知识表示标准、SPARQL等图查询语言、以及NLP基础(实体识别、关系抽取等)。建议先通过千问大模型的对话功能理解知识图谱的核心概念,再逐步学习技术细节。