一.概述
本文以我个人搭建的房源检索服务为例,详细叙述了如何使用阿里云的 DashVector 产品实现“带有关键词感知的向量检索”。关于“关键词感知的向量检索”具体说明可以参见阿里云官方文档,这里仅对文档中没有详细叙述的实际操作过程进行补充。
二.操作过程
2.1 DashVector API-KEY 申请
登录 阿里云向量检索服务 DashVector 控制台 点击创建 api-key申请。注意:关闭后不可复制

2.2 创建 Cluster
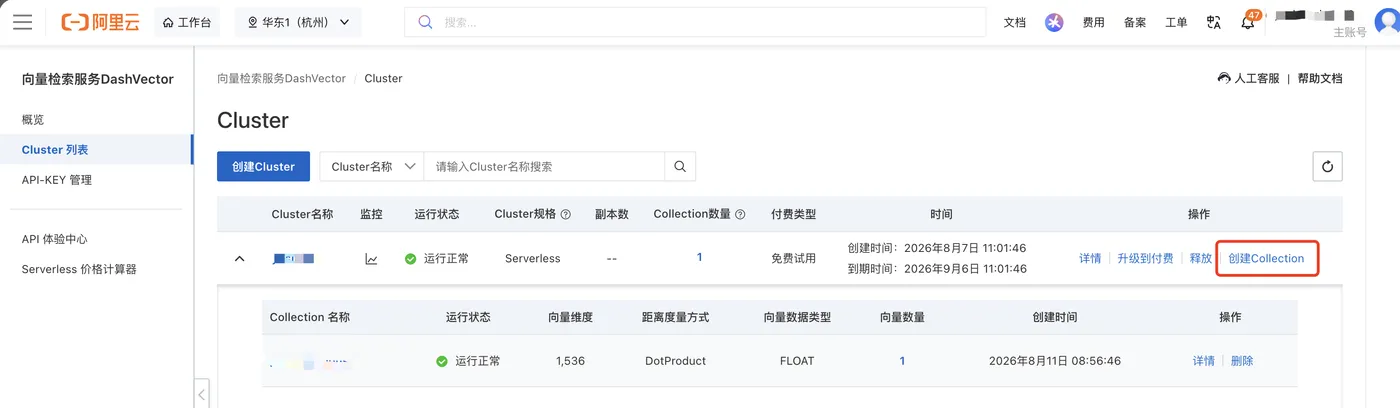
创建集群(可以类比成关系型数据库里的一个数据库),阿里云会给一定的免费额度供练习使用。

2.3 创建collection
可以类比成关系型数据库的一个表
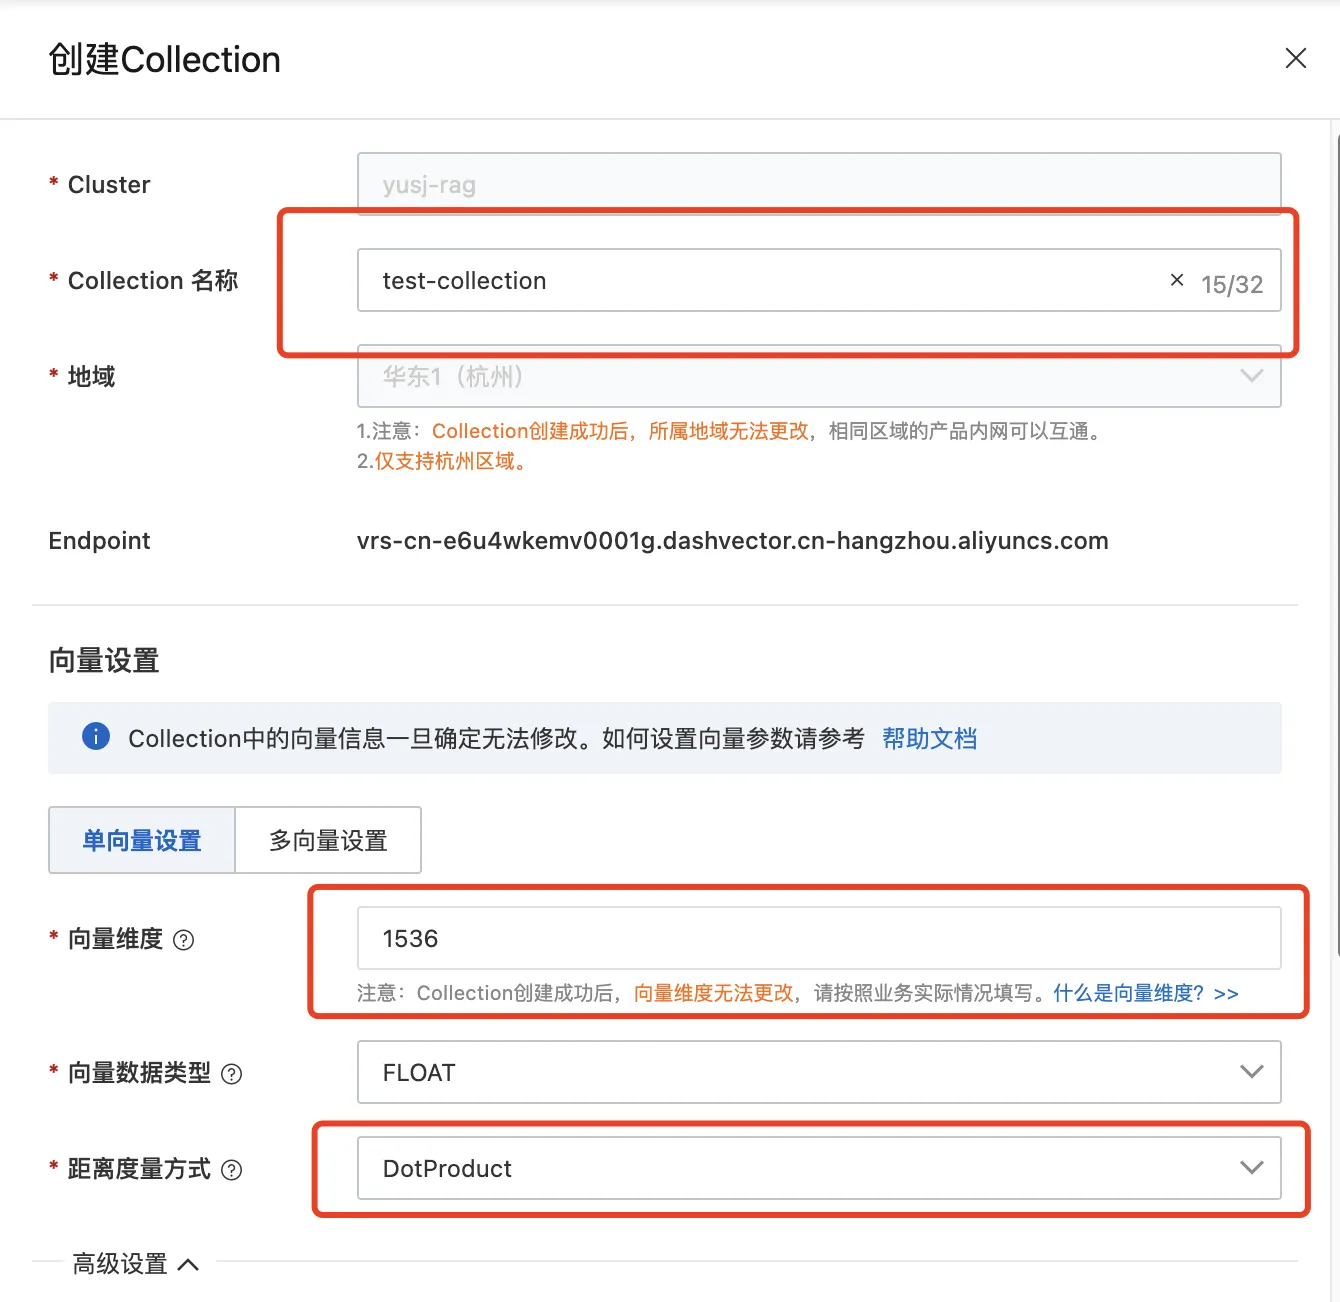

- collection 名称:集合的名称。
- 向量维度:1536 这个跟我们进行 稠密向量生成的Embedding模型有关,我使用的是qwen3.7-text-embedding 支持 1536 维度(因为有免费额度-。-)关于向量维度的更多说明,可以参考官方文档。
- 距离度量方式:这里要注意一定要选 DotProduct 只有 DotProduct 模式才支持稀疏向量和稠密向量混合检索,也就是所谓的关键词感知检索。
- 自定义 schema :向量数据库在存储向量数据的同时,给用户一定自由度扩展一些字段来存储额外的数据。例如这里我存储了一个 id.代表我的房源主键。自定义 shcema 的作用有两个,一个是信息检索结果中会附带这些信息使用比较方便。另外,DashVector 的检索接口支持通过这些 schema做条件查询。
所以我们创建完成的 collection 的一条数据的结构如下:
{
  id:向量数据的主键,
  vector:稠密向量数据用于语义召回,
  sparse_vector:稀疏向量用于关键词匹配,
  fields:{我们额外定义的其他字段key:value 格式}
}
我们在向 collection 中注入数据的时候,也需要按这种形式组织数据,先用 embeding 模型生成 vector ,再用对应的稀疏向量生成工具 DashText 生成稀疏向量,在拼接上我们自定义的 fields 存储到 collection.
检索时,我们将 关键词 同样处理成,稠密和稀疏向量,进行匹配召回就可以了。召回的信息中,会附带我们自己的 fields.这样就召回了我们提前预定的关键信息。
2.4 生成及插入向量数据
- 我的原始数据格式 house_vectors.json 这里我希望通过描述信息,召回对应房源 id 即可,所以 schema 中仅定义了一个 id.
[
  {
    "id": 8208,
    "description": "标题:合租Emerald Park主人房双人床有窗,业务类型:合租,房屋类型:主人房,房产类型:公寓,价格:2500$/月,户型/房间数:5,床型:双人床,付款方式:月付,有窗:有窗,置顶:否,是否已满:未满,归属建筑:Emerald Park,地址:2 Indus Rd #06-09, Emerald Park condominium, Singapore 169586,邮编:169586,状态:已发布,认证:否,归属品牌:homey,归属人:eight,发布时间:2026-05-23,房源描述:中心地段,新地铁线,外籍人士吸引力强,近河畔生活方式,租赁需求旺盛,英文原文描述:Central location, new MRT line, strong expat appeal, near river lifestyle, high rental demand,备注:来源: Homey 批量导入,周边:地铁站:Havelock、Tiong Bahru、Great World、Redhill、Orchard;学校:RCHE 新加坡莱佛士高等教育、AMITY 新加坡阿密提国际学院、新加坡管理大学、南洋艺术学院、LASALLE 拉萨尔艺术学院"
  }
]
- 生成 稠密及稀疏向量 到 output_vectors.json
# pip install dashvector,dashtext,openai

import os
from openai import OpenAI
# 建立 DASHSCOPE_API_KEY 客户端,使用阿里云百炼平台的大模型服务,做 embeding
client = OpenAI(
    api_key='阿里云百炼平台的 api-key,可以去百炼平台申请',
    base_url="阿里云百炼平台的 api 请求地址"
)

# 使用 dashtext 生成稀疏向量
from dashtext import SparseVectorEncoder
encoder = SparseVectorEncoder.default()# 暂时先使用 内置 encoder ,不用自己的语料库训练。后续再用自己的语料库。


import json
vectors = []
with open('./house_vectors.json','r') as f:
    house_list = json.load(f)
    for house in house_list:
        # 使用 qwen3.7-text-embedding 生成稠密向量
        completion = client.embeddings.create(
            model="qwen3.7-text-embedding",
            input=house['description'],
            dimensions=1536,  # 指定向量维度 需要与 collection 保持一致,
        )
        #id
        id = house['id']
        # 稀疏向量
        doc_sparse_vector = encoder.encode_documents(house['description'])
        # 稠密向量
        doc_dense_vector = completion.data[0].embedding;
        vectors.append({
            "id":id, # 直接使用房源主键作为向量数据主键。
            "vector":doc_dense_vector,
            "sparse_vector":doc_sparse_vector
        })

# vector 输出到文件
# 写入 JSON 文件
with open('output_vectors.json', 'w', encoding='utf-8') as f:
    json.dump(vectors, f, ensure_ascii=False, indent=2)  # indent 使输出可读
- 将生成的 output_vectors.json 上传到 collection(这里其实也可以直接将上一步生成的数据直接调用接口存储到 collection,我这里只是多存储了一份中间文件)
import json
from dashvector import Doc

with open("./output_vectors.json", "r") as f:
    list = json.load(f)
    for data in list:
        response = collection.insert(Doc(
            id=str(data['id']),
            vector=data['vector'],
            sparse_vector={int(k): v for k,v in data['sparse_vector'].items()},# key 必须为 int
            fields={'id':data['id']} #注意这里传入的 字段 才是 collection schema 中定义的
        ))
    print('insert doc success!--')
    print(response)# 处理结果。上传可能会失败,我们可以通过这个 response 定位问题。
上传成功后,我们在平台的 collection 中可以看到导入的数据,至此我们的向量数据处理全部完成。可以看到存储的是向量信息。

2.5 向量检索
from dashvector_client import collection
import os
from openai import OpenAI
prompt = "我想要一套合租的房源"

from dashtext import SparseVectorEncoder
encoder = SparseVectorEncoder.default()

embedding_client = OpenAI(
    api_key="百炼平台 api",
    base_url="百炼平台请求地址"
)
completion = embedding_client.embeddings.create(
        model="qwen3.7-text-embedding",
        input=prompt,
        dimensions=1536,  # 指定向量维度 需要与 collection 保持一致,
)

# 稀疏向量 注意跟向量数据存储时需要用一个向量处理工具
doc_sparse_vector = encoder.encode_documents(prompt)
# 稠密向量 注意跟向量数据存储时需要用一个向量处理工具
doc_dense_vector = completion.data[0].embedding;

response = collection.query(
    vector=doc_dense_vector,
    sparse_vector=doc_sparse_vector
)

print(response) # 匹配结果

"""
{"code": 0, "message": "Success", "requests_id": "a0a7c3fa-efe1-4958-b81a-4386b1eebd72", "output": [{"id": "8207", "sparse_vector": {"128466567": 0.5385127663612366, "3488055477": 0.5385127663612366, "575208283": 0.5385127663612366, "3987355390": 0.5385127663612366, "455390201": 0.5385127663612366, "281464262": 0.5385127663612366, "1214339364": 0.5385127663612366, "38107217": 0.5385127663612366, "2879070766": 0.5385127663612366, "645608479": 0.7778134346008301, "1713372713": 0.5385127663612366, "3272354708": 0.5385127663612366, "2090698681": 0.5385127663612366, "225251141": 0.5385127663612366, "3799633237": 0.5385127663612366, "403644754": 0.5385127663612366, "731317203": 0.5385127663612366, "4121761508": 0.5385127663612366, "522061851": 0.5385127663612366, "865949017": 0.5385127663612366, "701918430": 0.5385127663612366, "1993390424": 0.5385127663612366, "3383387916": 0.5385127663612366, "1267261184": 0.7000433206558228, "473727155": 0.5385127663612366, "2647627939": 0.5385127663612366, "947081451": 0.5385127663612366, "3843901863": 0.7000433206558228, "3369620648": 0.5385127663612366, "1055110136": 0.5385127663612366, "2745751983": 0.5385127663612366, "1697543836": 0.5385127663612366, "3666358166": 0.5385127663612366, "1586628127": 0.5385127663612366, "1127428560": 0.5385127663612366, "346084629": 0.5385127663612366, "3945479823": 0.5385127663612366, "1183495594": 0.5385127663612366, "3099554429": 0.5385127663612366, "1458777822": 0.5385127663612366, "847813810": 0.5385127663612366, "284361920": 0.7000433206558228, "3747194111": 0.5385127663612366, "1514673797": 0.7000433206558228, "336721815": 0.5385127663612366, "685796717": 0.5385127663612366, "3785871704": 0.5385127663612366, "3855781321": 0.5385127663612366, "468086265": 0.5385127663612366, "1743941834": 0.5385127663612366, "3648775104": 0.5385127663612366, "1126527455": 0.5385127663612366, "1667662100": 0.5385127663612366, "712286644": 0.5385127663612366, "1075688730": 0.5385127663612366, "4130523965": 0.5385127663612366, "3337161277": 0.5385127663612366, "3580333748": 0.5385127663612366, "2581019827": 0.5385127663612366, "3327497065": 0.5385127663612366, "2240034651": 0.5385127663612366, "115805462": 0.5385127663612366, "3863254354": 0.5385127663612366, "220702789": 0.5385127663612366, "2520262144": 0.5385127663612366, "1564619016": 0.5385127663612366, "4281202855": 0.5385127663612366, "734978415": 0.5385127663612366, "1112844949": 0.5385127663612366, "2339710845": 0.5385127663612366, "1013716996": 0.5385127663612366, "1175131894": 0.5385127663612366, "2858950494": 0.5385127663612366, "4167657730": 0.7000433206558228, "1494060852": 0.5385127663612366, "2019564631": 0.5385127663612366, "1207638572": 0.5385127663612366, "65259376": 0.5385127663612366, "876119480": 0.5385127663612366, "697108202": 0.5385127663612366, "202257423": 0.5385127663612366, "2194918771": 0.5385127663612366, "1339242251": 0.5385127663612366, "1487858779": 0.5385127663612366, "3222452068": 0.5385127663612366, "1134386733": 0.5385127663612366, "3647405936": 0.5385127663612366, "1464895919": 0.5385127663612366, "3936322322": 0.7778134346008301, "4044102612": 0.7778134346008301, "3615541420": 0.5385127663612366, "3723151830": 0.5385127663612366, "2231074495": 0.5385127663612366, "2411973761": 0.7778134346008301, "3231553877": 0.5385127663612366, "2683328673": 0.5385127663612366, "497817439": 0.5385127663612366, "2494961552": 0.5385127663612366, "761498890": 0.5385127663612366, "2218935709": 0.5385127663612366, "1510475518": 0.7000433206558228, "3600691560": 0.5385127663612366, "283837043": 0.5385127663612366, "136736535": 0.5385127663612366, "2317842571": 0.5385127663612366, "2574140003": 0.5385127663612366, "2332514525": 0.5385127663612366, "3262929218": 0.7000433206558228, "789380708": 0.5385127663612366, "3311579508": 0.5385127663612366, "3016494671": 0.5385127663612366, "1583060724": 0.5385127663612366, "2319023830": 0.5385127663612366, "3317400086": 0.5385127663612366, "984329144": 0.5385127663612366, "1831503944": 0.7000433206558228, "2526992654": 0.5385127663612366, "3675741289": 0.5385127663612366, "65439743": 0.5385127663612366, "2935470936": 0.7000433206558228, "1619558971": 0.5385127663612366, "849976065": 0.7000433206558228, "509970187": 0.5385127663612366, "921598042": 0.5385127663612366, "1802189524": 0.5385127663612366, "3943043189": 0.7000433206558228, "1647979225": 0.5385127663612366, "3925402570": 0.5385127663612366, "1723027408": 0.8536843061447144}, "fields": {"vector": null, "id": 8207, "sparse_vector": null}, "score": 1.5299}]}
"""
三.注意事项及总结
- 文中使用的阿里云百炼平台的 api-key 和 api 地址,需要去 百炼平台 提前申请。
- 检索及存储向量时,要使用相同的向量处理模型和工具,注意向量维度也要保持一致。
- 稠密向量维度要与 collection 中定义的保持一致。
参考资料:https://help.aliyun.com/document_detail/2586282.html?spm=a2c4g.11174283.0.0.71af582bNPgka4