
💡 一句话总结:PaDoc 把端到端文档解析的解码图从「一条长链」改成「布局串行规划 + 各区域内容并发生成」的分支树,靠祖先注意(ancestral attention)保证可见性、靠 vLLM 前缀缓存复用整页上下文——同骨干对照下吞吐翻倍、P95 延迟减半,解析质量还没掉。做文档解析或 MLLM serving 的人值得一看。
导语:先问一个可能戳到你的问题
做 RAG、做过 OCR pipeline、或者用过 MinerU 这类工具的人,大概都被同一件事折磨过:端到端的文档解析模型,准是真准,慢也是真慢。
你丢一页双栏、带三个表格两个公式的论文页进去,让它吐回整页 Markdown,它能让你等上几十秒。原因藏在它的解码方式里——它把整页的布局、阅读顺序、每段文字、每个表格、每条公式,全部展平成一条长长的自回归 token 序列,然后像一个特别认真但特别慢的抄写员,一个字一个字往外蹦。更要命的是自回归有条铁律:前一个区域没写完,后一个区域就不能动笔,哪怕右下角的广告和左上角的标题八竿子打不着,也得乖乖排队。
那想要快怎么办?传统答案是「裁剪式两阶段」——先用布局检测器把每个区域裁出来,再分别识别,区域之间天然能并行。快是快了,可副作用很要命:裁掉之后每个区域成了孤岛,看不到整页上下文,多栏阅读顺序、跨栏表格、图表标题和正文的对应关系特别容易出错;而且每个裁出来的小块都得重新跑一遍视觉编码,算力也白费。
所以问题就来了:能不能鱼和熊掌都要——既不裁剪、保留整页上下文,又能让不同区域并行解码? 快手联合北大刚放的这篇 PaDoc(arXiv:2608.06146)说,能。这篇就来聊聊它怎么做到的,以及为什么我觉得它值得做 serving 的人认真看一眼。
想自己动手试?
- 📄 论文:arXiv 2608.06146
- 💻 代码:GitHub · Longin-Yu/Padoc
- 📊 基准:OmniDocBench v1.6(业界常用的文档解析评测集)
🎯 这篇论文到底想解决什么问题?
先把「端到端文档解析为什么慢」这件事讲透。
文档解析的任务,是把一张页面图像变成结构化输出——哪些是标题、哪些是正文、阅读顺序是什么、表格怎么还原、公式怎么转写。端到端的多模态大模型(MLLM,简单说就是能同时读图和生成文字的大模型)做法,是把所有这些压成一条自回归序列一次性生成。问题在于这条序列的「关键路径长度」:布局 token 加上所有区域的内容 token,全得串成一串。
打个比方,这就像让一个抄写员抄一份多栏报纸,规定他必须从左上角第一个字一路抄到右下角最后一个字、中途不许跳着抄。哪怕第四版的股市行情表和第一版的头条毫无关系,他也得先把头条抄完才能动行情表。一页里区域越多、每个区域越长,他排队要等的时间就越久——而且这个等待是累加起来的,不是只取最慢的一个。
裁剪式两阶段绕开了串行,但代价前面说了:丢上下文、重复视觉编码。PaDoc 要回答的研究问题一句话就能说完——在一个 MLLM 里,能不能既保留完整页面上下文,又把不同区域的内容解码并行起来? 答案藏在一个朴素到几乎像废话的观察里。
🛠️ 它的思路是什么?
一个直觉:大部分时候,区域之间是「各管各的」
PaDoc 的全部巧思,建立在一个看起来像废话的假设上:一个区域里的内容,主要由它自己那一小块图像决定,跟别的区域关系不大。
第三段正文写什么,取决于第三段那块图的像素,不太取决于第五段的表格长什么样;某个公式的转写,取决于那个公式区域的图像,跟隔壁段落的文字无关。论文管这个叫「区域特定内容充分性」(region-specific content sufficiency)——听起来理所当然,但它一旦成立,整页的生成就能被重新拆解成两条流:
- 📐 布局流:按顺序吐出每个区域的位置和类型。这个必须串行,因为区域的排布有先后依赖——要知道前面区域占了哪里,才能定下一个区域的位置。
- 🔤 内容流:每个区域一条,吐出该区域的文字 / 公式 / 表格。这些可以并行,因为只要它依赖的布局已经生成完,就不用等别的区域。
再打个比方,这像装修一栋楼:先由一个「布局工」按顺序敲定每个房间的位置和用途(布局流,串行,因为他要统筹整体),某个房间一旦定好,立马派一支装修队进去施工(内容流,并行,因为各房间装修互不干扰),所有装修队共享同一张楼层平面图。
数学上,这就是把解码深度从「所有区域内容长度相加」压缩成「取最长那条布局-内容路径」:
$$ D_{\text{顺序}} = \ell(\text{布局}) + \textstyle\sum_{k}\ell(Y_k) \quad\Longrightarrow\quad D_{\text{PaDoc}} = \max_{k}\{\ell(B_{\leq k}) + \ell(Y_k)\} $$
这个公式的全部作用就是一句话:从「排队挨个来」变成「同时开工、只等最慢的那个」——这就是并行省时间的本质。
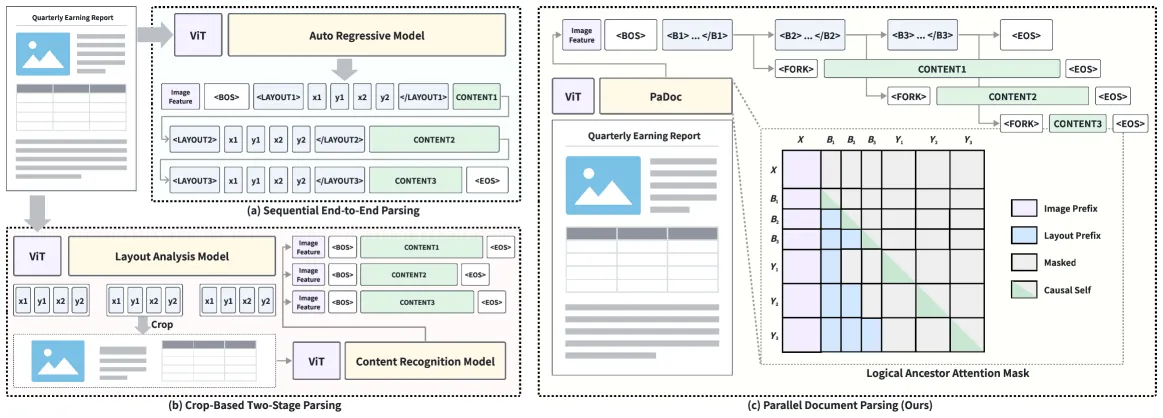
图说:三种范式对比——(a) 串行端到端把所有内容排成一条长链;(b) 裁剪式两阶段快,但每个区域成孤岛、要重复视觉编码;(c) PaDoc 在共享整页前缀上让内容流分叉并行,兼得上下文与速度。这张图是理解整篇论文动机的钥匙。
怎么让一个模型「只看自己的前缀」?
你可能会问:道理懂了,可一个自回归模型,怎么让它「生成区域 k 的内容时,只看区域 k 的布局、不看别的区域」?
答案是祖先注意(ancestral attention)——一套注意力可见性规则。简单说,每个 token 只能看到两类东西:一是它的「祖先」(页面图像 → 它所属区域的布局 → 它自己在该区域内更早的位置),二是同一区域里比它早的 token;别的区域的布局和内容,一律看不见。
更妙的是,这套规则在训练阶段就能用标准的下一令牌监督(next-token SFT,就是让模型预测下一个词的那种最普通的训练)实现,根本不用设计什么特殊损失函数——可见性掩码直接把「树形依赖」焊进了模型。他们还做了一个叫 tree-varlen(树形变长打包) 的工程实现,把这种不规则的可见性模式拼成一次标准的 FlashAttention 调用,不必存一个跟序列长度的平方成正比的巨大掩码矩阵——序列长达 16384 的时候,这个细节决定了能不能训得动。
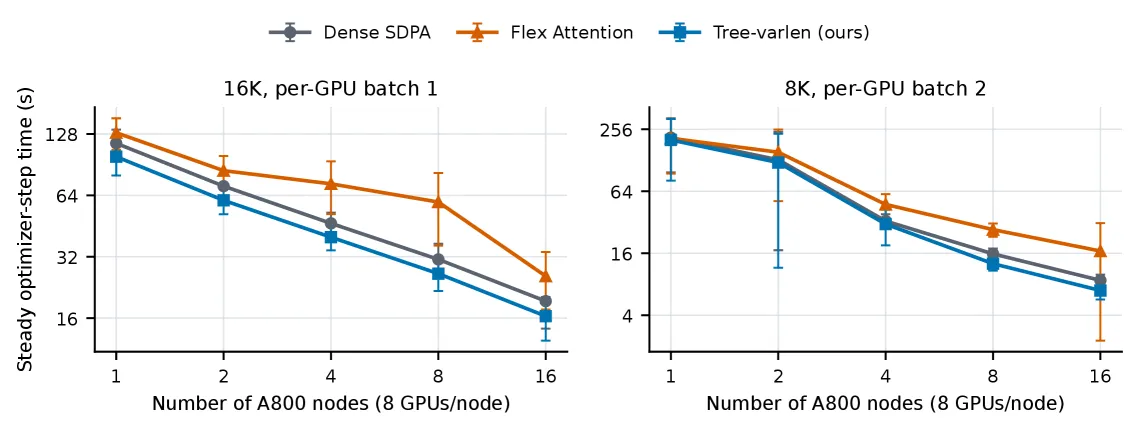
图说:三种注意力后端的训练单步耗时(越低越快)——PaDoc 用的 tree-varlen 打包最省时,因为它复用了生产级 FlashAttention、不必存稠密的二次掩码;Dense SDPA 最慢,Flex Attention 居中。
推理时:把树翻译成 vLLM 的「共享前缀多请求」
训练解决了,推理怎么并行?这里有个很漂亮的工程映射:布局流和每条内容流,被直接当成 vLLM 里的并发生成请求,它们共享的那段「图像 + 布局前缀」的 KV cache(键值缓存,注意力计算中复用的中间结果),靠 vLLM 自带的自动前缀缓存(automatic prefix caching)自动复用。
换句话说,PaDoc 不需要改任何推理内核——它把「树形并行」翻译成了推理引擎本来就擅长的「一堆请求共享前缀」场景。这一步是它能真正落地、而不是只停留在论文 demo 里的关键。
📈 效果到底怎么样?
先说结论:质量不掉,速度翻倍。 而且这个结论是用同一个骨干(Qwen3-VL-2B)对照得出来的——基线叫 Sequential SFT,和 PaDoc 用一模一样的模型、一模一样的训练数据,唯一差别就是解码图是「一条链」还是「一棵树」。这点很重要:效率上的提升可以干净地归因到方法本身,而不是靠换更大的模型刷出来的。
质量这块,在 OmniDocBench 上 PaDoc 拿到端到端解析器里顶级的分数:
- Overall 94.24——端到端解析器里最顶尖那一档(综合分,越高越好)
- Text Edit 0.038——文本编辑距离,所有方法里最佳(越低越好,代表文字识别错得最少)
- Formula CDM 95.59——公式识别准确度,最佳(越高越好)
也就是说,并行解码没有付质量代价——这正是这套方法最该被记住的卖点。
速度更直观,单张 A800、384 页测试子集上、五个并发级别的对比:
- ⚡ 吞吐量提升 67.4%–118%——拿 C16 举例,原来每秒处理 0.75 页,PaDoc 干到 1.64 页,翻了一倍多
- ⏱️ P95 延迟降低 39.2%–54.9%——长尾请求(正是 serving 最在意的指标)直接砍掉四到五成

图说:五个并发级别下的平均解析时间与 P95 延迟——PaDoc(端到端、2.1B)的曲线在端到端解析器里最低(最快),并且接近紧凑的两阶段系统(HunyuanOCR-1.5 1.0B、MonkeyOCRv2 0.7B)。收益定位是「端到端范式内部的大幅加速」,而非碾压所有范式。
一个值得注意的趋势:吞吐提升随并发升高而收窄(C16 的 +118% 一路降到 C256 的 +67%)。这其实符合直觉——并发越高、GPU 本来就越忙,并行解码能填进去的「空闲空当」越少,收益边际递减。但 P95 延迟全程稳定砍掉四到五成,对实际用户体验的改善才是最实打实的。
我倾向于把这个结果理解成:PaDoc 的收益定位是「端到端范式内部的大幅加速」——它让你不必为了速度去牺牲上下文完整性、退回裁剪式两阶段。论文也很诚实地说,它是「接近」紧凑的两阶段系统,而不是碾压所有范式。
💡 为什么你要关心?
这事跟你的关系,看你属于哪类人。
- 📚 做文档解析 / OCR / 知识库的人:这是个现成可试的 serving 加速方案。代码开源、基于 Qwen3-VL-2B(参数不大、好部署)、和 vLLM 集成,可以直接拿去压测自己的文档流。文档解析是 RAG 的第一道工序,这道工序快了、上下文又不丢(不裁剪),下游检索和生成的质量都跟着受益。
- 🚀 做 MLLM serving / 推理加速的人:换个角度看,PaDoc 真正的贡献不是「文档解析快了」,而是它示范了一套通用的结构化并行解码范式——「祖先注意 + tree-varlen 打包 + vLLM 前缀缓存」。任何输出具有「骨架 + 填充」结构的生成任务都能套这个思路:大纲与各节、JSON schema 与各字段、代码骨架与各函数体……只要「填充部分之间条件独立」这个假设大致成立,就能把串行链拆成并行树。
- 📊 关注文档智能赛道的人:文档解析的 MLLM 化是这两年最明确的趋势(MinerU、Dolphin、SmolDocling、Qianfan-OCR 一波接一波),但 serving 成本一直是落地拦路虎。PaDoc 直接砍的就是这个成本——一倍吞吐、一半延迟,对大规模文档数字化(金融研报、专利、学术、政务)是算得过来的账。
一条可操作的建议:如果你正打算把端到端 MLLM 文档解析推到生产,先别急着上 Sequential 基线,拿 PaDoc 的开源实现在你自己的并发场景下压一下——尤其是 P95,这个数往往决定你能不能过 SLA。
🧊 理性看待
该夸的夸完了,也得说几个值得留个心眼的地方。
第一,整套方法的理论基石——「区域特定内容充分性」假设——并不是在所有文档上都成立。 区域内部的文字、公式、表格,确实主要由本区域视觉决定;但文档里有一类信息天然跨区域:多栏文档的阅读顺序(读完左栏接右栏)、跨页表格的延续、脚注与正文、图表标题与正文引用、公式编号互引。这些恰恰是 OmniDocBench 里「Read Order」指标考察的对象。而 PaDoc 报告了 Read Order,却没单独把它和 Sequential 基线拎出来对比——这其实是我读这篇时最想核的一个数。如果在该子项上 PaDoc 落后,那说明并行可能是用「跨区域建模能力」换的效率,只是被文本、公式这些区域内部强项的综合分盖住了。要复用的话,建议先去原文表格把这个子项翻出来。
第二,那 67–118% 的吞吐提升,高度依赖 vLLM 的自动前缀缓存能把公共前缀的 KV 复用好用满。换一个前缀缓存较弱或不支持的推理后端(比如某些 TensorRT-LLM / SGLang 配置),收益大概率缩水。论文把实现锚定在 vLLM 上,没给跨后端的验证——如果你的技术栈不是 vLLM,落地前得自己测一遍。
第三,训练门槛摆在那:128 张 A800、约 1100 万样本,个人复现基本不现实。不过代码开源、模型基于 Qwen3-VL-2B,推理侧试一试是完全可以的,这已经是诚意之举。
总的来说,这是一篇方法巧(互信息假设 → 因式分解 → 祖先注意)、工程实(vLLM 集成、不改正文内核)、收益大(吞吐翻倍、P95 减半、质量不掉)的扎实工作,不是那种只刷分的论文。带上「假设何时会失效」「收益是否绑死后端」这两个问题去读,你能从里面拿走的东西会比看摘要多得多。
作者:lusca
版本:lusca-paper-blog v1.5.0
出处:https://github.com/yjmm10/lusca-skill/tree/main/skills/lusca-paper-blog

