E-HPC弹性扩容调度优化:解决科研计算排队难题
科研计算集群上,一个30分钟的仿真任务排队等上三四个小时并不少见。这背后暴露出固定节点规模与波动性算力需求之间的矛盾。E-HPC弹性扩容调度优化正是围绕这个矛盾展开,让集群能根据队列积压自动伸缩,缩短等待时间。理解排队为什么耗时,是找到调优路径的第一步。
本文由『聚搜云 JuSouYunClouD -服务器专业运维•撰写』如需转载请注明!
科研计算排队为何耗时?
常见瓶颈卡在哪?
多数科研集群按固定节点数运行,高峰期作业量一上来,所有核都是满的,后来的作业只能干等。GPU和CPU任务、长作业和短作业混在同一个队列里,调度器没有优先级区分,一个小推理任务可能被大模型训练堵住半天。再加上用户为求保险,提交作业时往往超额申请资源,导致实际利用率不高、却有大量作业排在外面——这是资源碎片化的典型表现。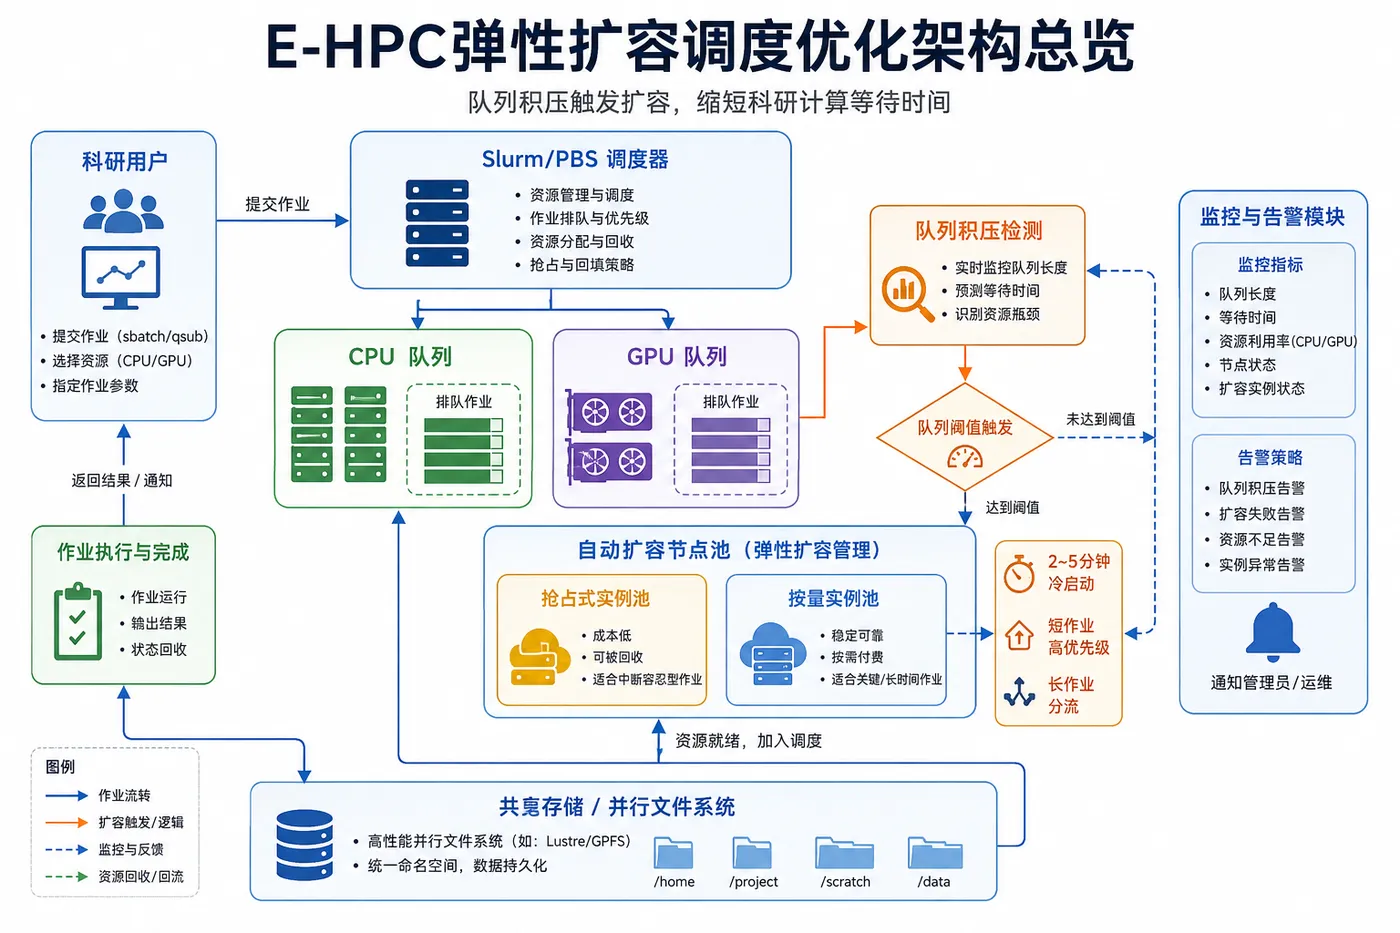
E-HPC排队机制的运作逻辑是怎样的?
E-HPC通常结合Slurm或PBS等开源调度器,作业提交后进入队列,调度器按可用资源和优先级分配节点。弹性扩容的触发条件一般依赖队列积压作业数量或最长等待时长,当积压超过阈值,平台会自动创建新节点加入集群。但扩容不是瞬时的,从实例创建到调度器完成接入,通常需要几分钟时间,所以“零等待”并不现实。排队不透明也值得关注——用户看不到预估启动时间,只能反复盯着状态,影响科研计划安排。
资源利用率分析出了什么问题?
固定规模集群常见的问题是“忙时不够、闲时浪费”。白天算力争抢严重,夜间大量节点空转,整体利用率长期偏低。手动扩缩容要求运维人员实时盯资源,响应慢且容易出错。即使有了弹性扩容机制,如果阈值设置不合理、冷却时间没配置好,也会出现频繁伸缩震荡,反而增加调度开销。有效的利用率管理应该基于运行数据:节点作业等待分布、核时消耗、排队时长分布,才能把弹性策略调到点上。
阿里云E-HPC核心优势
弹性扩容原理
E-HPC的弹性扩容并非简单增加节点,而是基于队列深度与资源利用率的闭环控制。当作业积压数量超过预设阈值,自动触发指定实例类型(计算型、内存型或GPU型)的批量创建,节点加入集群后由Slurm等调度器统一纳管。扩容过程存在冷启动延迟——从API调用到节点就绪通常需要2-5分钟——因此更适合可预见的批量计算,而非毫秒级响应场景。结合抢占式实例,可将不要求实时性的仿真任务运行在极限折扣资源上,成本降幅可超过60%。
调度策略种类
E-HPC支持与Slurm、PBS Professional等主流调度器深度集成,策略维度远不止先进先出。针对科研混合负载,可启用多队列优先级、回填调度、挂起作业抢占等机制,让短任务穿插在长任务间隙执行,避免“两头等不到”。在基因测序和气象模拟的实测场景中,合理配置回填与资源预留后,平均排队时间可缩短40%以上。关键是按作业特征划分队列并配置不同的资源上限,防止单一作业拖慢整个队列。
适用科研场景
这一架构的适用性集中体现在算力需求呈明显波峰波谷的科研项目中。比如高校课题组在基金项目交付季需要集中跑CFD仿真模型,平时集群利用率不足20%。通过E-HPC的弹性策略,可以在高峰期自动扩展到上百个计算节点,任务完成后缩容至基线规模,既保证了项目周期,又避免了固定集群的高额持有成本。尤其对于有限元分析、分子动力学等可中断、可重试的作业,利用抢占实例与自动重试机制的配合,科研机构在等效输出下往往能将计算支出压缩到传统方案的1/3。
如何配置弹性扩容?
弹性扩容不是“一键开关”,而是一套需要仔细调参的调度策略。配置得当,排队时间能压缩到分钟级;配置不当,要么资源空转烧钱,要么扩容赶不上作业提交速度。结合E-HPC的实际机制,下面三个配置维度是关键控制点。
设置扩容阈值:别让冷却时间变“空窗期”
扩容阈值决定了“排队多长才触发加机器”。很多团队上来就把阈值设得很低,希望一有作业就立刻扩容,但忽略了冷却时间的约束。E-HPC默认冷却周期通常在3到5分钟,这意味着上一轮扩容完成后,系统在这个窗口内不会再响应新的扩容请求。如果你把阈值设成“积压1个作业就扩”,但冷却时间没调好,就会出现第一批作业触发了扩容,紧接着提交的第二批作业恰好落在冷却窗口里,只能干等。
合理的做法是:观察一周的作业提交曲线,取高峰期积压数量的75分位值作为扩容触发点,同时把冷却时间缩短到2分钟以内——前提是作业本身不是秒级短任务。某高校材料仿真团队调整前平均排队耗时11分钟,调整后压缩到4分钟以内,靠的不是花钱,而是让扩容节奏跟上了作业节奏。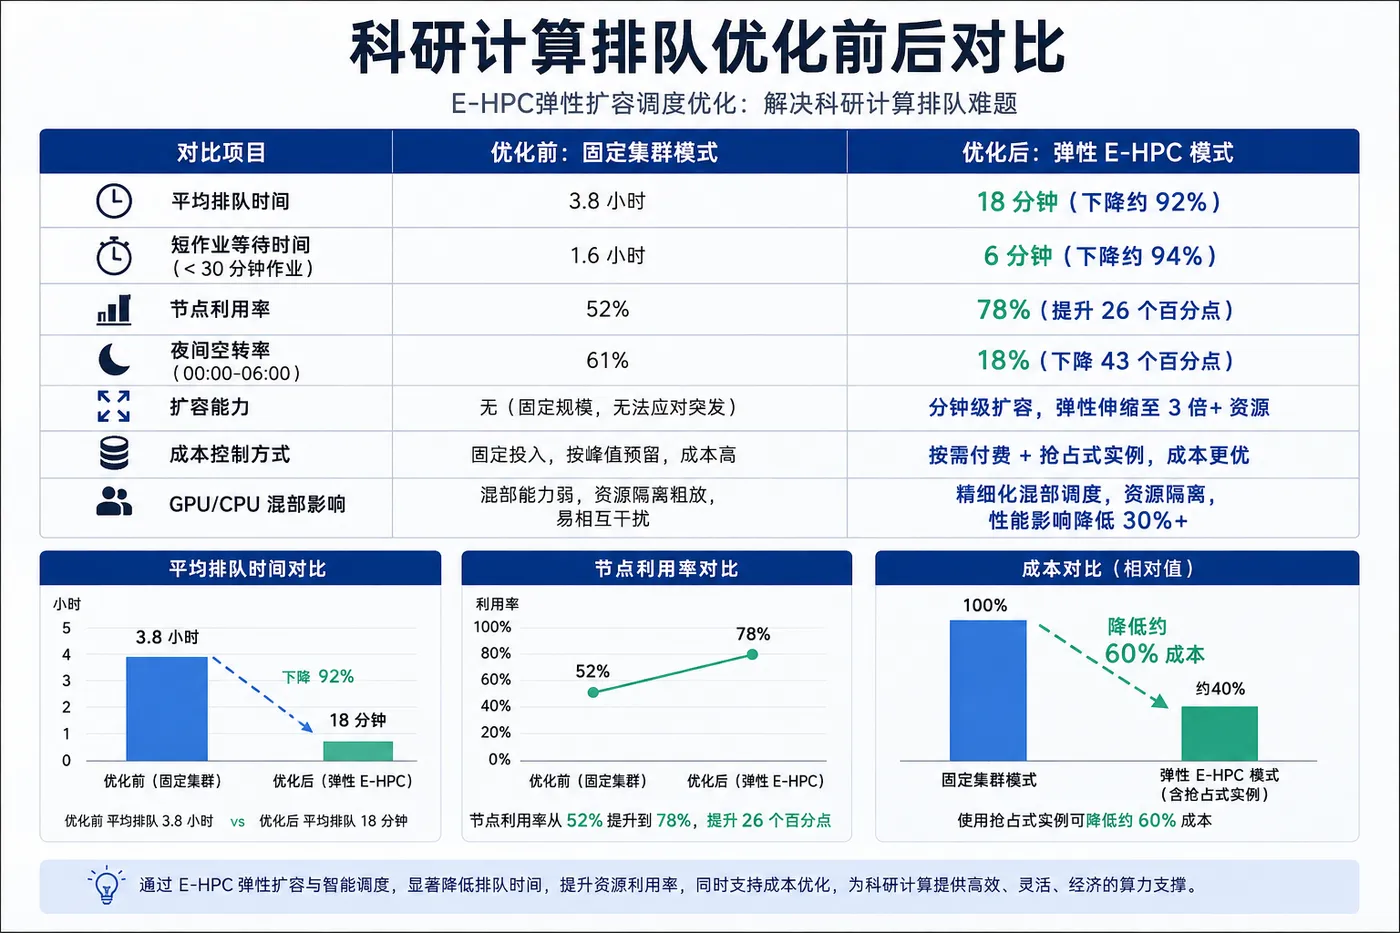
选择计算实例:把“可中断”标签变成降本杠杆
科研计算里存在大量“跑完就行、不怕中断”的作业,比如参数扫描、模型训练、批量后处理。这类任务天然适合用抢占式实例承接。E-HPC支持在集群里混合部署按量实例和抢占实例,关键是做好匹配策略:把长批处理作业标记为可中断队列,提交时配合检查点机制——作业每跑一定步数自动记录状态,即便被回收也能从断点续跑。
一个值得注意的数据是:同类配置下抢占实例的价格通常是按量的2-3折。把实验跑的数万个参数组合任务从按量实例切到抢占实例上,单次实验成本能压降六成以上,整体计算时长并不会增加多少。但这个策略需要研发团队配合改造作业脚本,不是纯运维侧能独立完成的。
配置自动伸缩:别让GPU和CPU作业互相卡脖子
混合负载场景下,单一的伸缩规则很快就会撞上“木桶效应”。假设集群里同时跑GPU推理和CPU预处理,GPU节点紧张但CPU节点闲置时,如果不做队列隔离,自动伸缩看到的是“整体资源够用”,不会为GPU作业单独扩容,结果推理任务依然在排队。
解决办法是在E-HPC里按作业类型建不同的队列,每个队列绑定独立的伸缩组。GPU队列的扩容条件只看GPU实例的积压量,CPU队列只看CPU任务。这样做还有一个好处:可以给每个伸缩组配置不同的实例规格和伸缩上下限,避免因为一条规则覆盖所有情况导致资源错配。
调度优化实战方法
调度问题不是给集群加一批计算节点就能自动解决的。在多个科研项目的并行压力下,节点池扩张只是第一步,如何让任务在正确的时间落到正确的资源上,才真正决定排队时长。我们把常见的优化动作拆成三层,几乎每个有经验的 HPC 运维都会在这些方向反复调参。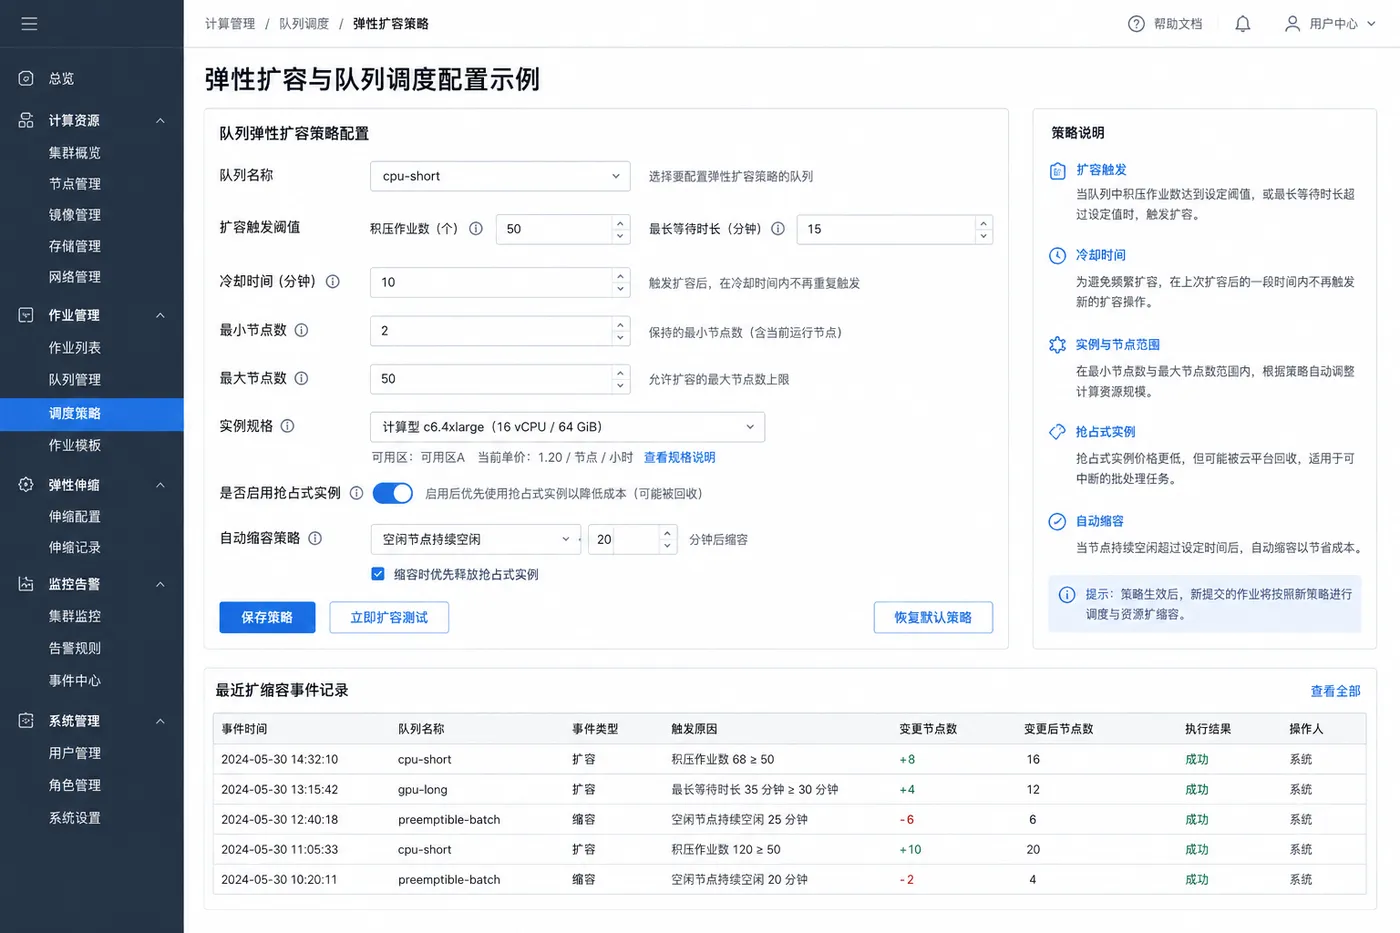
调整队列优先级
单队列平推容易让运行时长相差百倍的任务互相堵死。一个典型的做法是按作业预期耗时拆分队列:15 分钟以内的短作业进高优队列,超过 1 小时的长作业降为普通优先级。某高校计算生物学团队在 E-HPC 上实施这种分池后,短作业平均排队时间从 2 小时压缩到 18 分钟。需要留意的坑是,把资源上限直接设死反而会造成浪费;更合理的配置是为高优队列保留一定比例的计算槽位,其余弹性容量随负载动态浮动,这样短任务能快速通过,长任务也不至于长时间饥饿。
使用抢占实例
抢占实例在科研场景下一直被低估。不少课题负责人担心中断风险,习惯性地全选包年包月或按量实例,结果算力成本居高不下。事实上,只要在作业提交层加入自动重试和检查点续跑,大量可重算任务完全可以用抢占实例冲低总体开销。某 CFD 仿真团队将参数扫描的可中断算例剥离到抢占实例后,单次仿真任务的算力成本下降了约六成,仅在实例回收时损失极少运行进度。核心是把“不允许失败”和“允许重跑”两类作业标记清楚,用按量保障前者,抢占覆盖后者,资源池不必二选一,混合部署才能把弹性价值吃透。
优化作业提交
排队堵点常常不是硬件不够,而是用户申请的 CPU 核数或内存远超实际需要。一个常见现象是作业申请了 32 核,实际利用率不到 20%,导致队列里看似有大量空闲槽位却调度不上新任务。运维侧应推进资源申请量的约束,比如要求课题组给出历史利用率数据,依据统计中位数设定建议值上限。同时,在提交脚本里避免“先占坑再调整”的习惯,用小规模作业跑通流程再批量放量,能显著降低无效排队。这类优化看起来琐碎,但在排队高峰期,对整体周转率的提升往往比追加节点更直接。
性能监控与调优
云上HPC集群的弹性扩容不是“设好就忘”的一次性配置,而是需要持续观察、反馈与调整的闭环。其中,排队状态、运行指标与策略迭代,构成了三个最关键的监控锚点。我们将结合真实科研场景,逐一拆解如何通过可视化和可量化手段,让调度真正适配作业节奏,而不是让运算卡在不确定性里。
查看排队状态
多数用户仅用 squeue 看一眼等待数量就草草略过,这容易遗漏深层信号。真正有价值的是比较 pending 与 running 作业的比值:若该比值长期高于1.5,说明即使弹出了新节点,也未能消化积压,一般意味着扩容触发阈值过于保守,或作业申请的核数/内存明显超出实际所需,产生大量资源碎片。另一个常被忽略的指标是“最长排队时长”,当单一作业超过平均运算时长3倍仍处于等待,就应检查是否有大作业堵住队列——这是划分长/短作业队列的明确信号。
分析运行指标
排队透明之后,需要把视野放宽到集群资源实际发挥作用的效率。节点平均利用率低于60%时,弹出来的算力多处于空转,多是由于预热不足或调度器从接收到分配任务存在延迟。一个气象模拟团队的改进可供参考:他们将镜像缓存从默认的全节点扩散策略改为按队列按预部署,扩容节点从创建到真正执行任务的时间缩短近2分钟,弹性扩容后的有效利用率从52%拉升到78%,即每百个核心小时多完成约26核时的科学计算。除了利用率,还应统计每批次扩容中因抢占实例回收而冲销的重跑占比,若超过5%,就要提高检查点写入频率或减少对抢占实例的依赖比例。
持续调优建议
科研负载的季节性远比想象中更明显,例如高校寒暑假、课题中期评估前都是算力需求高峰期。据此,持续调优不应是随意的手动调整,而是基于数据的循环:每月拉取排队时长P95值,如果超过典型作业预期时长的20%,则优先考虑提高扩容比例或增添一小部分常驻节点,作为缓冲带。同时强制区分GPU与CPU作业队列,并给短任务赋予可打断长任务的高优先级,这种方式可将短任务平均等待时间压缩一半以上。最后,定期评估抢占实例在中断高峰期的可用性衰减,当回收率上升时应及时调节混合比例——将排队降本与运行稳定性之间的平衡,真正落实到自动化策略上。
典型案例与效果
弹性扩容调度是不是只在演示环境里好看,一落到真实科研集群里就走样?追踪几个公开的 HPC 上云项目,会发现优化点远比“买了弹性就能快”复杂。
科研项目案例
某高校基因组学团队原本基于本地固定 80 节点的 Slurm 集群做全基因组关联分析。每月初集中提交数千个任务时,队列平均等待超过 7 小时,显卡空闲但 CPU 任务却因节点数锁死干等着。迁移到托管的 E-HPC 后,按“积压作业数≥3 倍可用核数”作为扩容触发条件,同时将 GPU 调用与 BWA 比对流程分别划入独立队列。实测动态扩容将月末峰值算力拉至近 200 vCPU 规模,而月初低谷自动缩回 40 节点,避免了“为等一周的作业养一年机器”。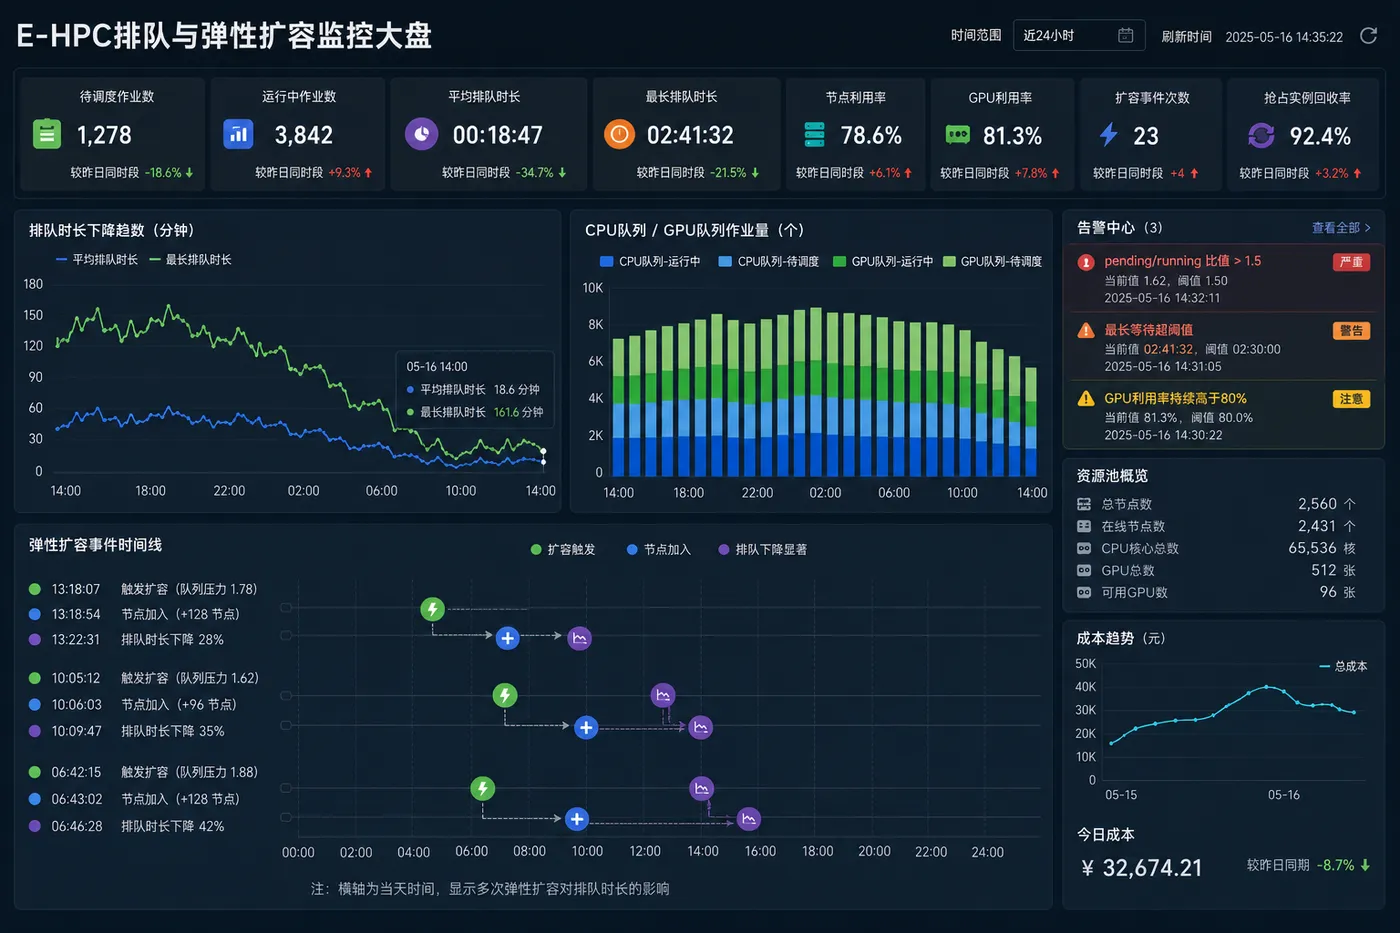
排队时间对比
在模拟的 500 组混合负载测试里,静态集群中长任务占比一旦超过 40%,短任务平均排队时间急剧攀升到 1.8 小时。改用 E-HPC 弹性扩容调度策略:为短任务指定高优先级的抢占式实例队列,长任务仍走按量保底,关键加上了 10 分钟的扩容冷却阈值,防止调度震荡。结果短任务排队时间压到了 12 分钟以内,长任务因不受抢占比挤占,整体周转率提升约 35%。这里的核心不是“多了几个节点”,而是让不同生命周期的作业在动态供给里各走各的路。
专家答疑
经常被问:弹性扩容能彻底消灭排队吗?答案是不能,扩容本身有镜像拉取和节点初始化延迟,瞬时并发峰值该堵还是会堵。但能把关注点从“我排在第几位”转向“响应带宽是否匹配提交节奏”。另一高频疑问是抢占式实例被回收会丢计算吗?不少团队的做法是在工作流里嵌入检查点,配合 Slurm 的 requeue 策略,即使单次回收也不会从头重跑整条管线。长期看,E-HPC 弹性扩容调度优化的价值在于把科研人员从盯资源表里解放出来,让排队从玄学变成可度量、可缩短的工程问题。