前段时间帮朋友搭建一个本地 LLM 推理服务,他手里只有一块 RTX 3060 12GB。想跑 70B 模型,常规思路是量化到 4bit,但量化后的效果损失在复杂任务里还是能感觉到。
然后我看到了 AirLLM。Python 写的,Apache-2.0 协议,GitHub 27k+ Star。它的卖点是:70B 模型能在单张 4GB 显存 GPU 上跑,不需要量化、蒸馏或剪枝。
我仔细看了它的实现方式,发现核心思路不是压缩模型,而是改变加载策略。今天聊聊这个技术路线。
一、传统思路 vs AirLLM 思路
传统思路
大模型推理时,通常把整个模型权重一次性加载进显存。一个 70B 模型 FP16 需要约 140GB 显存,消费级 GPU 根本放不下。所以大家只能走量化、蒸馏、剪枝路线,用精度换空间。
AirLLM 思路
AirLLM 不问"怎么让模型变小",而是问"能不能一次只加载一层?"
它把模型按层切分成多个 shard 文件,推理时只在 GPU 上保留当前计算的那一层,算完就释放,再加载下一层。这样显存占用取决于单层大小,而不是整个模型大小。

结果很夸张:
| 模型 | 参数量 | 所需显存 |
|---|---|---|
| Qwen3 / Mistral / Phi 8B | 8B | ~1-2 GB |
| Qwen3-30B / Mixtral | 30-47B | ~1-3 GB |
| Qwen3-235B | 235B | ~3 GB |
| Llama 3 70B | 70B | ~4 GB |
| Llama 3.1 405B | 405B | ~8 GB |
| DeepSeek-V3 | 671B | ~12 GB |
| Kimi K3 | 2.8T | <4 GB |
Kimi K3 这个 2.8T 参数的 MoE 模型能在 4GB 以下跑,是因为它每次只加载实际激活的 expert,而不是整个层。
二、核心机制:层分片 + 动态加载
AirLLM 的工作流程可以拆成三步:
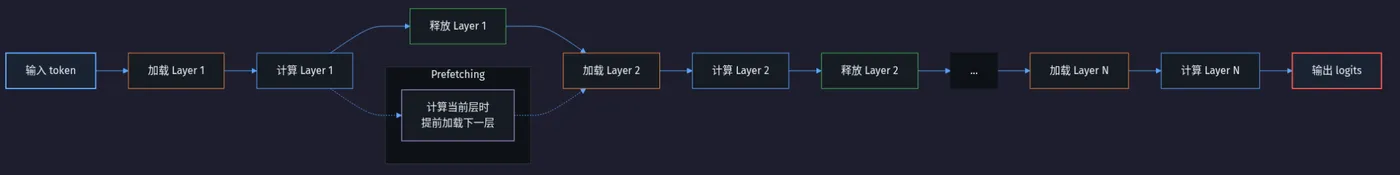
1. 模型分片
首次加载模型时,AirLLM 会把 HuggingFace 下载的模型按层切分成多个独立文件,存在本地。这个预处理只需要做一次,之后复用。
from airllm import AutoModel

model = AutoModel.from_pretrained("Qwen/Qwen3-32B")
2. 按需加载
推理过程中,AirLLM 按顺序加载每一层到 GPU,完成该层计算后释放,再加载下一层。任意时刻 GPU 上只有当前层。
3. 预取优化
为了避免"加载一层 → 计算一层 → 等加载"的流水线空转,AirLLM 做了 prefetching:在计算当前层的同时,提前把下一层从磁盘读到内存。这样 I/O 和计算可以重叠,README 里说能带来约 10% 的速度提升。
三、代码长什么样
实际使用非常简洁,和 transformers 的接口很像:
from airllm import AutoModel

MAX_LENGTH = 128
model = AutoModel.from_pretrained("Qwen/Qwen3-32B")

input_text = ['What is the capital of United States?']
input_tokens = model.tokenizer(
    input_text,
    return_tensors="pt",
    return_attention_mask=False,
    truncation=True,
    max_length=MAX_LENGTH,
    padding=False
)

generation_output = model.generate(
    input_tokens['input_ids'].cuda(),
    max_new_tokens=20,
    use_cache=True,
    return_dict_in_generate=True
)

output = model.tokenizer.decode(generation_output.sequences[0])
print(output)
大的模型也是同一行代码:
# 235B MoE,约 3GB 显存
model = AutoModel.from_pretrained("Qwen/Qwen3-235B-A22B")

# 671B,约 12GB 显存
model = AutoModel.from_pretrained("deepseek-ai/DeepSeek-V3")
AutoModel 会自动检测模型类型,不需要手动指定 Llama、Qwen、DeepSeek 这些类。
四、可选的压缩加速
如果觉得层加载还是慢,AirLLM 支持块级权重量化:
model = AutoModel.from_pretrained(
    "garage-bAInd/Platypus2-70B-instruct",
    compression='4bit'  # 或 '8bit'
)
注意这里的量化和传统量化不太一样:
- 传统量化:权重和激活都量化,容易掉精度
- AirLLM 的压缩:主要解决磁盘 I/O 瓶颈,只量化权重,精度损失很小
官方说开启 4bit 压缩后推理速度能提升约 3 倍。
五、支持哪些模型
AirLLM 基本覆盖主流开源模型:
- Llama 2 / 3 / 3.1 / 3.3 / 4
- Qwen 1 / 2 / 2.5 / 3(含 MoE、FP8)
- DeepSeek V2 / V3 / R1
- Mistral / Mixtral
- Phi / Gemma / ChatGLM / Baichuan / InternLM / Yi
新模型发布的当天通常就能用,因为架构大多是已知变体。
六、实际部署要注意什么
磁盘空间
层分片需要先把完整模型下载到本地,所以磁盘空间要够。首次加载时会做分片预处理,过程也比较吃磁盘。如果磁盘不够,可以设 delete_original=True,分片完成后删掉原始 HuggingFace 模型,省一半空间。
速度 trade-off
AirLLM 把显存瓶颈转移成了磁盘 I/O 瓶颈。模型虽然能跑起来,但速度肯定不如把模型全放显存里快。它适合"能跑起来"的场景,不适合"追求极致吞吐"的场景。
首次加载较慢
第一次用某个模型时,AirLLM 会逐层拆分和保存,耗时较长。之后再次加载就快多了。
macOS 也支持
Apple Silicon 用户可以通过 MLX 后端运行,不过要额外装 mlx 和 torch。
七、适合什么场景
很适合:
- 消费级 GPU 本地部署大模型
- 笔记本上做 70B+ 模型实验
- 学术研究,不想买 A100/H100
- 原型验证阶段,先让模型跑起来再说
不太适合:
- 生产环境高并发服务
- 对延迟敏感的应用
- 没有足够磁盘空间的机器
- 追求极致推理速度的场景
结语
AirLLM 给我最大的启发是:有时候问题不在模型本身,而在加载方式。 与其千方百计把模型压缩变小,不如让它按层流动起来。
这个思路虽然牺牲了一定的推理速度,但把"大模型上消费级 GPU"这件事从"不可能"变成了"一行代码"。对于个人开发者、小团队和学生来说,这种技术路线非常实用。
如果你有一块 4GB 或 8GB 的显卡,又一直想试试 70B 甚至更大的模型,AirLLM 值得装一个看看。