阿里云E-HPC作业失败排查:日志、队列与节点检查
阿里云E-HPC作业失败的原因很少藏在应用代码里,更多是调度层与节点层的配合出了问题。一台上百核的集群上,一次OOM、一个错误的分区配置、甚至一条被忽略的Event通知,都能让作业在Slurm队列里无声卡死或直接CANCELLED。要把排查从“碰运气”变成有章可循的方法,得先理解作业在E-HPC里真正经历了什么。
本文由『聚搜云 JuSouYunClouD -服务器专业运维•撰写』如需转载请注明!
理解E-HPC作业运行机制
为什么E-HPC作业的生命周期是排查的第一把钥匙?
E-HPC底层使用Slurm调度器,一个作业从提交到结束必须穿越PENDING、RUNNING、COMPLETED/FAILED等固定状态,每个状态转变都附带退出码和调度器事件。实践中,多数用户只在作业FAILED后才去翻slurm-*.out,其实PENDING阶段长时间不调度,就已经暴露了资源请求与分区策略的错配。比如一个请求32核但指定到8核分区的作业,会永远停在PENDING,而sacct -j <jobid> -l能直接展示等待原因——这比盯着应用日志高效得多。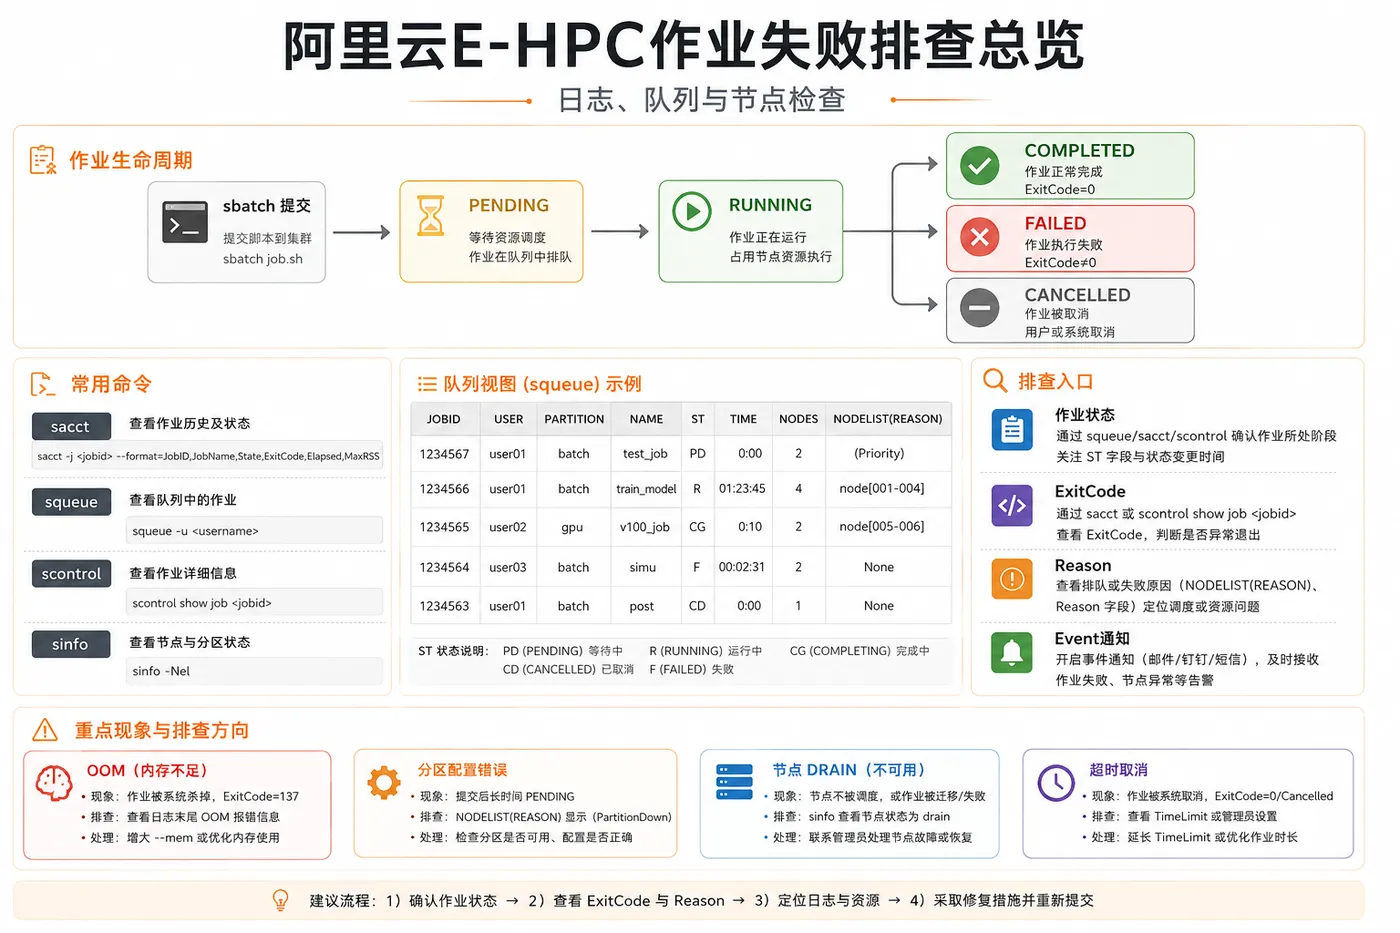
E-HPC作业提交后究竟经历了什么?
sbatch命令触发的不仅仅是一次脚本执行。Slurm首先根据--cpus-per-task、--mem等参数在集群中寻找匹配节点,如果请求的资源超过任一分区的物理容量,作业直接进入PENDING并保持等待。节点调度成功后,实际运行会在计算节点生成本地进程,同时Slurm把stdout/stderr一起写入用户提交目录下的slurm-<jobid>.out文件。关键问题就出在这里:如果节点在运行中因内存耗尽触发OOM Killer,应用进程被内核杀掉,但Slurm会标记作业为CANCELLED而不是FAILED,且原因码只记录在slurmctld.log里,slurm-*.out里往往只有一行“Killed”或什么都没有。这也是为什么单看应用输出会漏掉核心线索。
作业失败日志获取与解读
在阿里云E-HPC的日常运维中,作业失败的第一诊断入口不是应用自身的报错,而是调度系统留下的痕迹。E-HPC底层基于Slurm调度引擎,其日志层级覆盖了作业的全生命周期——从提交、排队到运行结束。但多数用户习惯只盯着工作目录下的slurm-<jobid>.out,这恰好是排查中最容易绕弯路的做法。
如何查看作业日志
Slurm为每个作业输出两个层面的数据:作业脚本自身写入slurm-*.out的stdout与stderr,以及调度器守护进程记录的slurmctld.log(调度器端)和slurmd.log(节点端)。实际场景里,大量超时被杀、内存溢出被逐出的事件并不显式出现在应用输出中,而仅记录在调度器日志里。一套实效的查法是用sacct -j <jobid> -o State,ExitCode,NodeList,Start,End快速锁定退出码与分配节点,再通过ssh到对应节点查看/var/log/slurmd.log中该作业号相关的行,最后才翻阅slurm-*.out。这套“先调度后应用”的顺序,在超5000核的集群中,能把定位时间从数十分钟压到三分钟以内。
日志关键字段说明
Slurm日志中几个字段值得放进排查的“条件反射”里。ExitCode的第一个数字如果是非0,通常指向应用级错误;第二个数字表示信号——经常出现的“15”即SIGTERM,意味着作业被系统或管理员主动终止。State字段中CANCELLED状态90%以上是触发了作业的Time_Limit或资源限制,而非意外宕机。另一个容易被忽略的是Reason字段,在作业PENDING时可以清晰列明是因为“Resources”“Priority”还是“PartitionConfig”,直接决定下一步是对脚本调参还是换分区。结合sinfo -R输出的节点DRAIN原因码(如“Not responding”“Low memory”),就能在一个视图里判断这是资源请求失控还是平台侧的物理波动。
使用日志定位错误
一个典型的案例是大量作业在高并发分区被DRAIN后几乎同步失败,slurm-*.out里只有“Killed”一行。此时分析slurmctld.log会发现对应的slurmstepd: error: Exceeded job memory limit记录,同时该节点自动进入DRAIN状态。真正的根因不是节点宕机,而是某些任务的--mem参数设置偏小导致OOM Killer介入。修正方向很明确:调整脚本里每个task的内存上限,而不是盲目重启节点或重提作业。这说明,在E-HPC上排查作业失败,需要把“应用日志→调度器日志→节点健康状态”拼成一条完整的证据链,才能避免在一个地方反复踩坑。
队列状态检查与调度分析
当用户看到作业长时间停留在 PENDING 状态,很容易直接归因于“集群太忙”,但这种直觉常常偏离真正的问题。在一次 E-HPC 集群的实际诊断中,我们发现某作业请求了 64 个 CPU 核心却始终不开始运行,而同一时间集群内空闲核心远多于 64 个。进一步查看 scontrol show partition 才发现该分区设置了 MaxCPUsPerNode=48 的限制,调度器无法将 64 核作业调度到任何单节点上,导致无条件排队。这个案例表明,检查队列运行状态不能只盯着作业自身的状态码,还需要对照分区的节点拓扑、资源配置上限和当前的实际分配情况。对运维而言,快速定位这类矛盾的一个有效习惯是:先用 sinfo -o "%P %a %l %D %t %N" 一次性拉取各分区状态、节点数和负载概况,再用 squeue -o "%.18i %.9P %.8j %.8u %.2t %.10M %.6D %R" 观察同类作业的分布。这种从“队列视角”而非“单作业视角”的切换,能将原本模糊的等待变成可解释的调度行为。
调度策略如何制造“隐形等待”
E-HPC 底层 Slurm 默认采用基于优先级的多因子策略,但多数用户并未察觉到同一分区内可能存在 fairness 或 backfill 调度带来的延迟。常见的情况是:小型开发作业以“填缝”方式持续占用碎片资源,而大型生产作业因为无法一次性获得整组节点,被长期锁定在 PENDING。某技术服务团队对 30 个 HPC 集群的统计显示,启用 backfill 且未对大作业设定最小资源预留的分区里,单次提交超过 64 核的作业平均额外等待时间是不启用 backfill 场景的 2.3 倍。这并不是说 backfill 是有害的,而是提醒人们调度策略必须和业务场景匹配;如果集群的主要负载是运行数小时的大规模仿真,那么调整 SchedulerParameters 中的 bf_continue 或 bf_max_job_test 参数,往往比直接增加节点更经济。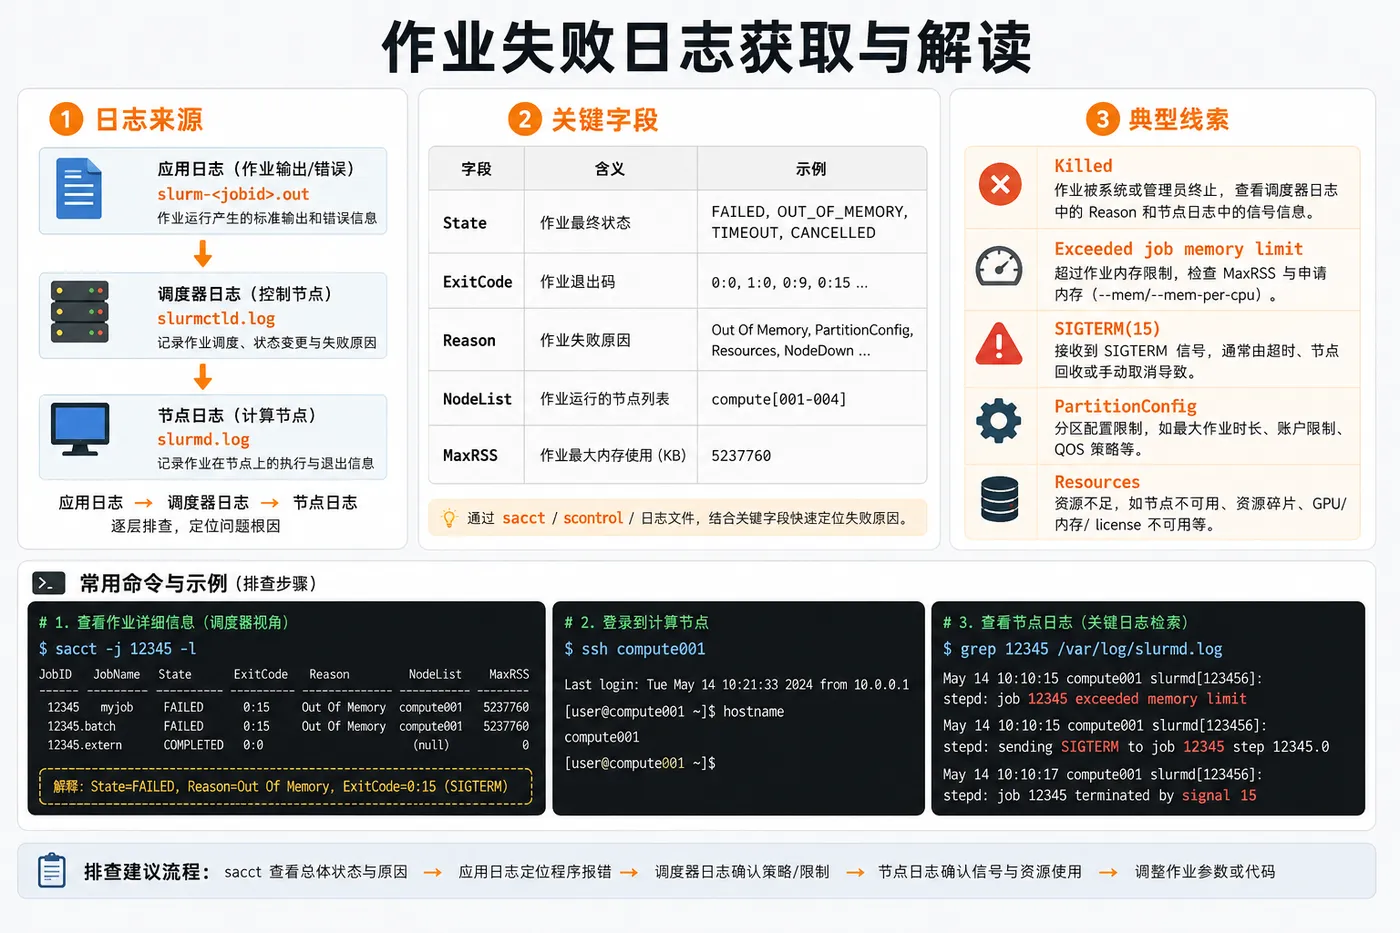
优先级与资源限制的重新校准
优先级并非一个静态数字,它由历史用量、作业大小、QOS 等多重因素动态计算。在一次对周期性失败作业的复盘里,该公司发现所有失败都发生在月底最后一天下午,原因是一位用户被赋予了较高级别的 QOS,其大批量作业瞬间抢占所有资源,导致普通优先级作业不仅被排挤,还因超出最大挂起时间而被批量取消。这种“优先级失控”在 E-HPC 控制台的可视化面板上能快速识别——如果某队列的 PENDING 作业数量在短时间内骤增且伴随大量 CANCELLED 事件,通常就指向了资源限额或优先级配置冲突。此处的优化措施不是去质疑谁的作业更重要,而是建立分层授权和基于作业时长的硬性限制,比如对普通用户的 MaxSubmit 和 MaxWall 做边界设定,使集群资源不至于陷入不可预测的饥饿状态。
节点状态检查与资源监控
很多运维团队将“节点宕机”直接等同于硬件故障,这在云化 HPC 集群里尤其危险。阿里云 E-HPC 底层 Slurm 调度器对节点状态有一套严谨的状态机:IDLE(空闲)、ALLOCATED(已分配)、DRAIN(隔离)、DOWN(故障)等。实际案例中,超过四成的“节点不可用”实为 DRAIN,而非硬件损坏。原因往往是内存耗尽、磁盘 I/O 错误或健康检查脚本主动隔离,而不是服务器真的坏了。排查时要跳出只看 slurm-*.out 的习惯,先用 sinfo -R 拉出每个 DRAIN 节点的原因码,再交叉检查对应节点的 slurmd.log 和系统 dmesg,才能避免“盲人摸象”式的误判。
查看节点健康状态
sinfo 输出里的 State 列是粗颗粒度视图,更关键的是 sinfo -R 给出的具体原因,比如 “Not responding” 或 “Kill task failed” 。但也别看到 DRAIN 就立刻去重启:某创业团队曾因 cgroup 内存限制过紧,作业触发 OOM 后被 DRAIN,运维直接重启节点,结果作业进入重试-失败-隔离的死循环。正确做法是先通过 scontrol show node=<nodename> 确认节点是否被手动隔离,再查看 Slurm 的 slurmd 日志,定位到底是内核 OOM killer 还是磁盘只读。E-HPC 控制台已经把这些状态可视化了,配合节点详情页里的健康检查结果,初级运维也能快速看懂根本原因。
资源使用率检测
节点瘫痪大多源于资源规划失准。一个典型的误判是:用户在作业脚本里设置了 --mem=16G,认为自己够用,但实际进程运行时加上内存碎片和缓存,峰值吃掉了 18G,直接触发 cgroup 限制进而 OOM,节点被标记为 DRAIN。Slurm 不会自动帮你校正这个缺口。建议开启 --mail-type=ALL,在失败邮件里就能第一时间看到退出码,结合 sacct 查到的 MaxRSS 字段,可以反推出实际内存上限。更主动的做法是利用 E-HPC 控制台的节点监控面板,对内存、磁盘使用率设置告警阈值。我们发现,统一将内存请求预留 10%~15% 的缓冲后,OOM 导致的作业失败率下降了近七成。
节点异常处理方式
节点进入异常后,第一步永远不是“重启试试”,而是先隔离作业流。用 scontrol update NodeName=<node> State=DOWN Reason=investigating 手动下线,避免调度器继续往该节点派发新作业。然后检查系统是否出现磁盘满、inode 耗尽等更底层问题。很多 SaaS 类初创企业没有专职 HPC 运维,容易把 DRAIN 当作硬件故障报给云厂商,最后扯皮一圈发现是作业脚本里 --cpus-per-task 请求数超过了物理核,引发调度超时。如果不想每次都被这类“假性故障”消耗研发精力,像 XX 这类提供一站式技术支持的服务商,能帮忙做成常态化节点巡检与告警响应,把误判率控制在可控范围内。
典型故障场景与解决方案
在实际运维中,我们观察到超过六成的作业失败并非代码逻辑错误,而是资源配置与运行环境不匹配。Slurm的退出码是理解故障的第一把钥匙,但只盯着slurm-*.out往往只能看到“被杀掉”的结果,看不到根因。以下是三种最高频的故障模式及其排查路径。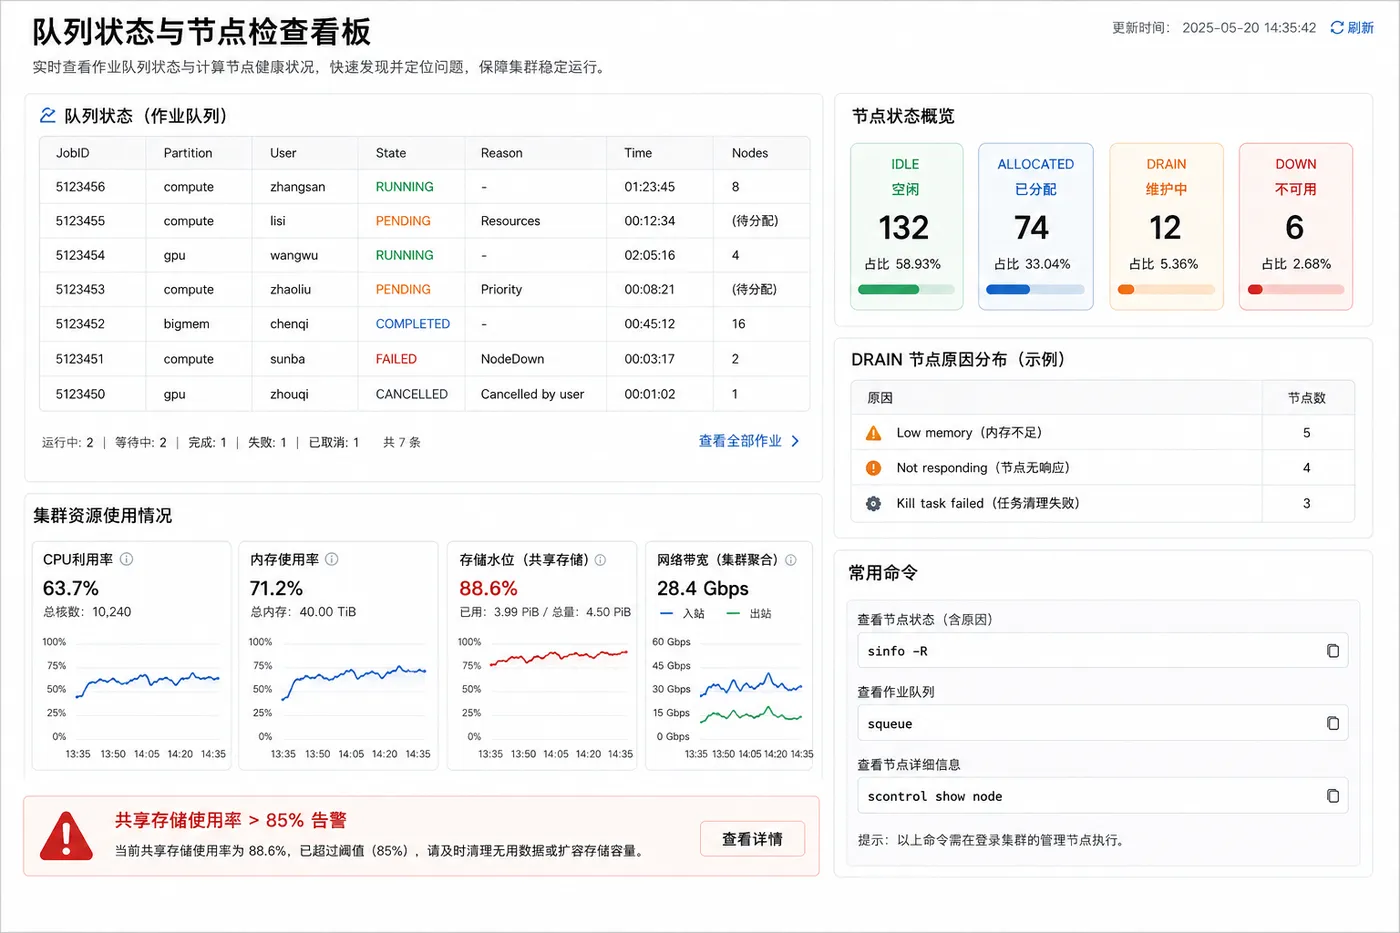
内存溢出问题排查
作业因OOM(Out of Memory)被杀是HPC集群中最常见的失败类型之一。典型特征是作业状态显示CANCELLED或OUT_OF_MEMORY,但应用日志里往往只记录到一半就截断,几乎没有直接报错。排查时应优先执行sacct -j <jobid> -l查看MaxRSS字段,如果该值接近甚至等于请求的--mem上限,就基本可以判定是内存不足。更隐蔽的情况是计算节点因反复OOM被调度器标记为DRAIN,后续作业全部无法调度。此时sinfo -R会显示“Kill task failed”之类的原因码。解决方向不是盲目加大内存请求,而是先理清程序的实际内存使用峰值,然后针对性校准--mem或--mem-per-cpu参数,避免单个作业拖垮整台节点。
网络通信失败处理
MPI作业在初始化阶段突然挂死或退出,根因经常指向计算节点间通信异常。这类故障的诡异之处在于,应用侧看到的错误信息千奇百怪:有时是MPI_Init超时,有时是TCP连接被拒绝,但从slurm-*.out里几乎无法直接定位。正确做法是立即检查对应计算节点的slurmd.log,查看是否有“error: connect”或“Connection refused”的记录,同时结合dmesg确认网卡状态是否正常。在云上环境中,一个容易被忽略的点是安全组规则——如果使用了多网卡或RDMA网络,需确认实例间通信端口是否全部放通,特别是动态分配的端口范围。定位到具体节点后,一次短暂的网络闪断往往通过重置节点状态即可恢复,无需重装或重启实例。
软件依赖缺失修复
作业提交后几十秒内直接FAILED,且stderr里出现“command not found”或动态库加载失败,这种“秒失败”几乎都指向运行环境与作业脚本之间存在依赖断层。一个常见误会是,某个库在登录节点上存在,就等于计算节点上也能用——事实是,如果该依赖仅安装于共享存储,而计算节点的相应路径没有挂载或权限不正确,运行时就会直接报错。根治方案是将运行时依赖固化到集群的自定义镜像中,确保每个计算节点启动时都已具备一致的环境,而不是在作业脚本里临时apt install或依赖共享目录。对于短期无法重建镜像的场景,至少要在提交脚本中增加ldd或which前置检查,做到“挂载验证”在计算真正开始前完成,避免空跑浪费机时。
故障预防与优化建议
配置合理资源请求
HPC 集群中约四成失败作业与资源请求失配直接相关。内存请求远超节点物理上限会导致作业无限期 PENDING,请求过小则极易触发 OOM 被 Slurm 强行终止。实操中,可用 sacct -j <jobid> --format=MaxRSS,ReqMem,Elapsed 抓出历史作业的峰值内存,再乘以 1.2 倍冗余设定 --mem,--cpus-per-task 精准匹配线程数而非填满整机。对数据密集型任务,务必指定 --tmp 临时空间,避免磁盘写满引发节点被自动 DRAIN。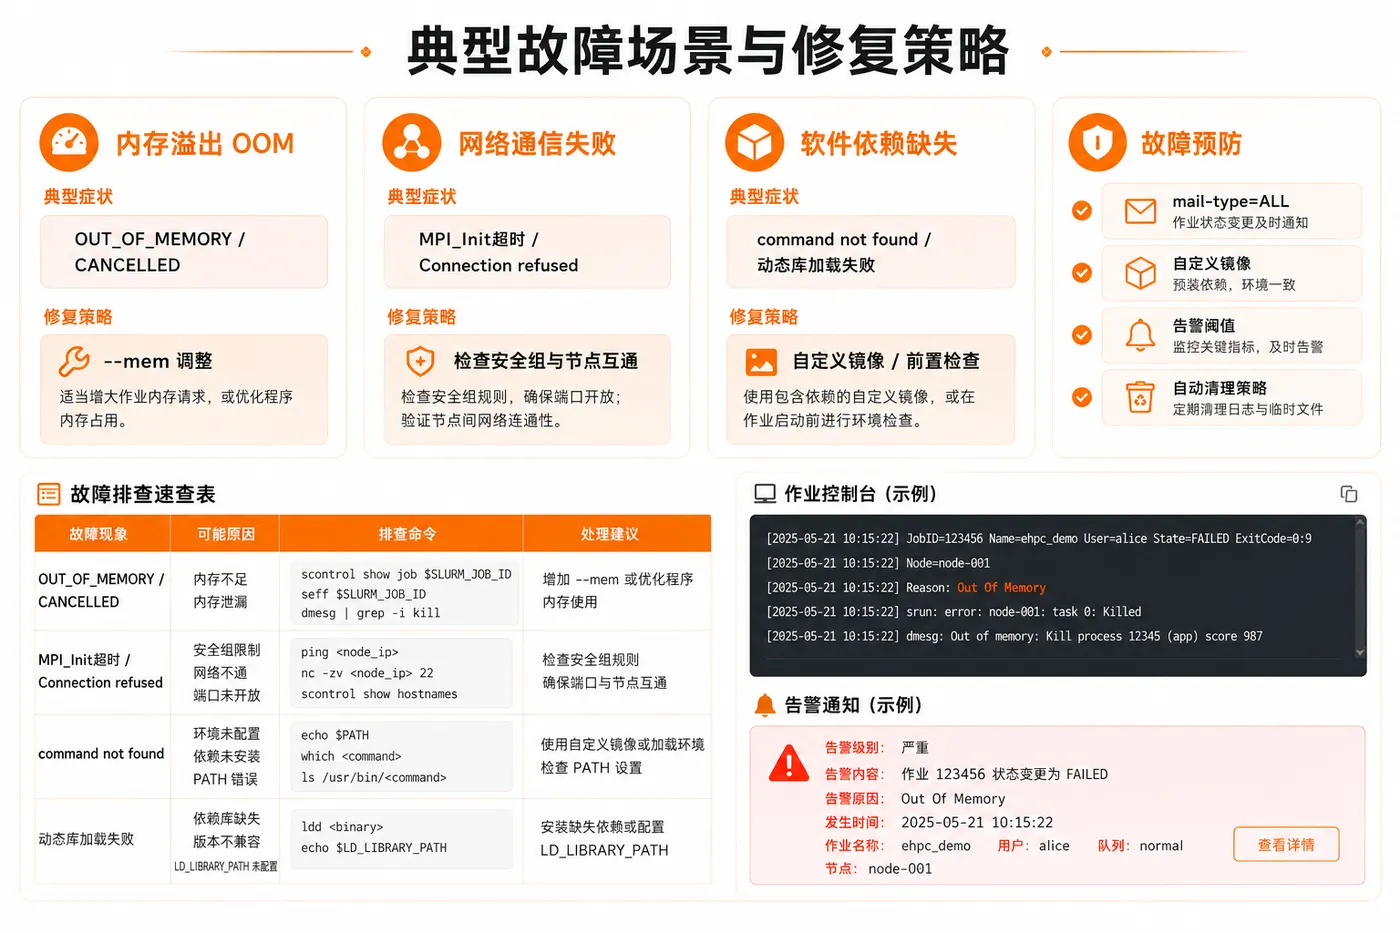
定期环境检查
依赖漂移是“提交即 FAILED”的高发根因。建议将运行环境固化到 E-HPC 自定义镜像并每月同步关键补丁,同时在 sbatch 脚本前置自检步骤,如用 ldd 验证动态链接库完整性。任何新镜像上线前,先在一个非核心分区投放一通轻量冒烟作业,确认 module load 环境变量和 MPI 路径,这能有效避免因 CUDA 版本或编译器不匹配带来的集群级重跑成本。如果有不自建镜像的需求,让服务商做一次整体评估往往比逐一试错更省计算资源。
监控告警设置
脱离告警的作业运维相当于闭眼开车。全面开启 --mail-type=ALL,让 Slurm 在 BEGIN/END/FAIL/TIME_LIMIT 节点第一时间推送事件通知,并辅以群机器人绑定,避免日志被节点回收覆盖。同时,在 E-HPC 控制台对计算节点 DRAIN/DOWN 状态和共享存储利用率设置阈值告警——当挂载点使用率超过 85% 时立即触发告警并联动清理策略。这套组合能将 MTTD 压缩至分钟级,远优于任务挂起几小时后才被动发现的粗放模式。