大家好,我是晚安code。
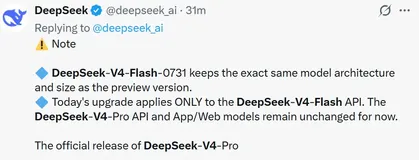
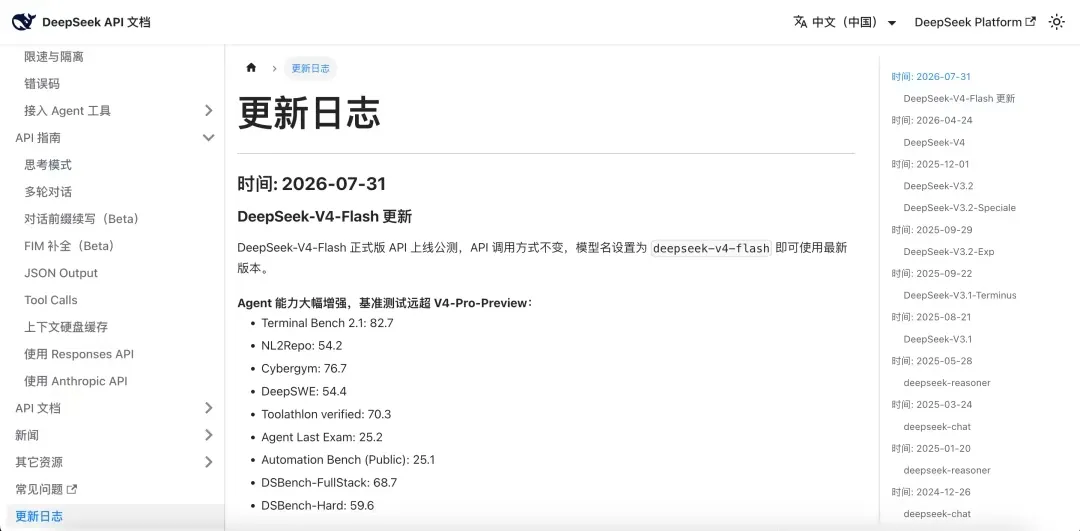
7 月 31 日晚上,DeepSeek 没开一场发布会,就在 API 文档的更新日志里安静地塞了一条:DeepSeek V4 Flash 正式版(deepseek-v4-flash-0731)上线公测。结果当晚知乎热搜第一。我刷到消息时刚洗完澡,脑子里冒出来的第一个念头是:不至于吧?模型骨架和预览版一模一样,就重磨了一遍后训练,凭什么 Agent 能力能暴涨 6 倍?
这篇我把官方跑分、第三方榜单、各家价格全扒了一遍,顺便聊清楚我理解的「AI 大跑毒时代」。数据以官方 2026 年 7 月 31 日发布为准,往下看。
一、DeepSeek V4 Flash 0731 到底发了啥
DeepSeek V4 Flash 0731 最值钱的不是新架构,而是「同一副身板重新打磨」这一招。
先看规格:MoE 架构,总参数 284B,激活参数只有 13B,支持 100 万 token 上下文,能切思考/非思考模式。结构、尺寸和 4 月 24 日的预览版完全一致,官方只说做了重新后训练,结果 DeepSWE 从 7.3 分冲到 54.4 分,直接涨了 6 倍多。相当于同一辆车的底盘没动,只换了调校,百公里加速快了 6 倍,谁能信?
这次只开放了 API,App 和网页端暂时体验不到;V4-Pro 正式版被官方排到了 8 月初。
MoE(Mixture of Experts,混合专家模型):把大模型拆成一组「专家」子网络,每次推理只唤醒其中一部分。你可以理解为「一个部门几十号人,只有几个在干活,但工资按全部门算」——总参数量买能力,激活参数量省成本。
后训练(Post-Training):预训练之后用指令数据、强化学习再磨一轮的阶段。V4 Flash 这次只动了这一步、没动骨架,效果却天差地别。
二、性能追平 Gemini 3.6 Flash,还反超了 Gemini 3.1 Pro
在第三方智能指数上,DeepSeek V4 Flash 0731 已经和 Gemini 3.6 Flash 站到了同一排。
Artificial Analysis 的智能指数给它打了 50 分,比 4 月预览版高 10 分,反超自家 V4-Pro(44 分)6 分,与 Gemini 3.6 Flash 的 50 分持平,距 OpenAI 最便宜的 GPT-5.6 Luna(51 分)只差 1 分——而这只是个 13B 激活参数的模型,在 162 个可比模型里排第 2。
智能指数(Intelligence Index):Artificial Analysis 把多张主流基准综合成一个分数,用来横比不同模型的综合智能水平。你可以把它当成「模型界的统一高考总分」。
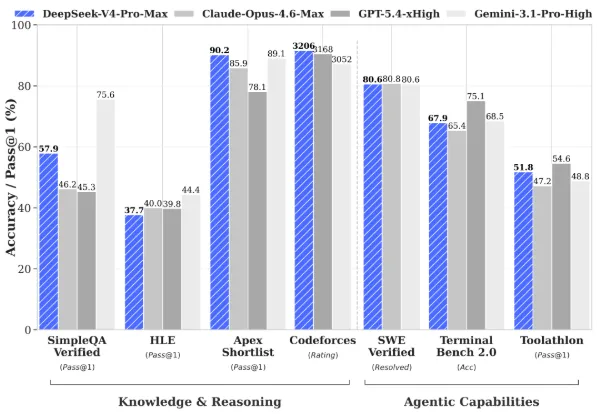
官方晒出的 9 项 Agent 基准里,Terminal Bench 2.1 拿了 82.7,逼近 Claude Opus 4.8 的 85.0;Cybergym 76.7、Toolathlon 70.3。社区 Vibe Code 评测里,它更是以开源权重身份反超了闭源的 Gemini 3.1 Pro。
短板也摆在明面上:世界知识维度 Gemini 3.1 Pro 依旧公认第一,18 项跟踪基准里拿下 12 项;官方自己也承认,知识储备和前沿闭源模型还差 3~6 个月。所以准确说法是——代码和 Agent 场景追平甚至反超,百科知识还差半口气。
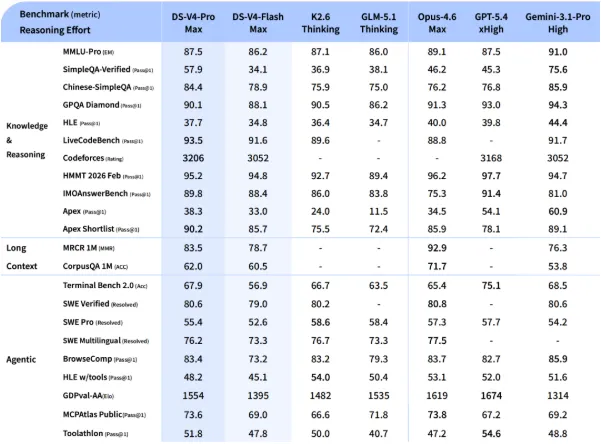
| 模型 | 智能指数(2026-07) | 输出价($/百万 token) | 上下文 |
|---|---|---|---|
| DeepSeek V4 Flash 0731 | 50 | 0.28 | 1M |
| Gemini 3.6 Flash | 50 | — | 1M |
| Gemini 3.1 Pro | 世界知识最强 | 12 | 1M |
| GPT-5.6 Luna | 51 | 1.2 | — |
三、最狠的是价格:输出只要 Gemini 3.1 Pro 的 1/43
性能是面子,价格才是里子——DeepSeek V4 Flash 0731 的输出价只有 Gemini 3.1 Pro 的约 1/43。
官方定价(每百万 token):输入未命中缓存 1 元,命中缓存只要 0.02 元,输出 2 元。Gemini 3.1 Pro 输出 $12(约 86 元),V4 Flash 输出 $0.28(约 2 元),差 43 倍;再对比 Claude Opus 4.8 的 $25,输出价约是它的 1/90。
缓存命中(Cache Hit):请求的输入 token 之前在缓存里算过,直接复用结果、不再重新推理,价格因此便宜得多。你可以理解为「同一道菜第二次端上来,只收加热费」。
更戏剧性的是上线同一天,OpenAI 官宣 GPT-5.6 Luna 降价 80%。DeepSeek 一动,连 OpenAI 都得跟着跑毒。我拿计算器把 86 除以 2 按了两遍,确认没数错小数点。

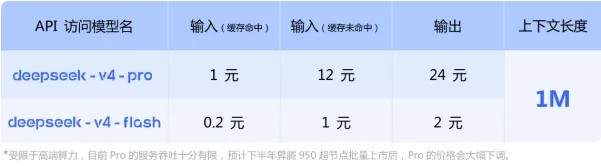
| 模型 | 输入(未命中缓存) | 输出 | 备注 |
|---|---|---|---|
| DeepSeek V4 Flash 0731 | 1 元 | 2 元 | 缓存命中输入 0.02 元 |
| MiniMax M2.7 | 2.1 元 | 8.4 元 | 旗舰 |
| 阿里 qwen3-max | 2.5 元 | 10 元 | 旗舰 |
| 字节 Seed-2.0-Pro | 3.2 元 | 16 元 | 旗舰 |
| 智谱 GLM-5.1 | 6 元 | 24 元 | 旗舰 |
| 百度 ERNIE 5.0 | 6 元 | 24 元 | 旗舰 |
可能有人会问:这么便宜,能撑多久?会不会偷偷涨价?
官方已经打了预防针:V4 正式版会引入峰谷定价,北京时间每天 9:00~12:00、14:00~18:00 高峰时段价格翻倍。便宜是真的,但「挑时间用」也会变成省钱的学问。
四、大跑毒时代:谁在毒圈里挣扎
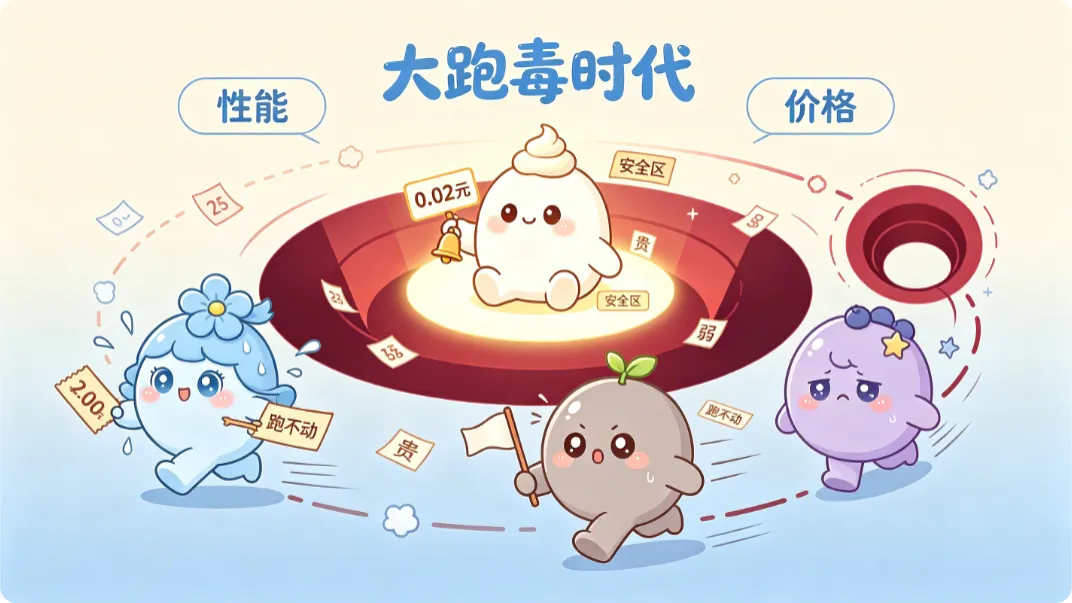
大模型这行已经没有中间态了:要么足够强,要么足够便宜。
吃鸡里毒圈越缩越小,不往安全区跑就掉血。这轮价格战,DeepSeek V4 Flash 0731 就是那个把毒圈往中间推的人。
圈外第一类,贵:Gemini 3.1 Pro、阿里 qwen3-max、智谱 GLM-5、小米 MiMo、百度 ERNIE 5.0、字节 Seed-2.0-Pro、MiniMax M2.7——旗舰输入价从 2 元到 7 元,输出价是 V4 Flash 的 4~12 倍,智能指数却拉不开多少差距。贵的钱,没买到等价的聪明。
圈外第二类,便宜但弱:Seed-1.6-Flash 输入只要 0.075 元、GLM-4-Flash 直接免费,可真去跑 Agent 硬仗就露馅,属于「便宜到能白嫖、弱到干不了活」。
夹在中间的最惨——比上不足、比下有余,毒圈一缩,先死的就是它们。
五、我连夜实测:又强又话痨
便宜和强可以同时存在,但便宜不一定省心。
我连夜把 V4 Flash 0731 接进 Codex 试了一晚,第一感受是快和稳,120+ token/s 的生成速度,几行命令就能把项目跑起来;社区真实项目横评里,它只靠 284B 总参就打进了 T1 梯队,4 小时的重度 Agent 任务烧掉不到 5 美分。钱这一项,是真的省。
但槽点也是实打实的:它是个话痨,Artificial Analysis 测它完成智能指数评测时烧掉了 2.1 亿输出 token,是可比模型中位数的 3 倍多——话多到你怀疑它在复读;指令遵循偶尔翻车,Agent 模式下推理语言还锁死成英文。V2EX 上也有老哥吐槽它 900K 长文本检索一般,跟 MiniMax M2.7 坐一桌。便宜不等于面面俱到。
可能有人会问:价格这么白菜,能力是不是打了折?
得看维度。Agent 干活它逼近 Opus 4.8,指令遵循和世界知识确实是短板。便宜不等于全面,只是性价比上把对手按在地上。
以 2026 年 8 月为准,DeepSeek V4 Flash 0731 是「Agent 日常干活」这个赛道上性价比的第一名;但想让它当世界知识百科,还得回头看 Gemini 3.1 Pro。DeepSeek V4 Flash 这波把价格屠刀挥下去,后面 V4-Pro 正式版 8 月初就到,谁还敢不跑毒?
参考与说明
- 涉及模型版本、价格与基准成绩,请以官方最新发布为准。
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:你更看好哪家模型?DeepSeek V4 Flash 这波性价比屠榜,你会切过去用吗?