关键词: AI大模型赋能企业跨端远程办公与文件处理、大模型企业本地化部署与数据安全实践、文档版本管理、RAG、企业知识库、远程协作

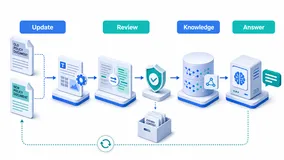
图1:文件变更并不只是“保存新版本”,更需要识别受影响的人、任务与流程。
一、最容易被忽略的协作成本:旧文件还在被使用
远程办公中,一份文件的修改常常会引发连锁问题。
例如,交付方案改了一个时间节点,销售还在引用旧报价;客户需求调整了一个字段,研发任务却没有同步;制度文件更新后,员工手机端仍保存着旧 PDF。
这类问题的难点不在于“文件能否上传”,而在于系统是否知道:
- 新旧版本到底改了什么;
- 这处修改关联哪些项目、任务和人员;
- 哪些人需要确认;
- 哪些旧文件应停止继续使用。
这也是 AI大模型赋能企业跨端远程办公与文件处理 的一个实用方向:把“文件变更”从静态存储,变成可追踪、可确认的协作事件。
本节结论:文件管理的终点不是存起来,而是让正确的人及时使用正确的版本。
二、文档变更影响分析应如何分层
| 架构层 | 输入内容 | 核心职责 | 输出结果 |
|---|---|---|---|
| 文件接入层 | 网盘、PC、手机、企业 IM | 接收文件与版本更新 | 文件来源记录 |
| 版本识别层 | 新旧文档、更新时间、作者 | 识别新增、删除、修改内容 | 差异片段 |
| 关系映射层 | 项目、客户、任务、负责人 | 找到受影响对象 | 影响范围清单 |
| 大模型分析层 | 差异片段与关联资料 | 解释变更可能带来的业务影响 | 待确认建议 |
| 通知审计层 | 人员、任务状态、处理结果 | 推送、确认、留痕 | 审计记录 |
推荐的数据流如下:
新文件上传
↓
与上一版本进行差异比对
↓
提取修改的章节、字段、日期与责任信息
↓
按项目 / 客户 / 部门查找关联任务
↓
大模型生成“变更影响说明”
↓
负责人确认是否通知、是否更新任务
↓
记录最终处理结果
这里有一个原则:大模型可以提示“可能受影响”,但不能自动替企业修改合同、承诺交付时间或发送客户通知。
本节结论:AI 负责扩大检查范围,业务负责人仍应掌握最终确认权。
三、给文档补齐元数据,才能分析影响范围
如果系统只保存文件名和正文,即使模型能识别修改内容,也很难找到受影响的人。建议每个文件或分片至少保留以下字段:
{

  "document_id": "project-a-delivery-plan",
  "version": "v4",
  "previous_version": "v3",
  "project_id": "project-a",
  "customer_id": "customer-x",
  "department": "delivery",
  "owner": "zhangsan",
  "effective_date": "2026-07-30",
  "status": "active",
  "classification": "internal",
  "related_tasks": ["task-102", "task-119"]
}
其中,related_tasks 不一定要完全自动生成。团队可以先通过项目编号、客户编号、文件负责人等基础字段建立关联,再逐步引入语义检索补充“潜在关联”。
本节结论:没有元数据的文件只是内容,有元数据的文件才能参与协作流程。
四、提示词要让模型输出“待确认项”,而不是直接下结论
下面是一套适合文档变更分析的提示词:
你是企业文档变更分析助手。

请根据“新旧版本差异”和“关联项目资料”输出变更影响清单。

要求:
1. 只能依据提供的资料判断;
2. 不得编造客户承诺、负责人或交付时间;
3. 区分“已确认影响”和“待人工确认影响”;
4. 每项结论都标明引用的文件名称与版本;
5. 不得处理当前用户无权限访问的资料。

输出字段:
- 修改内容
- 关联文件 / 任务
- 影响等级
- 建议确认人
- 依据来源
例如,文档中的交付日期从“8 月 15 日”修改为“8 月 22 日”,模型应提示关联任务和负责人,而不是直接告诉客户“项目延期”。
本节结论:提示词越强调依据与待确认项,系统越不容易把推测当成事实。
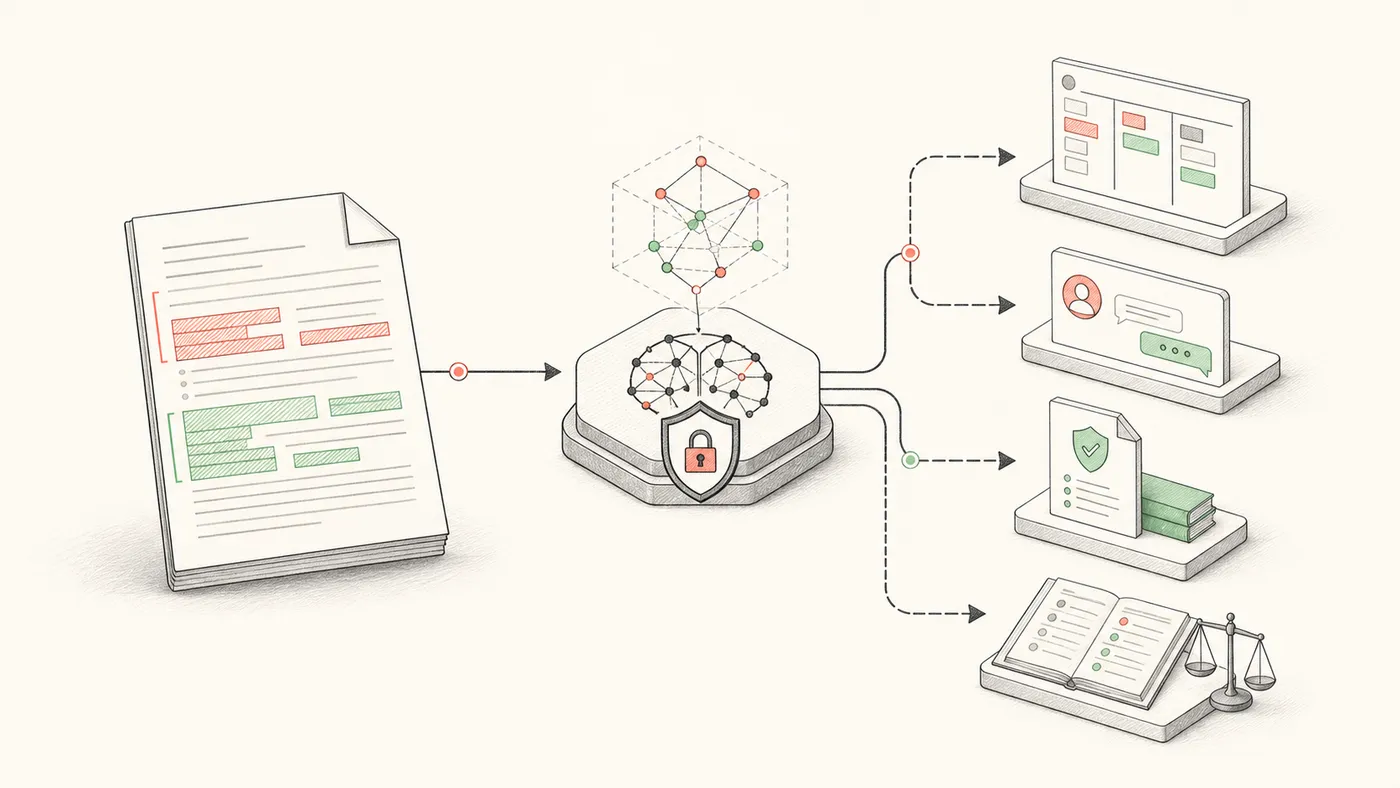
图2:一次文件修改可能影响任务、沟通、合规记录等多个对象。
五、公有云 API、混合云、私有化部署对比
| 部署方式 | 优点 | 局限 | 适用场景 |
|---|---|---|---|
| 公有云 API | 接入快,适合快速验证差异摘要能力 | 需控制上传文件范围 | 公开资料、低敏感内部文件 |
| 混合云 | 可将敏感文件保留在内网,模型能力弹性扩展 | 集成链路更复杂 | 项目资料较多的企业 |
| 私有化部署 | 文件、索引、推理与审计可统一管理 | 算力和运维投入较高 | 高敏感、高频文档处理场景 |
在 大模型企业本地化部署与数据安全实践 中,最容易犯的错误是:为了追求“智能”,先把全部历史文件导入。更稳妥的做法是,先选择一类高频、版本问题明显、敏感等级较低的文件进行试点。
本节结论:先验证版本治理和权限边界,再扩大模型覆盖范围。
六、小型企业落地案例:先从交付计划开始
以下为虚拟案例。
某 45 人项目服务团队,每周都会更新交付计划,但销售、交付和客户成功团队经常引用不同版本。团队决定先只接入“项目交付计划”这一类文件,并统一要求填写项目编号、版本号、负责人和生效日期。
系统上线后,每次出现新版计划,先自动提取差异,再根据项目编号查找关联任务。大模型生成一份“可能受影响清单”,由项目经理确认后通知相关负责人。
试点两周后,团队没有追求自动化发通知,而是先解决了两个基础问题:旧版本能被识别,修改原因能被追溯。
本节结论:小范围试点的价值,是验证流程是否可靠,而不是追求一次性全自动。
七、上线前检查清单
- 文件是否有唯一编号、版本号与生效时间;
- 是否能关联项目、客户、部门和负责人;
- 权限是否在检索前完成过滤;
- 模型输出是否明确区分“已确认”和“待确认”;
- 是否保留新旧版本与处理记录;
- 是否建立旧文件归档或失效机制;
- 是否允许负责人对 AI 建议进行确认、驳回和反馈。
本节结论:能回溯、能确认、能纠错,才是企业文件智能化真正可持续的标准。
总结
文件更新不应只是一条“已修改”的消息。通过版本差异、元数据关联、权限过滤与大模型分析,企业可以更清楚地知道:一处修改影响了什么、谁需要确认、哪些旧信息应该停止使用。
对于刚开始尝试的团队,建议从一个文件类型、一个项目组、一个明确的版本问题开始。把基础治理做扎实,再让 AI 参与更多跨端远程办公与文件处理工作。
本文由智能体来了围绕企业 AI 应用实践整理,仅供技术交流与方案设计参考。
参考资料与行业白皮书
阿里云 PAI 模型部署文档
https://help.aliyun.com/zh/pai/model-deployment阿里云 OpenSearch RAG 知识库问答文档
https://help.aliyun.com/zh/open-search/search-platform/user-guide/building-knowledge-base-online-q-a-based-on-rag阿里云 PAI 知识库管理文档
https://help.aliyun.com/zh/pai/knowledge-base-management《中华人民共和国数据安全法》
https://www.npc.gov.cn/npc/c2/c30834/202106/t20210610_311888.html《中华人民共和国个人信息保护法》
https://www.cac.gov.cn/2021-08/20/c_1631050028355286.htm
建议阿里云标签: 大模型、RAG、远程办公、文档管理、数据安全、知识库、PAI