
这句话是我们一个业务负责人在季度复盘会上说的。他当时的语气不是愤怒,是疲惫。
两年时间,IT 部门牵头做了三轮数据治理工具的选型和上线。每一次立项都有充分的理由,每一次汇报都有漂亮的 PPT,每一次验收都完成了既定指标。然而到了业务端,财务拿到的数还是经常对不上,销售的报表还是要手工校验,管理层开会问一个数字还是要等。
工具没少换,问题没少交,数据质量原地踏步。
这这件事到底卡在哪里?后来我们花了很长时间才想明白:很多企业做数据治理,最大的问题不是工具不够先进,而是从一开始就把问题想简单了。

一 工具本身不是问题所在
每次选型失败之后,团队的第一反应都是工具选错了。于是重新调研,重新评测,重新上线新工具。这个逻辑听起来合理,但它的前提假设是错的——默认数据质量差是工具能力不足导致的。
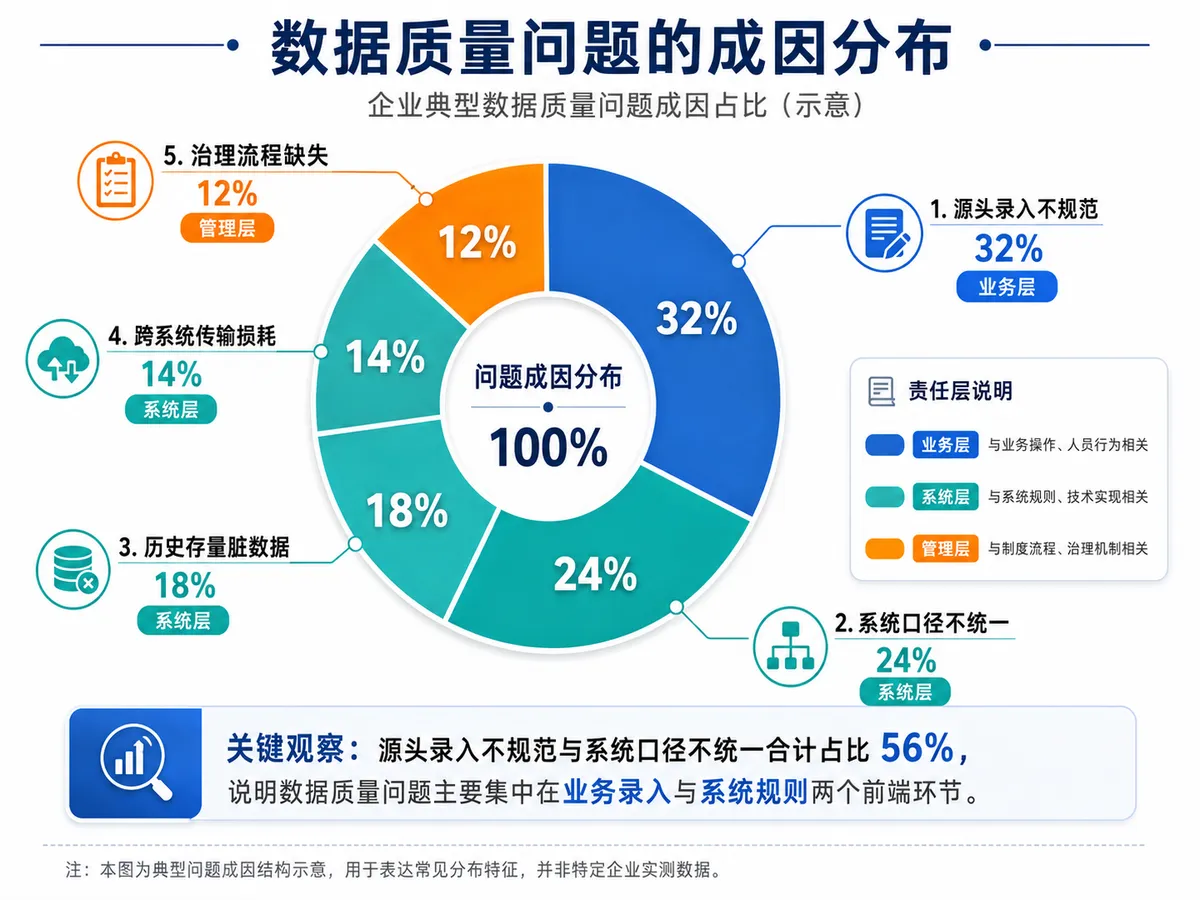
实际情况往往是另一回事。数据质量差,根子通常在数据产生的源头,而不是在治理工具上。
业务人员在 ERP 里录入数据时,字段填写不规范;不同系统对同一个业务概念的定义不一致,比如收入的确认时点,财务系统和业务系统各用各的口径;历史数据迁移时做了妥协,留下了大量格式不统一的存量脏数据;跨部门的数据交换没有统一标准,每个部门按自己的习惯传数据。
这些问题的性质,是组织层面的数据行为问题,工具检测得到,但工具解决不了。
换一个更强的 AI 治理工具,它能更精准地发现异常、更快速地标记问题,但问题被发现之后,还是要靠人去追溯、去修正、去推动源头改变录入习惯。如果这个环节没有人负责,问题发现了也是白发现,下个月还会出现同样的脏数据。
这就是为什么工具换了三轮,质量还是差。治理工具解决的是发现和监控问题,解决问题本身需要的是流程和责任。
二 AI 工具解决了哪些问题,解决不了哪些
这两年三个工具都没有白用,客观说,它们在某些环节确实有效果。
异常检测的效率提升了。 人工校验一张报表可能要两个小时,AI 工具扫一遍只需要几秒,覆盖面也更全,不容易漏掉边角字段的异常。对于规则清晰的数据质量问题,比如金额字段出现负值、日期格式不统一、必填字段为空,AI 的识别准确率很高,基本能替代人工。
字段映射和格式标准化也有改善。 多个系统的数据汇聚时,AI 能自动识别语义相近的字段,做初步的映射建议,减少了数据工程师手工对照的工作量。
但有一类问题,三个工具都没能真正解决——业务规则层面的数据逻辑校验。
举个具体的例子。财务系统里某个月的收入数据完全符合格式规范,没有空值,没有异常字符,AI 工具扫描全部通过。
但业务负责人一眼就看出这个数字不对,因为那个月有一笔大客户的合同提前确认收入了,按实际发货节奏这笔钱不该在这个月。这类问题,数据本身没有格式错误,错的是业务逻辑判断。
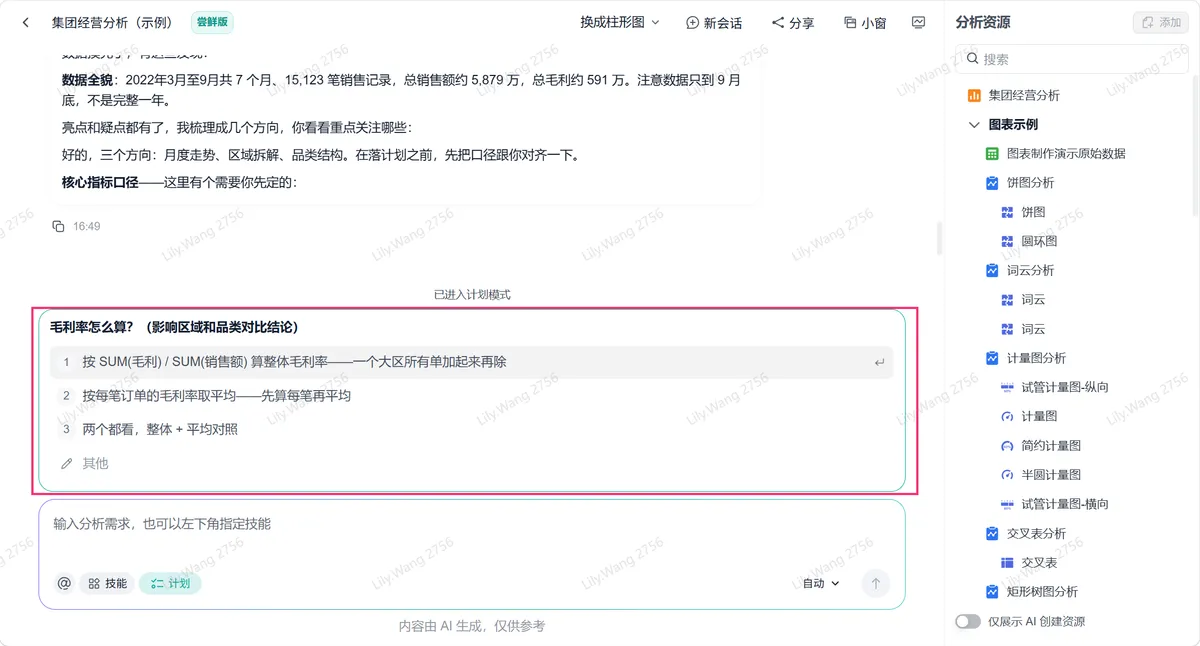
AI 工具没有业务背景,它不知道这家客户的合同条款,不知道收入确认的内部规则,所以发现不了这类异常。这类问题的校验,需要熟悉业务的人来设定规则,而不是依赖 AI 自动学习。
AI 能做好的,是结构化规则下的自动执行。AI 做不好的,是需要业务判断的软性逻辑。 把这两件事混淆,是选型期望过高的核心原因。
三 数据治理失败的真实原因清单
回头复盘这两年,失败的原因并不神秘,每一条都能找到具体的时间节点和责任人。
数据标准先于工具,但我们把顺序搞反了。 上工具之前,应该先把企业级的数据标准定清楚——核心指标怎么定义、口径怎么统一、各业务线遵循哪套规范。我们当时急于上线工具,标准没定好就开始用,结果工具在检测数据质量时,连判断标准本身都是模糊的。
治理工作没有业务部门参与,变成了 IT 的单打独斗。 数据质量的问题发生在业务侧,解决也要靠业务侧配合改变行为。但两年里,业务部门基本上是被动响应,接到数据问题通知就修,没有真正理解为什么要治理、治理结果跟自己有什么关系。这种参与度,注定了治理效果是短暂的。
没有建立数据质量的持续考核机制。 第一轮治理结束后,数据质量指标短暂上升,然后缓慢回落。因为没有把数据质量纳入业务部门的日常考核,改善的动力只在专项治理期间存在,项目一结束,老习惯就回来了。
这三条合在一起,再好的工具也救不了。工具只是放大器,基础不扎实,放大的是问题本身。
四 第三轮之后,我们换了一个思路
第三个工具上线半年之后,数据团队负责人找我谈了一次。他的判断是:再换工具没有意义,问题不在工具上。这个判断是对的。我们随后做了几件事,方向从换工具变成了补基础。
数据标准重新梳理了一遍,这次拉上了财务、销售、供应链的业务负责人一起参与,把核心的三十个业务指标逐一定义清楚,形成了一份所有部门共同认可的口径文档。这件事花了将近两个月,但它是后续所有工作的基础。
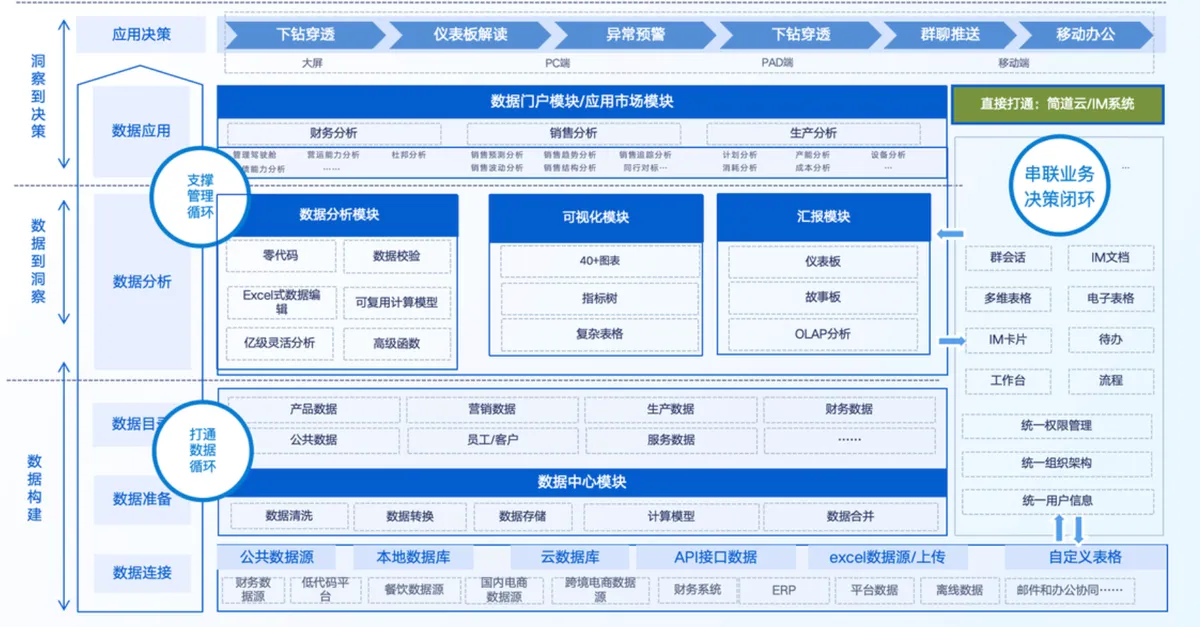
在分析层,我们引入了 FineBI Next 来重建管理层的数据消费体验。FineBI Next 相比上一代产品,在数据准备层的能力做了比较大的升级
——它支持在数据集层面直接做字段映射、口径统一和清洗规则配置,业务人员进来看到的指标是已经按标准口径处理好的,不会再出现同一个指标在不同报表里数字不一致的情况。
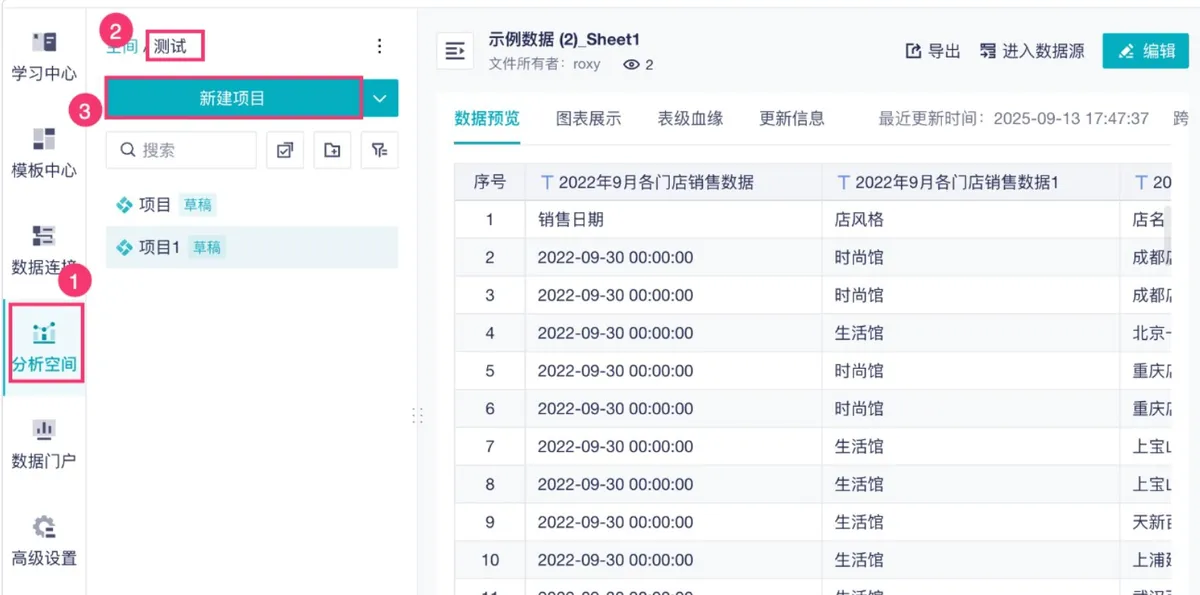
更关键的是它的 AI 辅助分析能力。 FineBI Next 内置了智能问数功能,业务人员用自然语言描述想看的数据,系统自动生成对应的查询和图表,不需要找数据团队取数,也不需要自己写 SQL。对于管理层经常问的那类临时性问题——比如某个区域上个月的毛利率是多少、哪个产品线的回款周期最长——这个功能基本可以直接给出答案,响应速度从过去的一天变成了几分钟。
数据质量的监控告警也接入了 FineBI Next 的看板,核心指标的异常波动会实时触发提醒,管理层在看经营数据时,如果某个数字背后有数据质量问题,系统会直接标注,不需要人工去排查。这个设计让数据质量的管理从后台变成了前台可见,业务部门的重视程度也跟着提高了。
五 数据治理的本质是一个管理问题
说到底,数据治理能不能成,技术只占三成,管理占七成。
技术层面需要做好的事,归结起来就两件:一是把数据标准定清楚,二是把工具选对、用对。这两件事做好了,技术不会成为瓶颈。
管理层面的挑战要难得多。数据质量的责任要落到具体的人,不能只归到 IT 部门;业务部门要有动力维护自己产生的数据质量,这需要考核机制来撑着;跨部门的口径统一需要有人有权力拍板,不能靠各部门自己协商,协商的结果通常是谁都不让步。工具能做的,是在管理机制建立之后,把执行效率提上来。
管理机制没有,工具只是一个花钱的摆设。换了三个工具还是不行,这件事本身其实是一个信号
——每次换工具,都是在回避真正需要解决的管理问题。把换工具当成解法,比承认组织问题要容易得多。但结果摆在那里,两年、三个工具、质量还是烂,这个代价比认真处理一次管理问题要贵得多。
六 下一轮该怎么做
给准备启动或重启数据治理的团队几个具体建议,都是踩过坑之后总结出来的。
立项前先做一件事: 把数据质量最差的五张报表拿出来,逐一追溯问题是从哪个环节产生的。这个动作做完,八成能找到真正的问题根源,也能判断当前阶段最需要解决的是什么。
工具选型时,重点评估两个能力: 一是它能不能支持业务自定义校验规则,能处理业务逻辑层面的质量检查;二是它的分析层能不能把口径管理内置进去,让数据消费方看到的数字天然就是标准化的。这两个能力,是我们在经历了三轮失败之后才真正想清楚的选型标准。
治理工作一定要设立业务侧的负责人,不能只有 IT 侧的项目经理。 数据从哪里来,问题就要由谁来负责,这个责任归属要在项目立项时就写清楚,不能等到出了问题再推。
数据治理没有终点,它是一项持续运营的工作。把它当项目做,做完就散,质量一定会回落。把它当日常运营做,建立稳定的监控和响应机
