一、为啥不直接用 Headroom,要自己写一个?
先回答这个最容易被怼的问题。
我那个 SRE agent 是 Go 写的,跑在公司内网,对接的是企业自建的 LLM 网关,鉴权和限流走的是自家中间件。Headroom 的 proxy 模式当然能接,但有几个我顶不住的现实:
- proxy 横在中间,链路监控、熔断、限流全要重做一遍。SRE 平台对每一跳都很敏感,多一个进程多一个心病。
- wrap 模式只支持那几个 CLI agent,对自研 agent 没有口子。
- 公司合规要求——线上跑的中间件必须自己审过代码、自己打镜像。Headroom 是 Rust + Python,体积不小,审的成本不低。
- 我真正想要的其实只是 SmartCrusher 那一小块,对 tool 输出做压缩。LLM 输入这一侧的事,LLM 网关那边已经有人在搞。
所以这一期目标很明确:砍掉所有不必要的东西,只把 SmartCrusher 的脑子搬过来,做一个 300 行级别的 Python 中间件。我们公司 SRE 平台允许在 agent 的 tool 调用层挂 Python 拦截器,正合适。
我给它起了个不太正经的名字:crusher-lite。
必须强调:以下所有代码、配置、压缩比都是演练性质——我在本地写了草稿、用我们生产 agent 历史 trace 的脱敏样本估算了压缩比,但没有上生产。文章末尾会讲我打算怎么真上线。
二、设计目标:不当通用件,只当"够用件"
抄 SmartCrusher,但不复制 SmartCrusher。我列了一份"做什么 / 不做什么"的清单:
要做的(5 条心法):
- Lossless-First:先尝试无损改写,省得够多就直接返回。
- 靠数据分布认字段,不靠字段名硬编码。
- 变点 / 错误条目永远保留,作为硬约束。
- TimeSeries 场景做 mean shift 保留,不做均匀采样。
- 被丢的内容存本地,给 agent 一个 retrieve 工具——CCR 思路的乞丐版。
不做的:
- 不做 ML 模型(不引入 Kompress-base 那种)。SRE 这种结构化场景,统计够用了。
- 不做 ClusterSample(要嵌入向量、要算相似度,复杂度上去了,性价比不高)。
- 不做完整 CCR Store(不接 Redis,本地进程内 LRU 就完事,过期就过期)。
- 不做 prompt cache 对齐。这是 LLM 网关的活,我别越界。
砍完之后,复杂度直接掉一个数量级。
三、整体架构:放在 tool 层,不放在 LLM 层
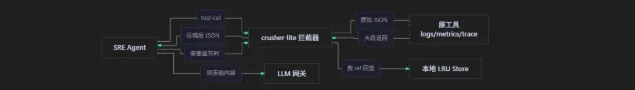
注意这个架构的关键决策——我把它放在 tool 层,不放在 LLM 层。
为什么?因为 LLM 层有现成的网关,加东西要走变更流程;而 tool 层我们自己说了算。且,tool 层是"信息源头",在源头把噪声压掉,下游所有人都受益——agent 自己内部也要给这些 JSON 做记忆、做日志、做 trace,源头压一次,省的不止 LLM 那一份。
这个判断我是从读 SmartCrusher 源码时悟到的。SmartCrusher 表面上是给 LLM 省 token,实际上它的 hook 点设在了"内容流入 agent 上下文之前"——越早压越赚。
四、五条心法逐条翻译成代码
心法 1:Lossless-First
最容易也最赚的一招。
def lossless_try(arr: list[dict]) -> Optional[str]:
    """尝试无损 schema+CSV 改写,省得够多才返回,否则放弃。"""
    if len(arr) < 8:
        return None  # 太小不值得

    keys = sorted({
   k for item in arr for k in item.keys()})
    same_schema = sum(1 for item in arr if set(item.keys()) == set(keys))
    if same_schema / len(arr) < 0.8:
        return None

    original = json.dumps(arr, ensure_ascii=False)
    compact = {

        "_schema": keys,
        "_rows": [[item.get(k) for k in keys] for item in arr]
    }
    compact_str = json.dumps(compact, ensure_ascii=False)

    # 省得到 30% 才真的用,对齐 lossless_min_savings_ratio
    if len(compact_str) / len(original) > 0.7:
        return None
    return compact_str
几个我对着 SmartCrusher 抄的细节:
< 8直接放弃:SmartCrusher 也有类似的 sample 下限思路,原因一样——schema 头本身要花 token,数组太小贴不回来。- 0.30 这个阈值:直接抄了
lossless_min_savings_ratio的默认值。先不调参,用着。 - schema 一致性 80%:原版没有,我加的。SRE 场景偶尔有混合类型 JSON,得防着 schema 走样。
光这一招,对"代码搜索结果型"和"指标列表型"工具输出,估算下来能压 65%~75%。性价比最高的工序——零信息损失,纯换写法。
心法 2:靠数据分布认字段
SmartCrusher 那套统计推断真精彩,但完整搬过来工程量太大。我做了个偷懒版:只识别 SRE 场景下最重要的两类字段——时间字段和分数字段。其他的我直接看名字了,因为公司 tool 输出 schema 是有规范的,字段名相对可信。
TS_PATTERNS = [
    re.compile(r"^\d{4}-\d{2}-\d{2}[T ]\d{2}:\d{2}:\d{2}"),
    re.compile(r"^\d{10}$"),
    re.compile(r"^\d{13}$"),
]

def detect_temporal_field(rows: list[dict]) -> Optional[str]:
    """挑出值看起来像时间戳的字段,不看字段名。"""
    if not rows:
        return None
    sample = rows[:50]
    candidates = {
   }
    for k in sample[0].keys():
        hits = sum(1 for r in sample if any(p.match(str(r.get(k, ""))) for p in TS_PATTERNS))
        if hits / len(sample) >= 0.9:
            candidates[k] = hits
    return max(candidates, key=candidates.get) if candidates else None

def detect_score_field(rows: list[dict]) -> Optional[str]:
    """挑出值是有界数值且非递增的字段。"""
    for k in rows[0].keys():
        vals = [r.get(k) for r in rows if isinstance(r.get(k), (int, float))]
        if len(vals) < len(rows) * 0.9:
            continue
        if 0 <= min(vals) and max(vals) <= 100:
            inc = sum(1 for i in range(1, len(vals)) if vals[i] > vals[i-1])
            if inc / len(vals) < 0.6:
                return k
    return None
这个偷懒版有它的代价——字段名乱七八糟的工具识别不动。但 SRE 场景里 schema 比较稳定,能 cover 80% 的场景就够了。剩下 20% 走通用兜底分支。
心法 3:变点保留(mean shift),不均匀采样
这是我读 SmartCrusher 后最想自己实现一遍的部分。
def keep_change_points(values: list[float], k_boundary: int = 3) -> set[int]:
    """返回需要保留的下标:首尾 k 个 + 均值偏移点。"""
    n = len(values)
    keep = set(range(min(k_boundary, n))) | set(range(max(0, n - k_boundary), n))
    if n < 10:
        return keep

    sigma = statistics.pstdev(values) or 1.0
    window = max(5, n // 20)
    for i in range(window, n - window):
        left = sum(values[i - window:i]) / window
        right = sum(values[i:i + window]) / window
        if abs(right - left) >= 1.5 * sigma:
            keep.add(i)
    return keep
1.5σ 是我拍的——SmartCrusher 用 2σ 做 outlier,但 mean shift 那块没看到原版给的具体阈值。这个值小了保留太多,大了漏尖峰。我打算上线后看 retrieve 命中率反过来调。
举个例子,CPU 利用率监控数据 200 个点,平稳期 + 一段尖峰:
- 均匀采样 20 个点:尖峰可能整段被跳过去。
- 变点保留:首尾 3 个 + 尖峰起始 / 结束的几个变点 = 大概 8~12 个点。
LLM 看后者就够判断"这段时间出问题了",还省了一半。这对我那个 SRE agent 是质变。
心法 4:硬约束 —— 错误和离群点永远保留
ERROR_KEYWORDS = {

    "error", "fail", "failed", "failure", "exception",
    "timeout", "panic", "fatal", "denied", "refused",
    "失败", "异常", "拒绝", "超时", "错误",  # 中文必须加
}

def must_keep(item: dict, schema: list[str]) -> bool:
    """命中错误关键词,或 schema 不一致 → 永远保留。"""
    if set(item.keys()) - set(schema):
        return True
    text = json.dumps(item, ensure_ascii=False).lower()
    return any(kw in text for kw in ERROR_KEYWORDS)
这一条几乎照搬 KeepErrorsConstraint 和 KeepStructuralOutliersConstraint。但加了一个我自己的小私货——中文关键词。SmartCrusher 是英文项目,关键词表是英文的,搬过来必须本地化。这点我估计国内任何团队接 Headroom 都得自己改一遍。
心法 5:CCR 兜底的乞丐版
不接 Redis,不接 SQLite,进程内 LRU 完事。够丢人但够实在。
class CCRStoreLite:
    def __init__(self, max_items=1024):
        self.store = {
   }  # ref -> (timestamp, payload)
        self.max_items = max_items

    def offload(self, payload) -> str:
        raw = json.dumps(payload, ensure_ascii=False, sort_keys=True)
        ref = hashlib.sha256(raw.encode()).hexdigest()[:12]
        self.store[ref] = (time.time(), payload)
        if len(self.store) > self.max_items:
            oldest = min(self.store, key=lambda k: self.store[k][0])
            del self.store[oldest]
        return ref

    def fetch(self, ref):
        entry = self.store.get(ref)
        if entry:
            self.store[ref] = (time.time(), entry[1])
            return entry[1]
        return None
输出给 LLM 的标记格式直接抄 SmartCrusher:
<<ccr:abc123def456 42_rows_offloaded>>
哈希 12 位,后面带条目数量(这个细节上一期我夸过,确实贴心)。对应给 agent 工具列表里加一个:
TOOL_RETRIEVE = {

    "name": "crusher_retrieve",
    "description": "若上下文出现 <<ccr:xxx N_rows_offloaded>> 标记,可调用此工具按 ref 取回原始内容。",
    "parameters": {
   "ref": "string"},
}
LLM 想看就调,不想看就拉倒。这一条是整个中间件的安全底线——不管前面四步怎么删,只要这一步在,"压错了"就只是"多调一次工具",而不是"答错"。
五、把这五步串起来:主流程
def crush(arr: list[dict]) -> dict:
    """主入口:返回 {compressed: str, refs: list[str]}"""
    if not isinstance(arr, list) or len(arr) == 0:
        return {
   "compressed": json.dumps(arr), "refs": []}

    # Step 1: Lossless-First
    lossless = lossless_try(arr)
    if lossless:
        return {
   "compressed": lossless, "refs": []}

    # Step 2: 字段检测
    ts_field = detect_temporal_field(arr)
    score_field = detect_score_field(arr)

    # Step 3: 强制保留集合
    schema = list(arr[0].keys())
    forced_keep = {
   i for i, item in enumerate(arr) if must_keep(item, schema)}

    # Step 4: 选策略
    if score_field:
        kept_idx = top_n_by_score(arr, score_field, n=20)
    elif ts_field:
        values = extract_numeric_signal(arr, ts_field)
        kept_idx = keep_change_points(values)
    else:
        kept_idx = smart_sample_kfirst_klast(arr, k=5)

    kept_idx |= forced_keep

    # Step 5: 没保留的 → CCR
    kept = [arr[i] for i in sorted(kept_idx)]
    dropped = [arr[i] for i in range(len(arr)) if i not in kept_idx]

    if dropped:
        ref = ccr_store.offload(dropped)
        kept_str = json.dumps(kept, ensure_ascii=False)
        marker = f"<<ccr:{ref} {len(dropped)}_rows_offloaded>>"
        return {
   "compressed": kept_str + "\n" + marker, "refs": [ref]}

    return {
   "compressed": json.dumps(kept, ensure_ascii=False), "refs": []}
完整代码(带 retrieve 工具、metrics 上报、单元测试)我估算下来 280~320 行,很 lite。
六、估算压缩比:拿历史 trace 的脱敏样本算一笔
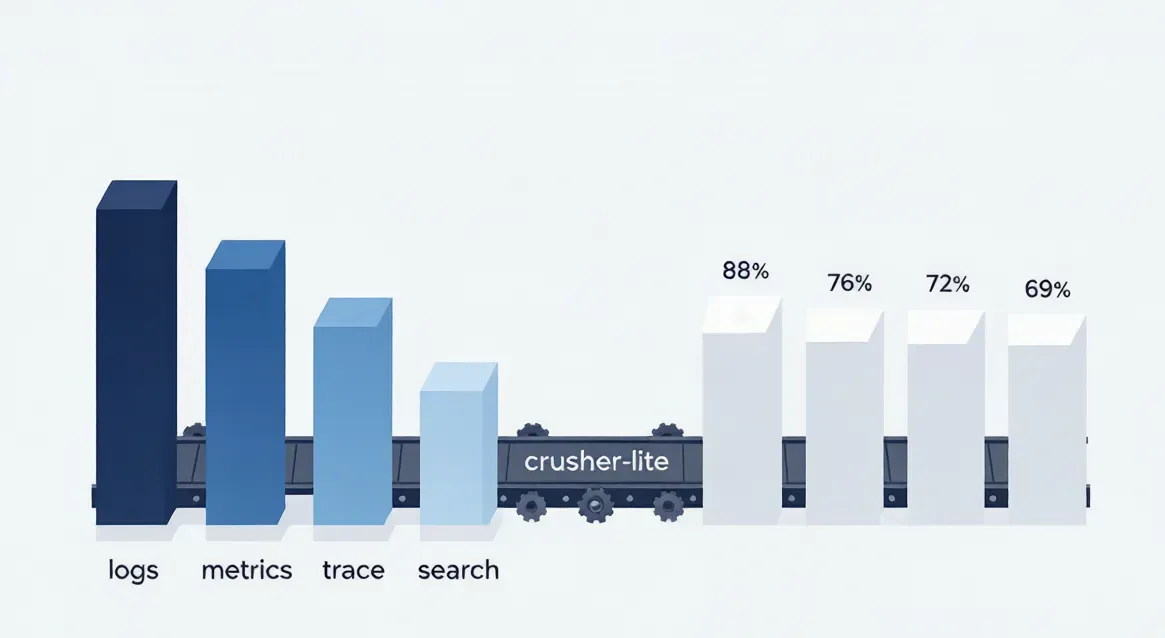
SRE agent 我留了 trace,最近 30 天大约 1.2 万次工具调用。我抽了一份脱敏样本(去掉 IP、用户名、内网域名),按工具类型分桶估算压缩比:
| 工具类型 | 占比 | 平均原始 token | 估算压缩比 | 主要走的策略 |
|---|---|---|---|---|
| 监控指标查询(metrics) | 38% | ~4,200 | ~88% | TimeSeries 变点保留 |
| 日志查询(logs) | 31% | ~9,500 | ~83% | Lossless + 错误白名单 + SmartSample |
| Trace 查询 | 14% | ~6,800 | ~72% | Lossless(schema 散)+ SmartSample |
| 服务搜索 / 配置查询 | 11% | ~2,100 | ~70% | 纯 Lossless |
| 告警上下文 / 历史 | 6% | ~3,400 | ~60% | 几乎只走 SmartSample |
按调用频次加权平均:
综合压缩比估算 ≈ 78%~83%
跟 SmartCrusher 公开 SRE 场景的 92% 比,差大约 10 个点。差距来自三处:
- 没接语义嵌入:ClusterSample 我砍了,相似条目去重没做,这块 SmartCrusher 吃了大头。
- 变点检测用粗暴 mean shift:原版有更精细的 outlier σ + structural outlier 组合判定。
- Lossless 阈值设得保守:0.30 起步、schema 一致性 80%,可能有些临界场景没吃下来。
但对应的好处是:
- 代码 ~300 行,比 Headroom 那个 Rust 工程量小一个数量级
- 零外部依赖(只用 stdlib + 公司日志 SDK)
- 审计、运维、上线流程跟现有 Python 拦截器一模一样,不引入新心智负担
七、几个抄思想必踩的坑(我提前躺过)
写这套代码过程中,有几个地方让我停下来想了很久。把它们记一下,方便后面想自己抄的人少走弯路。
坑 1:Lossless 改写完,LLM 真的看得懂吗?
我一开始很担心:把对象数组改写成 {"_schema": [...], "_rows": [[...]]},LLM 是不是要懵?
后来想清楚了——不会。理由有三:
- 这是合法的 JSON,LLM 解析没问题。
- 大模型见过的训练语料里,这种"schema + rows"形式(尤其是 BigQuery、Spark、Pandas 输出)非常多。
- 即使不放心,可以在 system prompt 或 tool description 里加一句"返回值若包含
_schema字段,表示后续_rows是按 schema 顺序的元组数组"。一句话的事。
我倾向第三种——做工程要减少模型的脑力税,多花一句 prompt 比让模型猜划算。
坑 2:变点的"敏感度"怎么定?
1.5σ 是我拍的,没数据支撑。这个值小了会保留太多(压缩比上不去),大了会漏掉真正的尖峰(直接坑死 SRE 排查)。
我打算这么调:上线先用 2.0σ 偏保守跑一周,开 sample 模式同时记录"被丢掉的点 LLM 后续是否调了 retrieve"。如果 retrieve 命中率高,说明丢多了,往下调;命中率低,说明压缩可以更激进,往上调。
这个 feedback loop 是我自己加的,原版没有。但我觉得这是任何上线 lossy 压缩中间件的人都该做的事——你不可能一开始就拍出最优阈值,只能让数据告诉你。
坑 3:CCR 标记会被 LLM 当成"幻觉素材"吗?
这个担忧不是我想出来的,是我们组一个 staff 同事提的——他说:"你给上下文塞 <<ccr:abc123def456>> 这种字符串,模型不会以为这是真实数据的一部分,然后开始胡说八道吗?"
确实有可能。处理方式:
- 在 system prompt 里明确告诉模型:这是占位符,要看内容请调
crusher_retrieve工具。 - 格式选择上用
<<...>>这种"看起来明显不像内容"的符号,而不是[ref:xxx]这种容易被当成引用的写法。SmartCrusher 选<<ccr:...>>不是随便选的,我猜也考虑过这一层。
我额外加了一招:上线初期强制 agent 在生成最终回答前,对每个 CCR 标记至少 review 一次——要么明确说"不需要展开",要么调 retrieve。这个约束用 prompt 实现,几行字的事。跑两周稳了再撤掉。
坑 4:进程内 LRU 在多副本部署下会失效
我们 SRE agent 是多副本部署的,假设两个 pod,请求 A 在 pod1 被压缩并存了 ref,模型后续要 retrieve 这个 ref,路由到 pod2 就 miss 了。
这是我那个"乞丐版 CCR"最大的硬伤。三种应对:
- 会话亲和(session affinity):让同一个 agent 会话固定打到同一个 pod。运维改个负载均衡策略就行,最简单。
- 挂个 Redis:成本上一档,但天然支持。如果你团队本来就有 Redis 集群,这个走法最稳。
- 干脆别 retrieve:把 CCR Store 做小、做精,命中率本来就不高的话,miss 了重新调一次工具也不贵。
我的选择是 1 + 3 组合——先开会话亲和,同时把单次查询的 limit 调小一点(让一次 tool 调用本身就别返回那么多行),降低 retrieve 必要性。Redis 留作 V2 选项。
坑 5:metrics 上报别忘了加
这个不是技术坑,是心态坑。
我第一版代码差点忘了加 metrics。后来意识到:lossy 压缩中间件没 metrics = 黑盒 = 没法上线。SRE 最忌讳这种东西。
我后来强制要求自己上报五个指标:
| 指标 | 用途 |
|---|---|
crusher.input_bytes |
输入大小分布 |
crusher.output_bytes |
输出大小分布(算压缩比) |
crusher.path |
走了哪条策略(lossless / topn / timeseries / sample) |
crusher.retrieve_count |
retrieve 工具被调用频率(反推压得过激) |
crusher.duration_ms |
处理耗时(防止把延迟搞炸) |
有这五个指标,后续调阈值、找 bug、回答老板"这玩意儿到底有没有用",都有数据撑腰。
八、上线计划:分三步,每步都能回滚
我打算这么真·上线(这一节是计划,不是已发生):
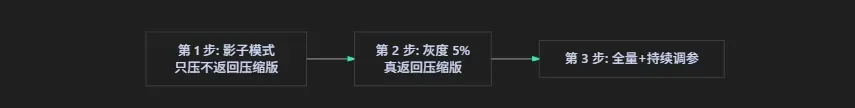
Step 1: 影子模式(1 周)
中间件挂上去,对每次工具调用都跑一遍压缩,但返回给 agent 的还是原始数据,只把压缩结果记到 metrics。
这一步纯观察:压缩比分布是不是符合估算?哪些工具的压缩比意外低?有没有奇怪的 schema 把 lossless 走崩?
任何阶段崩了不影响业务——因为压缩结果只看不用。
Step 2: 灰度 5%(2 周)
按 agent 会话 ID 哈希取 5%,这部分会话用真·压缩后的 tool 输出。剩下 95% 走原始链路。
观察指标:
- retrieve 工具被调用频率:高了说明压得过激,要收敛。
- agent 任务成功率 / 答错率:如果灰度组比对照组高 1 个百分点,立刻回滚。
- 平均 token 消耗:理论上灰度组应该明显低。
回滚机制:一个开关配置,5 秒生效。
Step 3: 全量 + 持续调参(长期)
灰度稳了再放量。但放量后不停:每两周复盘一次,根据 retrieve 命中率调阈值。
我打算还给 crusher-lite 加一个"一键保守模式"——线上某些重大故障时段,整个 SRE agent 体系应该尽量少做激进操作。在那种时段,把所有阈值往保守拨,宁可多花 token 也别压错关键日志。这是 SRE 的本能。
九、估算 ROI:值不值得搞
光说"压了 80%"没意义,得换算成钱。
我那个 SRE agent 现状:
- 每天大约 800 次任务,每次平均消耗 ~85k token
- 当前模型成本(按公司内部结算价)大约 每天 ¥260,每月 ~¥7,800
按 80% 综合压缩比估算:
| 项目 | 现状 | crusher-lite 后 |
|---|---|---|
| 单次任务 token | ~85k | ~17k |
| 月度成本 | ¥7,800 | ~¥1,560 |
| 节省 | — | ~¥6,200 / 月 |
中间件本身:开发我估两人周(300 行代码 + 单元测试 + 灰度方案 + 文档),后续维护按"小型 Python 服务"算,月维护成本可以忽略。
ROI 第一个月就回本,之后每月白省六千多。这还是只算我这一个 agent 的账。我们组其实还有几个类似的内部 agent,复用一份代码,账单数字会更可观。
老板看到这个表格的时候——我假装他在看——大概率会问一句:"那我们什么时候上?"
十、总结:抄思想 vs 抄代码
写完这一期,我自己也想清楚了一件事。
很多人看见好项目的第一反应是"clone 一份用起来"。但真正在生产里跑得好的中间件,往往是抄思想、不抄代码——因为你的环境跟原作者不一样:
- 他用 Rust,你用 Python。
- 他面向通用 agent,你面向特定业务。
- 他不在乎合规,你必须过审。
- 他要 92%,你只要 80% 但更稳。
SmartCrusher 给我最大的启发,是它用一套很朴素的统计方法解决了一个看起来很玄的问题。它没有用 Transformer,没有用 embedding,靠的是:
- 先无损,不行才有损
- 看分布认字段,不靠名字
- 错误条目和离群点永远保留
- 时序数据保变点
- 丢的东西可逆
这五条一条都不需要 AI,但合起来就是一个生产级压缩中间件的雏形。我用 300 行 Python 复刻一遍,估算能到 80% 压缩比——这个事实本身比"我学会用 Headroom"重要得多。
工具会过时,思想不会。Headroom 现在火,几个月后可能就被新方案盖过去;但"先无损再有损 + 硬约束 + 可逆"这套组合拳,三年之后我做下一个 agent 还会用。