MySQL Cluster(现官方称:MySQL NDB Cluster)是一个高可用、高性能的数据库解决方案,它通过分布式数据存储来提高读写性能和数据冗余度。MySQL Cluster采用NDB(Network Database)存储引擎,支持实时处理大量并发操作,特别适合于电信、金融等需要高可靠性和高性能的行业应用。
视频讲解如下
一、 MySQL Cluster的功能特性
- 高可用
MySQL Cluster具有内置的高可用性功能,可以自动检测和恢复故障。它支持故障检测和节点恢复,以确保集群中的数据和服务可用性。
- 分布式存储
NDB存储引擎支持将数据分布在多个节点上,实现了数据的分布式存储。这意味着数据可以水平扩展,从而提高了存储容量和性能。
- 实时处理
MySQL Cluster旨在支持实时数据处理,特别适用于需要低延迟和高吞吐量的应用程序,如电信、在线游戏和金融领域。
- 自动分区
NDB存储引擎支持自动分区,可以根据数据分布自动将数据分割成多个分区,以实现负载均衡和高性能。
- 动态扩展
MySQL Cluster支持动态添加和删除节点,因此可以根据需求扩展集群。
- 事务支持
MySQL Cluster支持ACID(原子性、一致性、隔离性和持久性)事务,确保数据的一致性和可靠性。
- 并行查询
NDB存储引擎支持并行查询,允许同时执行多个查询以提高性能。
- 多地域复制
MySQL Cluster支持跨地域的数据复制,使数据在不同地理位置之间进行同步,以提高数据冗余和可用性。
二、 MySQL Cluster的体系架构
MySQL Cluster的体系架构如下:
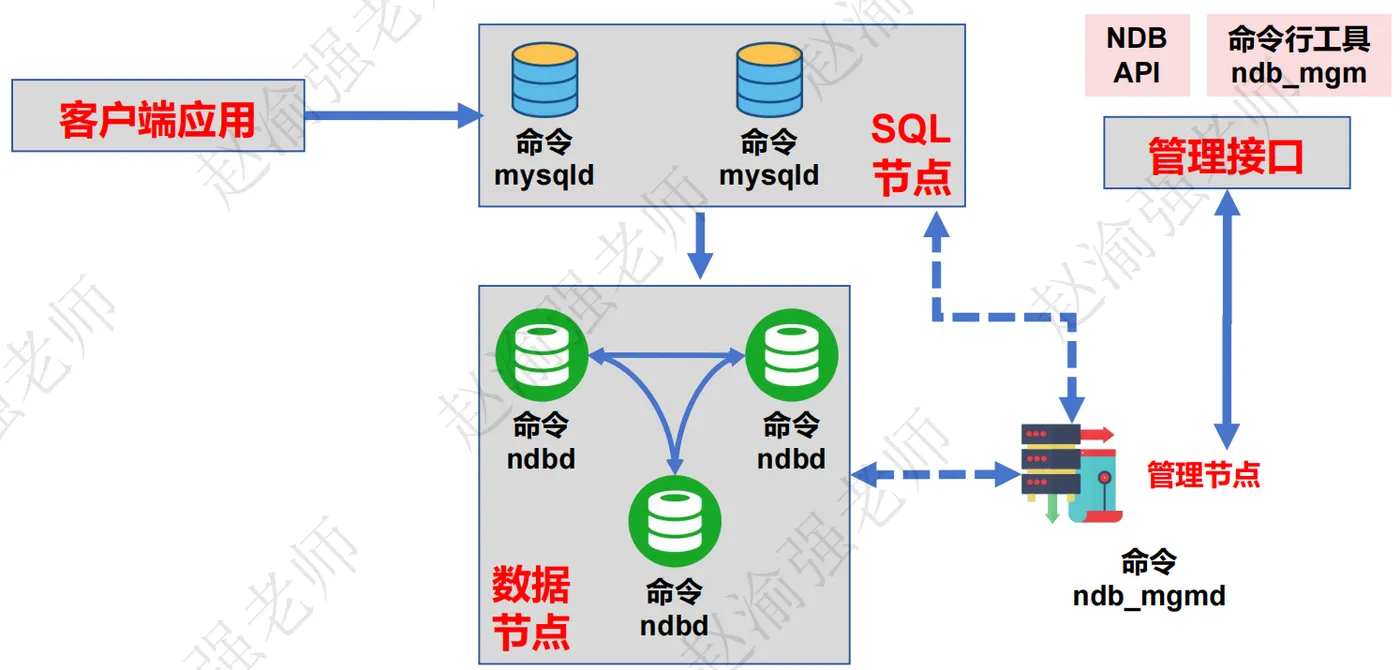
其中:
- SQL Node
SQL节点主要负责实现一个数据库在存储层之上的所有事情,比如:连接管理,Query优化和响应,Cache管理等等,只有存储层的工作交给了数据节点去处理。也就是说,在MySQL Cluster环境中的SQL Node,可以被认为是一个不需要提供任何存储引擎的MySQL服务器,只要用于执行SQL语句。
- Management Node
管理节点的作用是管理集群中的其他节点,提供配置数据、启动和停止节点以及运行备份等功能。因为这种类型的节点管理其他节点的配置,所以应该首先启动这种类型的节点,然后再启动任何其他节点。使用命令ndb_mgmd启动管理节点。
- Data Node
数据节点主要实现底层数据存储的功能。每一个数据节点保存完整数据的一个fragment,也就是一个数据分片(或者一份完整的数据),所以只要配置得当,MySQL Cluster在存储层不会出现单点的问题。使用命令ndbd或ndbmtd启动数据节点。
三、 部署MySQL Cluster
下面的表格列举了集群中的节点信息(操作系统:银河麒麟Linux)。
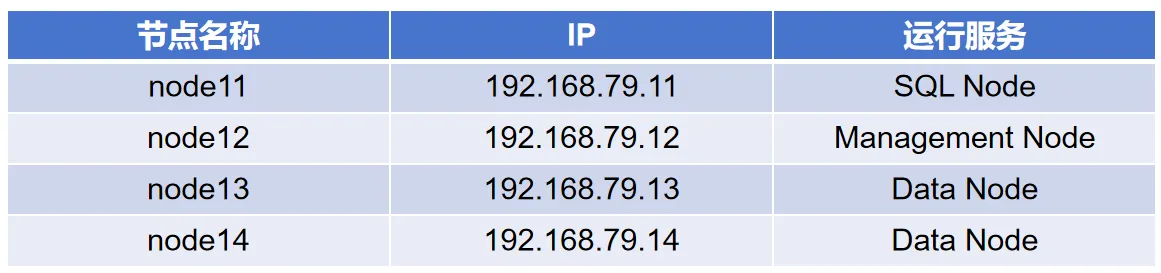
安装介质信息如下:
mysql-cluster-community-client-8.0.23-1.el8.x86_64.rpm
mysql-cluster-community-client-plugins-8.0.23-1.el8.x86_64.rpm
mysql-cluster-community-common-8.0.23-1.el8.x86_64.rpm
mysql-cluster-community-data-node-8.0.23-1.el8.x86_64.rpm
mysql-cluster-community-libs-8.0.23-1.el8.x86_64.rpm
mysql-cluster-community-management-server-8.0.23-1.el8.x86_64.rpm
mysql-cluster-community-server-8.0.23-1.el8.x86_64.rpm
具体的安装步骤如下:
(1)所有节点关闭防火墙
systemctl stop firewalld
systemctl disable firewalld
(2)所有节点编辑/etc/selinux/config文件关闭SELinux
SELINUX=enforcing
修改为
SELINUX=disabled
(3)所有节点编辑/etc/hosts文件配置主机名与IP地址映射关系
192.168.79.11 node11
192.168.79.12 node12
192.168.79.13 node13
192.168.79.14 node14
(4)所有节点卸载原有mariadb和mysql的库
# 检查是否安装了mariadb
yum list installed | grep mariadb*
# 卸载mariadb
yum remove mariadb* -y
# 检查是否安装了mysql
yum list installed | grep mysql*
# 卸载mysql
yum remove mysql* -y
(5)在node11上安装SQL Node
rpm -ivh mysql-cluster-community-client-plugins-8.0.23-1.el8.x86_64.rpm
rpm -ivh mysql-cluster-community-common-8.0.23-1.el8.x86_64.rpm
rpm -ivh mysql-cluster-community-libs-8.0.23-1.el8.x86_64.rpm
rpm -ivh mysql-cluster-community-client-8.0.23-1.el8.x86_64.rpm
rpm -ivh mysql-cluster-community-server-8.0.23-1.el8.x86_64.rpm
(6)在node12上安装Management Node和客户端管理工具
rpm -ivh mysql-cluster-community-management-server-8.0.23-1.el8.x86_64.rpm
rpm -ivh mysql-cluster-community-client-plugins-8.0.23-1.el8.x86_64.rpm
rpm -ivh mysql-cluster-community-common-8.0.23-1.el8.x86_64.rpm
rpm -ivh mysql-cluster-community-libs-8.0.23-1.el8.x86_64.rpm
rpm -ivh mysql-cluster-community-client-8.0.23-1.el8.x86_64.rpm
(7)在node13和node14上安装Data Node
rpm -ivh mysql-cluster-community-data-node-8.0.23-1.el8.x86_64.rpm
(8)在node12上配置Management Node
# 创建目录
mkdir -p /var/lib/mysql-cluster/
# 在管理节点上创建配置文件/var/lib/mysql-cluster/config.ini,添加以下内容
[NDBD DEFAULT]
NoOfReplicas=2
DataMemory=80M
IndexMemory=18M
[TCP DEFAULT]
[MYSQLD DEFAULT]
[NDB_MGMD DEFAULT]
[NDB_MGMD]
HostName=node12
DataDir=/var/lib/mysql-cluster
[NDBD]
HostName=node13
DataDir=/usr/local/mysql/data
[NDBD]
HostName=node14
DataDir=/usr/local/mysql/data
[MYSQLD]
(9)在node12上启动Management Node
ndb_mgmd -f /var/lib/mysql-cluster/config.ini --initial
# 输出的信息如下:
MySQL Cluster Management Server mysql-8.0.23 ndb-8.0.23
... [MgmtSrvr] INFO     -- The default config directory '/usr/mysql-cluster' does not exist. Trying to create it...
... [MgmtSrvr] INFO     -- Sucessfully created config directory
... [MgmtSrvr] WARNING  -- at line 4: [DB] IndexMemory is deprecated, will use Number bytes on each ndbd(DB) node allocated for storing indexes instead
(10)在node13和node14上配置Data Node
# 创建目录
mkdir -p /usr/local/mysql/data
chown -R mysql:mysql /usr/local/mysql/data
# 编辑文件/etc/my.cnf,增加下面的内容
[mysql_cluster]
ndb-connectstring=node12
(11)在node13和node14上启动Data Node
ndbd --initial
# 输出的信息如下:
[root@node13 8]# ndbd --initial
2026-05-14 17:48:36 [ndbd] INFO     -- Angel connected to 'node12:1186'
2026-05-14 17:48:36 [ndbd] INFO     -- Angel allocated nodeid: 2
[root@node14 8]# ndbd --initial
2026-05-14 17:48:39 [ndbd] INFO     -- Angel connected to 'node12:1186'
2026-05-14 17:48:39 [ndbd] INFO     -- Angel allocated nodeid: 3
(12)在node12的Management Node上查看集群的状态信息。
# ndb_mgm
-- NDB Cluster -- Management Client --
ndb_mgm> show
# 输出的信息如下:
Connected to Management Server at: localhost:1186
Cluster Configuration
---------------------
[ndbd(NDB)] 2 node(s)
id=2  @192.168.79.13  (mysql-8.0.23 ndb-8.0.23, Nodegroup: 0, *)
id=3  @192.168.79.14  (mysql-8.0.23 ndb-8.0.23, Nodegroup: 0)
[ndb_mgmd(MGM)] 1 node(s)
id=1  @192.168.79.12  (mysql-8.0.23 ndb-8.0.23)
[mysqld(API)] 1 node(s)
id=4 (not connected, accepting connect from any host)
(13)在node11上配置SQL Node
# 编辑/etc/my.cnf文件,添加以下内容:
[mysqld]
ndbcluster
ndb-connectstring=node12
[mysql_cluster]
ndb-connectstring=node12
(14)在node11上启动SQL Node
systemctl start mysqld
(15)在node12的Management Node上验证集群状态
# ndb_mgm
-- NDB Cluster -- Management Client --
# 查看集群的信息
ndb_mgm> show
# 输出的信息如下:
Cluster Configuration
---------------------
[ndbd(NDB)] 2 node(s)
id=2  @192.168.79.13  (mysql-8.0.23 ndb-8.0.23, Nodegroup: 0, *)
id=3  @192.168.79.14  (mysql-8.0.23 ndb-8.0.23, Nodegroup: 0)
[ndb_mgmd(MGM)] 1 node(s)
id=1  @192.168.79.12  (mysql-8.0.23 ndb-8.0.23)
[mysqld(API)] 1 node(s)
id=4  @192.168.79.11  (mysql-8.0.23 ndb-8.0.23)
# 查看集群的节点信息
ndb_mgm> 1 status
Node 1: connected (Version 8.0.23)
ndb_mgm> 2 status
Node 2: started (mysql-8.0.23 ndb-8.0.23)
ndb_mgm> 3 status
Node 3: started (mysql-8.0.23 ndb-8.0.23)
ndb_mgm> 4 status
Node 4: connected (Version 8.0.23)
(16)在node11的SQL Node上登录MySQL客户端
# 初始密码位于/var/log/mysqld.log文件中
# 登录后修改root用户密码
mysql> alter user root@localhost identified by 'Welcome_1';
(17)执行脚本创建分布式表
create database scott;
use scott
create table dept
(deptno int primary key,
dname varchar(10),
loc varchar(10)
) ENGINE=ndbcluster;
create table emp
(empno int primary key,
ename varchar(10),
job varchar(10),
mgr int,
hiredate varchar(10),
sal int,
comm int,
deptno int,
foreign key(deptno) references dept(deptno)) ENGINE=ndbcluster;
insert into dept values(10,'ACCOUNTING','NEW YORK');
insert into dept values(20,'RESEARCH','DALLAS');
insert into dept values(30,'SALES','CHICAGO');
insert into dept values(40,'OPERATIONS','BOSTON');
insert into emp values(7369,'SMITH','CLERK',7902,'1980/12/17',800,null,20);
insert into emp values(7499,'ALLEN','SALESMAN',7698,'1981/2/20',1600,300,30);
insert into emp values(7521,'WARD','SALESMAN',7698,'1981/2/22',1250,500,30);
insert into emp values(7566,'JONES','MANAGER',7839,'1981/4/2',2975,null,20);
insert into emp values(7654,'MARTIN','SALESMAN',7698,'1981/9/28',1250,1400,30);
insert into emp values(7698,'BLAKE','MANAGER',7839,'1981/5/1',2850,null,30);
insert into emp values(7782,'CLARK','MANAGER',7839,'1981/6/9',2450,null,10);
insert into emp values(7788,'SCOTT','ANALYST',7566,'1987/4/19',3000,null,20);
insert into emp values(7839,'KING','PRESIDENT',-1,'1981/11/17',5000,null,10);
insert into emp values(7844,'TURNER','SALESMAN',7698,'1981/9/8',1500,null,30);
insert into emp values(7876,'ADAMS','CLERK',7788,'1987/5/23',1100,null,20);
insert into emp values(7900,'JAMES','CLERK',7698,'1981/12/3',950,null,30);
insert into emp values(7902,'FORD','ANALYST',7566,'1981/12/3',3000,null,20);
insert into emp values(7934,'MILLER','CLERK',7782,'1982/1/23',1300,null,10);
(18)查询表的分片信息。
mysql> select partition_name,table_rows
      from information_schema.PARTITIONS
      where table_name='emp' and table_schema='scott';
# 输出的信息如下:
+----------------+------------+
| PARTITION_NAME | TABLE_ROWS |
+----------------+------------+
| p0             |          1 |
| p1             |         13 |
+----------------+------------+
2 rows in set (0.01 sec)
mysql> select partition_name,table_rows
       from information_schema.PARTITIONS
       where table_name='dept' and table_schema='scott';
# 输出的信息如下:
+----------------+------------+
| PARTITION_NAME | TABLE_ROWS |
+----------------+------------+
| p0             |          2 |
| p1             |          2 |
+----------------+------------+
2 rows in set (0.00 sec)
# 从输出的信息可以看出,员工表emp中共有14条数据;
# 其中13条数据被存储在了p1分片上。
# 因此使用员工号empno()主键作为片键发生了数据倾斜。
(19)创建一张新的员工表emp1,并使用员工姓名ename作为主键(片键),并插入数据。
mysql> create table emp1
       (empno int,
       ename varchar(10) primary key,
       job varchar(10),
       mgr int,
       hiredate varchar(10),
       sal int,
       comm int,
       deptno int,
       foreign key(deptno) references dept(deptno)) ENGINE=ndbcluster;

mysql> insert into emp1 select * from emp;
(20)查询emp1的数据分片情况
mysql> select partition_name,table_rows
       from information_schema.PARTITIONS
       where table_name='emp1' and table_schema='scott';
# 输出的信息如下:
+----------------+------------+
| PARTITION_NAME | TABLE_ROWS |
+----------------+------------+
| p0             |          5 |
| p1             |          9 |
+----------------+------------+
2 rows in set (0.00 sec)
# 此时的数据更加均匀地进行了分布。