
容器和虚拟机到底有什么区别?
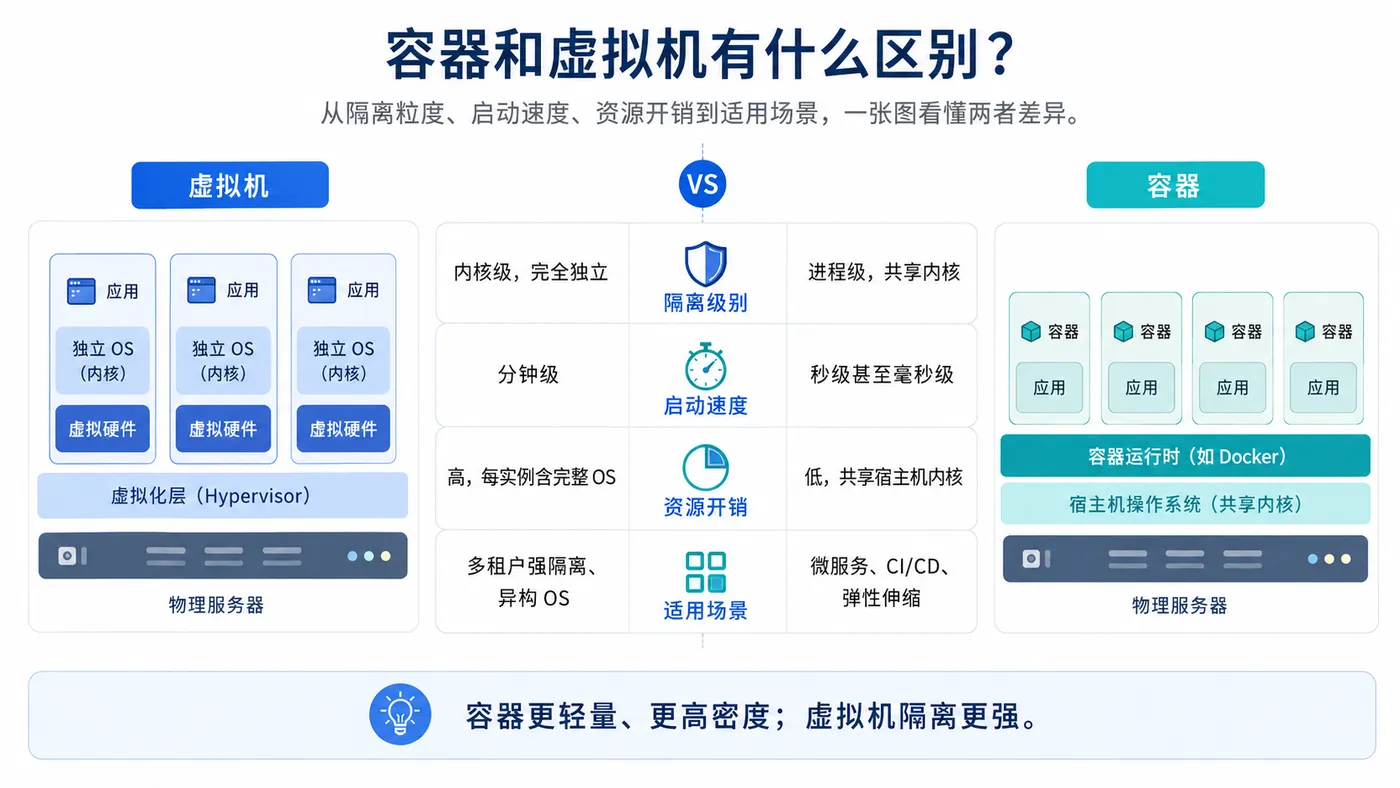
核心差异在隔离粒度:虚拟机隔离硬件资源,容器隔离进程环境。
虚拟机通过Hypervisor模拟完整操作系统内核,每个实例都要跑一套独立OS。容器直接共享宿主机内核,通过Linux的namespace和cgroup实现进程级隔离和资源限制。根据Linux基金会2024年调查数据,同等硬件条件下容器的部署密度是虚拟机的4到8倍,启动时间从分钟级缩短到秒级。
但容器并不能完全替代虚拟机。选择取决于隔离强度需求:
| 维度 | 虚拟机 | 容器 |
|---|---|---|
| 隔离级别 | 内核级,完全独立 | 进程级,共享内核 |
| 启动速度 | 分钟级 | 秒级甚至毫秒级 |
| 资源开销 | 高,每实例含完整OS | 低,共享宿主内核 |
| 适用场景 | 多租户强隔离、异构OS | 微服务、CI/CD、弹性伸缩 |
| 安全边界 | 强,内核漏洞不跨VM传播 | 弱于VM,内核漏洞影响所有容器 |
金融、政务等安全边界要求极高的场景,通常是虚拟机套容器的混合架构。纯容器方案更适合无状态服务和快速迭代的业务。
Docker在容器技术栈里处于什么位置?
Docker是容器技术的普及者,但不是容器技术的全部。
2013年Docker发布,把Linux容器技术从运维工具变成了开发者友好的产品。核心贡献有三个:标准化镜像格式、分层文件系统、一条命令启动容器的体验。但Docker本身是单机工具,解决的是"一台机器上怎么打包和运行容器",不解决"100台机器上怎么协调1000个容器"。
2015年之后,OCI规范定义了容器镜像格式和运行时接口的行业标准,运行时从Docker Engine拆分出containerd和runc。CNCF 2024年调查显示,生产环境中Docker Engine作为运行时的比例已从2019年的80%降到35%左右。
现在的容器技术栈分4层:
| 层级 | 职责 | 典型组件 |
|---|---|---|
| 用户接口层 | 构建镜像、本地调试 | Docker CLI、Podman、Buildah |
| 高级运行时 | 容器生命周期、镜像拉取 | containerd、CRI-O |
| 低级运行时 | 创建和运行容器进程 | runc、gVisor、Kata Containers |
| 内核特性 | 隔离和资源限制 | namespace、cgroup、seccomp |
Docker在这个栈里的位置是用户接口层。开发阶段用Docker构建镜像仍是主流,但生产环境运行时已逐步切到containerd。
容器运行时经历了哪些演进?
演进主线是"从一体化到分层解耦"。
早期Docker Engine把镜像管理、容器生命周期、网络、存储全部打包在一个守护进程里。大规模生产环境下会遇到单点故障、升级困难、与编排系统耦合过紧三个问题。分层解耦后,低级运行时可以按安全需求替换:
| 低级运行时 | 隔离机制 | 性能开销 | 适用场景 |
|---|---|---|---|
| runc | 标准namespace/cgroup | 最低 | 大多数通用场景 |
| gVisor | 用户态内核拦截系统调用 | 约10%到20%损耗 | 多租户、不可信代码执行 |
| Kata Containers | 轻量级虚拟机 | 启动慢约200ms | 强隔离、合规场景 |
| Firecracker | microVM | 启动约125ms | Serverless、短生命周期任务 |
日常业务用runc足够,处理不可信代码时切gVisor或Kata,Serverless场景用Firecracker。运行时层的可替换性是容器技术成熟的标志之一。
Kubernetes解决了什么问题?
Kubernetes解决的核心问题是大规模容器的自动化调度和生命周期管理。
单机跑几个容器手动管理没问题,但容器数量到几百上千、跨几十台机器部署时,需要编排系统处理5件事:调度、自愈、服务发现与负载均衡、滚动更新与回滚、配置与密钥管理。
Kubernetes的设计哲学是声明式API加控制循环。用户描述"期望状态",系统持续把"当前状态"向"期望状态"收敛。CNCF 2024年数据显示全球生产环境Kubernetes采用率达84%,但超过60%的受访企业反馈运维复杂度是落地最大挑战。"用了Kubernetes"不等于"用好了Kubernetes"。
容器云的完整技术栈包含哪些层?
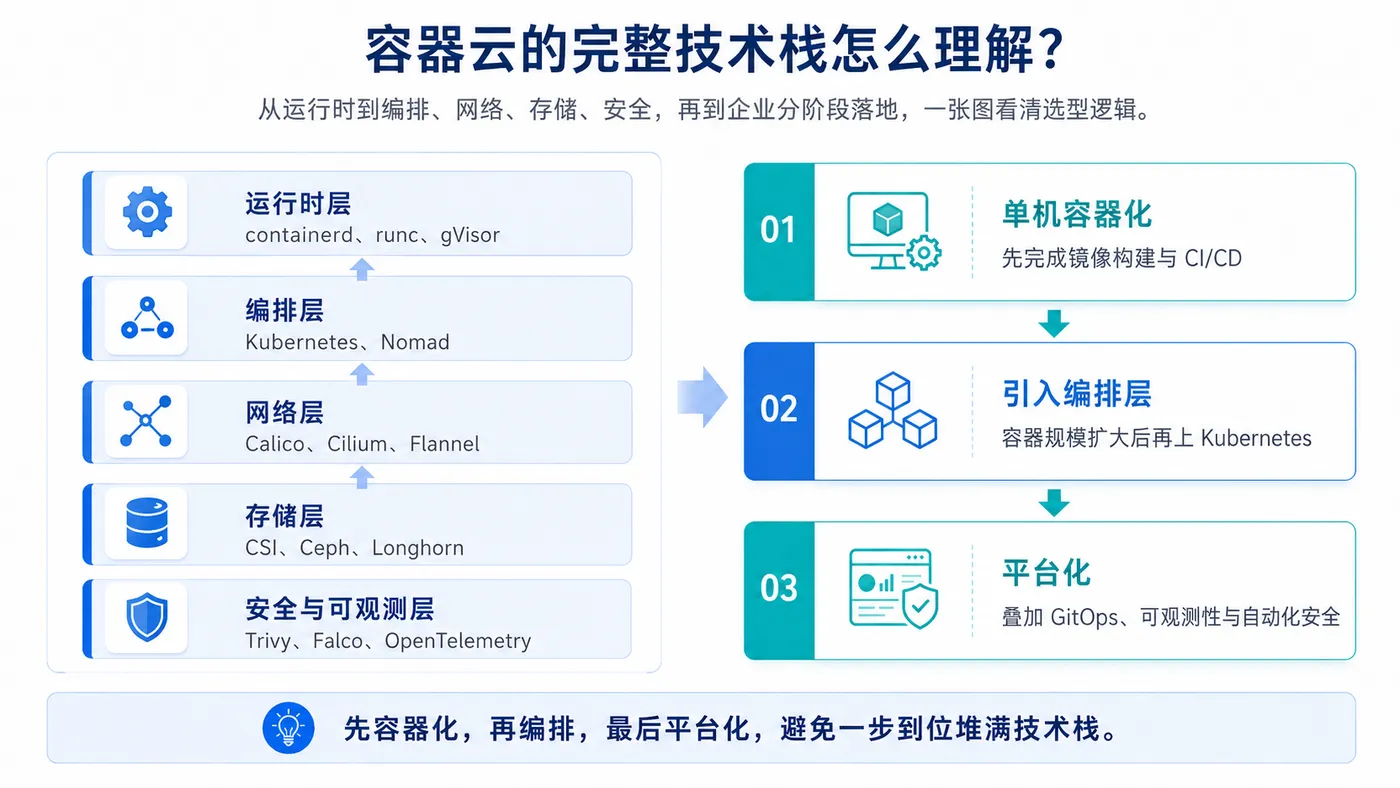
容器云是在运行时和编排之上,叠加网络、存储、安全、可观测性的完整平台。技术栈分5层:
| 层级 | 解决的问题 | 核心技术/组件 |
|---|---|---|
| 运行时层 | 容器进程的创建和隔离 | containerd、runc、gVisor |
| 编排层 | 多节点调度、自愈、弹性伸缩 | Kubernetes、Nomad |
| 网络层 | 跨节点容器通信、网络策略 | Calico、Cilium、Flannel |
| 存储层 | 有状态服务的数据持久化 | CSI接口、Ceph、Longhorn |
| 安全与可观测层 | 镜像扫描、运行时防护、追踪 | Trivy、Falco、OpenTelemetry |
网络层最容易踩坑。每个Pod有独立IP,跨节点通信需要Overlay或BGP路由方案。Cilium基于eBPF实现,大规模集群下网络策略执行效率比iptables方案高30%到50%,但学习曲线更陡。
存储层的关键选择是"有状态还是无状态"。数据库、消息队列这类有状态服务跑在容器里,对IOPS和延迟要求严格,选型时需要实际压测。
企业落地容器云该怎么分阶段推进?
最常犯的错误是一步到位。正确做法是分三步走。
第一阶段:单机容器化。 把应用打包成镜像,跑通CI/CD流水线。只需要Docker和镜像仓库,不需要Kubernetes。一个10人团队完成这个阶段通常需要2到4周。
第二阶段:编排层引入。 容器实例超过50个、需要跨3台以上机器部署时引入Kubernetes。核心任务是建立资源管理规范:namespace划分、资源配额、网络策略、RBAC权限模型。超过70%的Kubernetes生产故障源于资源配置不当。
第三阶段:平台化。 在Kubernetes之上封装内部开发者平台,屏蔽底层复杂度。引入GitOps工作流、统一可观测性方案、自动化安全扫描。
| 阶段 | 技术重点 | 常见陷阱 |
|---|---|---|
| 单机容器化 | 镜像构建规范、CI/CD集成 | 镜像过大、构建缓存未优化 |
| 编排层引入 | 资源管理、网络策略、RBAC | 资源配额未设,单Pod吃满节点 |
| 平台化 | 开发者体验、GitOps、可观测性 | 过度自建,忽视开源成熟方案 |
从单机容器化到平台化通常需要6到18个月。有状态服务多、遗留系统多的企业周期会更长。
FAQ
Q:Docker和Podman有什么区别?
Docker需要常驻守护进程管理容器,Podman是无守护进程架构,每个容器作为独立子进程运行。安全审计要求严格的环境倾向Podman,日常开发两者体验差异不大,Podman兼容Docker CLI命令。
Q:Kubernetes的最低硬件配置是什么?
单Master节点最低2核CPU、4GB内存。生产环境建议3个Master节点做高可用,每个4核8GB起。容器数量在50个以内也可以考虑K3s等轻量发行版。
Q:容器网络性能损耗大吗?
取决于插件和模式。Overlay网络延迟增加约0.1到0.5ms,吞吐量损耗约5%到15%。BGP直连路由模式接近裸机性能。eBPF方案大规模集群下表现最好,但对内核版本有要求,通常需要5.10以上。
Q:有状态服务适合跑在容器里吗?
可以,但要评估运维成本。数据库、消息队列容器化后需要处理持久化、备份恢复、主从切换。团队有成熟Operator和存储方案时弹性优势明显,否则建议先容器化无状态服务。
Q:微服务一定要用Kubernetes吗?
不一定。服务数量在10个以内、节点不超过3台时,Docker Compose或Nomad就够用了。引入Kubernetes的时机是容器实例超过50个,需要弹性伸缩或多团队共享集群资源。
Q:Serverless容器和传统编排有什么区别?
传统编排需要预先规划集群容量,Serverless容器按实际运行时间和资源消耗计费,不需要管理底层节点。适合流量波动大的业务,但冷启动延迟通常在1到5秒,长期稳定运行的服务用传统编排更划算。
