2026年,大语言模型(LLM)已成为AI应用开发的核心基础设施,但很多开发者仍陷入“只会调用API”的困境:要么用提示词解决所有问题导致效果不稳定,要么盲目微调浪费算力,要么误用RAG增加系统复杂度。本质上,LLM应用开发并非单一技术的选择,而是提示工程、RAG、微调三层能力的分层构建与组合应用——提示工程解决“怎么问”,RAG解决“问什么”,微调解决“模型本身的认知边界”。三者分别对应交互层、知识层、能力层,从低成本快速迭代到深度定制优化,形成完整的LLM应用开发技术栈。本文从核心原理、适用场景、实战代码、选型决策四大维度,全面解析这三种技术的差异与协同,帮助开发者精准选型、高效落地LLM应用。
一、LLM应用开发的三层技术栈:核心定位与本质差异
LLM应用开发的三层技术栈,本质是从“引导模型输出”到“增强模型知识”再到“重塑模型能力”的递进过程,每一层解决的问题、修改的对象、成本与效果均有本质区别,清晰认知三者边界是高效开发的前提。
(一)提示工程(Prompt Engineering):交互层,零成本引导模型输出
提示工程是LLM应用开发的基础入口,核心是通过精心设计的输入指令(提示词),引导预训练模型生成符合预期的输出,不修改模型任何参数,仅调整输入内容与格式。可以将其理解为“给模型清晰的指令手册”,让模型在固有知识范围内,按照指定规则、风格、格式完成任务。阿里云部署AI Agent:OpenClaw/Hermes Agent全网最简单,只需两步,详情👉访问阿里云OpenClaw/Hermes一键部署专题页面 了解。
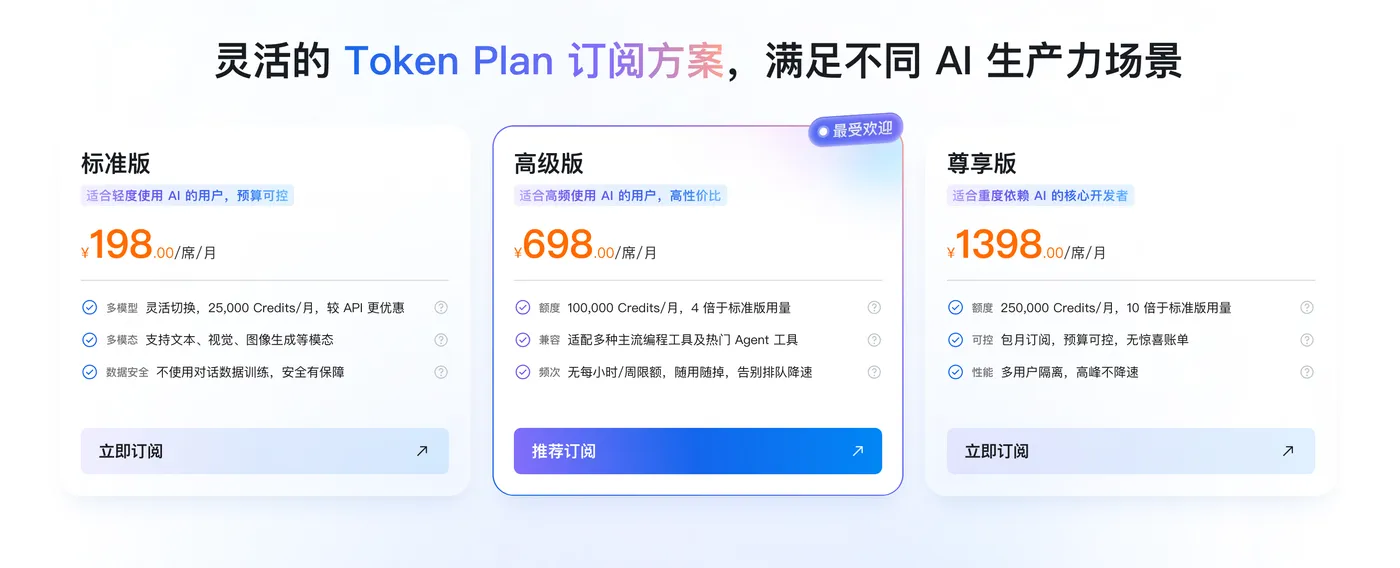
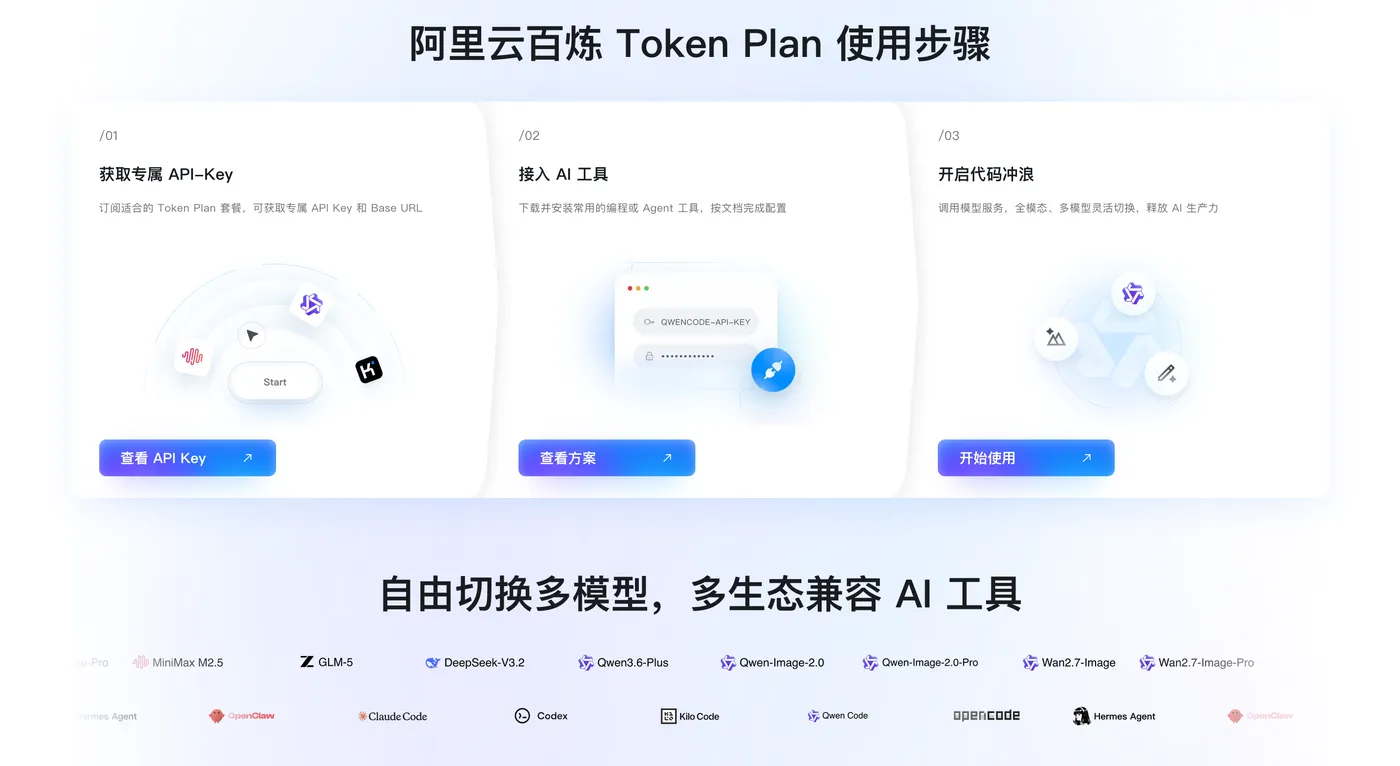
Token Plan Token最便宜/支持多模型切换:👉访问订阅阿里云百炼Token Plan AI大模型服务 。支持多模型切换,用于多模态模型灵活调用,实现多模型、多工具、多场景下的额度共享与统一管理,兼顾灵活性、稳定性与安全性,大幅降低企业使用大模型的门槛与成本。
1. 核心原理
LLM本质是概率模型,通过预测下一个token生成内容,提示词的作用是改变模型概率分布的起点,通过角色定义、任务约束、示例、思维链等方式,让模型的生成路径收敛到目标区域。例如,明确要求“以专业工程师的身份,输出JSON格式的代码注释”,模型会自动调整生成逻辑,匹配指令要求。
2. 核心能力边界
- 优势:零成本、零算力、快速迭代,几分钟即可完成原型开发;兼容所有LLM,无需额外部署;适合轻量级、通用型任务。
- 局限:无法解决模型“知识截止”问题(模型训练后新增的知识无法获取);无法深度定制模型行为(如固定输出风格、专业领域推理);复杂任务下易出现幻觉、输出不稳定;受上下文窗口长度限制,无法处理超大规模数据。
3. 适用场景
- 通用文本处理:内容创作、摘要、翻译、改写、简单问答。
- 格式/风格定制:要求输出JSON、Markdown、表格,或指定语气(如正式、口语化、专业)。
- 快速原型验证:无需复杂知识,仅需验证模型基础能力。
- 低预算场景:无额外算力与数据成本,适合个人开发者与小型项目。
(二)RAG(检索增强生成):知识层,动态注入外部知识
RAG是LLM应用开发的核心增强层,核心是在模型生成答案前,先从外部知识库(向量数据库)检索相关信息,将检索结果作为上下文注入提示词,让模型基于“外部权威知识”生成答案,不修改模型参数,仅动态扩展模型知识边界。可以将其理解为“给模型配备实时更新的知识库”,解决模型知识滞后与幻觉问题。
1. 核心原理
RAG的完整流程分为离线构建与在线推理两步:
- 离线构建:将企业文档、行业数据、实时资讯等外部知识,进行清洗、分块(500-1000字符,重叠200字符)、向量化(通过Embedding模型),存储到向量数据库(如Milvus、Chroma)。
- 在线推理:用户提问→将问题向量化→向量数据库检索Top-K相似知识片段→将知识片段与用户问题拼接为提示词→LLM基于上下文生成答案。
2. 核心能力边界
- 优势:解决知识截止问题,支持毫秒级知识更新;大幅减少幻觉,答案可溯源;无需训练模型,成本低于微调;可处理超大规模知识库,突破上下文窗口限制。
- 局限:无法定制模型固有行为(如输出风格、推理逻辑);依赖检索质量,检索不相关会导致答案错误;引入检索延迟,系统复杂度高于提示工程;无法让模型深度内化领域知识。
3. 适用场景
- 知识密集型问答:企业内部文档查询、行业政策解读、产品手册问答。
- 实时/动态知识场景:新闻资讯、市场数据、政策更新(知识频繁变化)。
- 高可信度场景:法律、金融、医疗等需要权威依据、减少幻觉的领域。
- 超大规模数据处理:知识库超过百万级文档,无法通过提示词直接注入。
(三)微调(Fine-tuning):能力层,深度重塑模型认知
微调是LLM应用开发的高级定制层,核心是使用领域专属数据集,对预训练模型进行二次训练,修改模型内部权重参数,让模型深度内化领域知识、固定输出行为、提升特定任务精度。可以将其理解为“给模型进行专业培训”,让模型从“通用能力”升级为“领域专属能力”。
1. 核心原理
微调分为全参数微调与轻量化微调(LoRA、QLoRA):
- 全参数微调:更新模型所有参数,效果最优,但需要海量数据(百万级)与高算力(A100/H100集群),成本极高。
- 轻量化微调(主流):仅训练模型的少量参数(如LoRA的注意力层参数),用千级高质量数据即可实现显著效果,显存占用降低90%,训练时间缩短80%,成为2026年企业级微调的主流方案。
2. 核心能力边界
- 优势:深度内化领域知识,模型推理速度更快(无需检索);固定输出风格与格式,一致性极高;复杂领域任务精度显著提升;支持边缘部署(无网络、低算力场景)。
- 局限:需要高质量标注数据(千级起);有算力与时间成本(训练需数小时到数天);知识更新困难(需重新训练);复杂度最高,需专业机器学习能力。
3. 适用场景
- 领域专属任务:医疗诊断、法律文书生成、金融风控、工业故障诊断(需要深度领域知识)。
- 高一致性需求:固定输出格式、风格,批量处理任务(如每天处理数万份合同)。
- 边缘/离线场景:嵌入式设备、无网络环境,需要本地快速推理(延迟<50ms)。
- 极致性能需求:提示工程+RAG无法满足精度要求,需要模型深度优化。
(四)三层技术栈核心对比(2026年)
| 维度 | 提示工程 | RAG | 微调 |
|---|---|---|---|
| 修改对象 | 输入提示词 | 外部知识库 | 模型权重参数 |
| 知识来源 | 模型预训练知识 | 外部向量数据库 | 训练数据集(内化) |
| 成本 | 几乎为零 | 中等(向量库+检索) | 高(数据+算力+时间) |
| 迭代速度 | 秒级/分钟级 | 分钟级(知识库更新) | 小时级/天级(训练) |
| 知识更新 | 不支持 | 实时/毫秒级 | 需重新训练 |
| 幻觉控制 | 弱 | 强(可溯源) | 中(依赖数据质量) |
| 适用复杂度 | 低/中 | 中/高 | 高/极致 |
| 部署难度 | 极低 | 中 | 高 |
二、提示工程实战:从基础到进阶的提示词设计
提示工程是LLM应用开发的起点,掌握高效提示词设计方法,可快速实现80%的轻量级任务需求。2026年,提示工程已形成标准化范式,核心遵循“角色+任务+约束+格式+示例”五要素结构,配合思维链、少样本学习等进阶技巧,大幅提升输出稳定性。
(一)基础提示词模板(通用场景)
# 基础提示词:角色+任务+约束+格式
system_prompt = """
你是一位专业的{角色},擅长{核心能力}。
请完成以下任务:{具体任务描述}。
约束条件:
1. 输出必须{格式要求,如JSON、Markdown、纯文本};
2. 内容需{准确性/简洁性/专业性}要求,禁止编造信息;
3. 长度控制在{最小}-{最大}字符内;
4. 避免使用{禁忌词汇/格式}。
请基于以上要求,生成符合规范的结果。
"""

# 示例:生成专业技术文档摘要
user_prompt = "请对以下技术文档生成100字以内的精准摘要,突出核心功能与技术亮点:{文档内容}"
(二)进阶提示词:少样本学习(Few-Shot)
少样本学习通过提供2-3个示例,让模型模仿输出模式,适合格式固定、需要一致性的任务。
# 少样本提示词:示例+任务
few_shot_prompt = """
示例1:
输入:分析用户反馈“产品加载慢,界面卡顿”
输出:{"问题类型":"性能问题","核心诉求":"提升加载速度与界面流畅度","优先级":"高"}

示例2:
输入:分析用户反馈“功能按钮找不到,操作流程复杂”
输出:{"问题类型":"体验问题","核心诉求":"简化操作流程,优化按钮布局","优先级":"中"}

请按照以上格式,分析以下用户反馈并输出JSON:
输入:{用户反馈内容}
输出:
"""
(三)高级提示词:思维链(Chain-of-Thought)
思维链引导模型先输出推理过程,再给出答案,大幅提升复杂逻辑、数学、推理任务的准确性。
# 思维链提示词:推理过程+答案
cot_prompt = """
请解决以下问题,步骤如下:
1. 先明确问题核心,拆解关键条件;
2. 逐步分析推理,列出每一步的逻辑;
3. 基于推理结果,给出最终答案。

问题:某企业2025年营收1000万,2026年营收增长25%,2027年预计在2026年基础上增长15%,请问2027年预计营收是多少?
"""
(四)提示工程实战代码(Python调用LLM)
import os
from openai import OpenAI

# 初始化LLM客户端(兼容OpenAI API,如Qwen系列)
client = OpenAI(
    api_key=os.getenv("LLM_API_KEY"),
    base_url="https://your-llm-api-endpoint.com/v1"
)

# 设计高质量提示词(五要素+思维链)
prompt = """
你是专业的Python开发工程师,擅长编写高效、可维护的代码。
请完成以下任务:编写一个基于FastAPI的RESTful API,实现用户注册与登录功能,包含数据验证、JWT认证、错误处理。
约束条件:
1. 输出完整可运行代码,附带详细注释;
2. 代码需符合PEP8规范,结构清晰;
3. 包含接口测试示例;
4. 禁止使用未声明的依赖库。

请先梳理代码结构与实现逻辑,再输出完整代码。
"""

# 调用LLM生成结果
response = client.chat.completions.create(
    model="qwen2.5-7b-instruct",
    messages=[{
   "role": "user", "content": prompt}],
    temperature=0.3,  # 低temperature提升输出稳定性
    max_tokens=4096
)

# 输出结果
print("提示工程生成的代码:")
print(response.choices[0].message.content)
三、RAG实战:从知识库构建到检索生成的全流程
RAG是解决LLM知识滞后与幻觉的核心方案,2026年已形成标准化技术栈:LangChain/LlamaIndex+向量数据库+Embedding模型,以下为完整实战流程与代码实现。
(一)RAG技术栈选型(2026年主流)
- 框架:LangChain(生态完善,适合快速开发)、LlamaIndex(专注检索,性能更优)
- Embedding模型:BGE-m3、text-embedding-ada-002(通用场景)、领域专属Embedding模型(专业场景)
- 向量数据库:Milvus(企业级,高性能)、Chroma(轻量级,开源免费)、FAISS(本地快速检索)
(二)RAG全流程实战代码
import os
import chromadb
from langchain.vectorstores import Chroma
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.llms import OpenAI
from langchain.chains import RetrievalQA

# 1. 初始化配置
os.environ["OPENAI_API_KEY"] = "your-llm-api-key"
LLM_API_BASE = "https://your-llm-api-endpoint.com/v1"

# 2. 加载并处理知识库文档(示例:企业产品手册)
def load_knowledge_base(file_path):
    with open(file_path, "r", encoding="utf-8") as f:
        content = f.read()
    # 文本分块:500字符/块,重叠200字符,避免语义断裂
    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=500,
        chunk_overlap=200,
        length_function=len
    )
    chunks = text_splitter.split_text(content)
    return chunks

# 3. 构建向量数据库
def build_vector_store(chunks):
    # 初始化Embedding模型(BGE-m3,通用场景最优)
    embeddings = HuggingFaceEmbeddings(model_name="BAAI/bge-m3")
    # 初始化Chroma向量库(本地存储)
    vector_store = Chroma.from_texts(
        texts=chunks,
        embedding=embeddings,
        persist_directory="./chroma_db"
    )
    vector_store.persist()
    return vector_store

# 4. 构建RAG检索生成链
def build_rag_chain(vector_store):
    # 初始化LLM
    llm = OpenAI(
        temperature=0.2,
        max_tokens=1024,
        api_base=LLM_API_BASE
    )
    # 构建检索QA链:检索Top-3相关文档,生成答案
    rag_chain = RetrievalQA.from_chain_type(
        llm=llm,
        chain_type="stuff",
        retriever=vector_store.as_retriever(search_kwargs={
   "k": 3}),
        return_source_documents=True  # 返回来源文档,实现可溯源
    )
    return rag_chain

# 5. 主流程执行
if __name__ == "__main__":
    # 加载知识库(替换为你的文档路径)
    knowledge_chunks = load_knowledge_base("./product_manual.txt")
    # 构建向量库
    vector_store = build_vector_store(knowledge_chunks)
    # 构建RAG链
    rag_chain = build_rag_chain(vector_store)
    # 执行RAG问答
    query = "产品的核心功能有哪些?支持哪些操作系统?"
    result = rag_chain.invoke({
   "query": query})
    # 输出结果与来源
    print("RAG生成的答案:", result["result"])
    print("\n答案来源文档:")
    for idx, doc in enumerate(result["source_documents"]):
        print(f"{idx+1}. {doc.page_content[:100]}...")
(三)RAG实战关键要点
- 文本分块:避免过大(超过模型上下文)或过小(语义断裂),500-1000字符+200字符重叠为最优配置。
- Embedding模型选择:通用场景用BGE-m3,领域场景用专属模型(如医疗、法律),提升检索相关性。
- 检索参数:Top-K设为3-5,平衡相关性与上下文长度;检索后可增加重排序(Rerank)步骤,进一步提升质量。
- 知识库更新:支持增量添加文档,无需重新构建全量向量库,实现实时知识更新。
四、微调实战:轻量化LoRA微调的完整流程
2026年,轻量化微调(LoRA/QLoRA)已成为企业级LLM定制的主流方案,无需海量数据与超高算力,即可实现模型深度优化。以下基于Qwen 2.5-7B模型,实现LoRA微调的完整实战代码。
(一)微调环境配置
- 硬件:单卡A100(40G)或消费级3090Ti(24G,QLoRA)
- 框架:Transformers、PEFT、Datasets、Accelerate
- 模型:Qwen 2.5-7B-Instruct(开源,适合微调)
(二)LoRA微调实战代码
import os
import torch
from datasets import Dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    TrainingArguments,
    Trainer
)
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training

# 1. 配置参数
MODEL_NAME = "Qwen/Qwen2.5-7B-Instruct"  # 基础模型
DATA_PATH = "./domain_data.json"  # 领域数据集(指令+输入+输出)
OUTPUT_DIR = "./lora_finetuned_model"  # 微调模型输出路径
LORA_R = 16  # LoRA秩(常用8-32)
LORA_ALPHA = 32  # LoRA缩放因子
LORA_DROPOUT = 0.05
BATCH_SIZE = 4
EPOCHS = 3
LEARNING_RATE = 2e-4

# 2. 加载并预处理数据集
def load_dataset(data_path):
    # 数据集格式:[{"instruction":"...","input":"...","output":"..."}, ...]
    import json
    with open(data_path, "r", encoding="utf-8") as f:
        data = json.load(f)
    # 转换为Hugging Face Dataset格式
    dataset = Dataset.from_list(data)
    return dataset

# 3. 数据格式化(适配Qwen模型指令格式)
def format_data(example):
    prompt = f"指令:{example['instruction']}\n输入:{example['input']}\n输出:{example['output']}"
    return {
   "text": prompt}

# 4. 初始化模型与Tokenizer
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
tokenizer.pad_token = tokenizer.eos_token  # 设置填充token

# 加载4-bit量化模型(QLoRA,节省显存)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_NAME,
    load_in_4bit=True,
    device_map="auto",
    torch_dtype=torch.bfloat16
)
model = prepare_model_for_kbit_training(model)

# 5. 配置LoRA参数
lora_config = LoraConfig(
    r=LORA_R,
    lora_alpha=LORA_ALPHA,
    target_modules=["q_proj", "v_proj"],  # 微调注意力层参数
    lora_dropout=LORA_DROPOUT,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()  # 打印可训练参数(通常<1%)

# 6. 数据预处理
dataset = load_dataset(DATA_PATH)
dataset = dataset.map(format_data)

# 7. 配置训练参数
training_args = TrainingArguments(
    output_dir=OUTPUT_DIR,
    per_device_train_batch_size=BATCH_SIZE,
    num_train_epochs=EPOCHS,
    learning_rate=LEARNING_RATE,
    logging_steps=10,
    save_strategy="epoch",
    optim="paged_adamw_8bit",
    fp16=True,
    report_to="none"
)

# 8. 初始化Trainer并开始训练
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=dataset
)
trainer.train()

# 9. 保存微调后的LoRA模型
model.save_pretrained(OUTPUT_DIR)
tokenizer.save_pretrained(OUTPUT_DIR)
print("LoRA微调完成,模型已保存至:", OUTPUT_DIR)
(三)微调实战关键要点
- 数据质量:微调效果80%取决于数据质量,优先保证千级高质量标注数据,而非海量低质量数据。
- 轻量化优先:优先使用LoRA/QLoRA,避免全参数微调,大幅降低成本与时间。
- 超参数调优:LoRA-R设为8-32,学习率2e-4~5e-4,批次大小根据显存调整,避免过拟合。
- 模型融合:微调后可将LoRA权重与基础模型合并,生成独立模型,方便部署。
五、三层技术栈选型决策:先提示→再RAG→最后微调
2026年,LLM应用开发的黄金选型法则是:先试提示工程,搞不定上RAG,RAG还不够再加微调,三者经常组合使用。以下为具体决策流程与场景匹配:
(一)选型决策流程(五步判断法)
- 第一步:提示工程能否解决?→ 是:用提示工程(快速、低成本)。
- 第二步:是否需要外部/实时知识?→ 是:用RAG(解决知识截止与幻觉)。
- 第三步:是否需要固定风格/格式、批量处理?→ 是:用微调(提升一致性)。
- 第四步:是否需要边缘/离线部署?→ 是:用微调(本地推理,无网络依赖)。
- 第五步:复杂领域任务,提示+RAG效果不足?→ 是:用微调(深度优化)。
(二)场景化选型匹配表
| 场景类型 | 优先方案 | 组合方案 | 核心原因 |
|---|---|---|---|
| 内容创作、简单问答 | 提示工程 | - | 通用任务,无需额外知识,快速迭代 |
| 企业内部文档问答 | RAG | 提示工程+RAG | 知识专属、需实时更新、减少幻觉 |
| 法律/金融文书生成 | 微调 | RAG+微调 | 领域知识深、格式固定、精度要求高 |
| 边缘设备AI助手 | 微调 | - | 无网络、低算力、需本地快速推理 |
| 智能客服(多场景) | RAG | 提示工程+RAG+微调 | 知识动态更新+风格统一+精度提升 |
| 代码开发助手 | 提示工程 | 提示工程+RAG(代码库) | 通用代码能力+代码库知识检索 |
(三)常见误区与避坑指南
- 误区1:用提示工程解决所有问题→ 避坑:知识类任务优先RAG,复杂领域任务优先微调。
- 误区2:盲目微调,不做提示与RAG→ 避坑:微调是最后选项,先穷尽前两层能力。
- 误区3:RAG检索越多越好→ 避坑:Top-K设为3-5,避免上下文过长导致模型混乱。
- 误区4:微调数据越多越好→ 避坑:质量优先于数量,千级高质量数据优于百万级低质量数据。
六、总结:三层技术栈协同,构建高效LLM应用
提示工程、RAG、微调并非相互替代的技术,而是LLM应用开发的三层能力栈,从交互引导到知识增强再到能力重塑,形成完整的技术体系。提示工程是基础,实现零成本快速迭代;RAG是核心,解决知识与幻觉痛点;微调是进阶,实现深度定制与极致性能。
2026年,LLM应用开发的核心趋势是分层构建、组合协同:大多数场景下,“提示工程+RAG”即可满足需求,成本低、迭代快;仅在领域专属、高一致性、边缘部署等场景下,才需要引入微调。开发者需清晰认知三者的能力边界与适用场景,根据业务需求精准选型,避免技术滥用,实现LLM应用的高效落地与价值最大化。
未来,随着LLM技术的演进,三层技术栈将进一步融合,如“微调+RAG”的混合方案、自适应提示工程等,为LLM应用开发提供更灵活、更强大的能力支撑。但无论技术如何发展,“分层解决问题、组合优化效果”的核心逻辑,将始终是LLM应用开发的基石。