什么是渐进式披露
渐进式披露是高质量 Skill 中最基础也最重要的技巧之一。 用一句话表达就是:不要把所有的规则和知识都一股脑的写在提示词中交给大模型,而是只在必要的时候,加载对应的知识。
为什么需要渐进式披露
在大模型领域有一句话叫上下文腐坏,我通常喜欢叫它上下文污染,但意思都是一样的。当交给大模型的上下文过长的时候,这些内容就会让大模型产生误判,或者说让大模型的注意力转移,把真正重要的内容忽略掉(没办法,transform 模型本质上还是用注意力模式构建的)。 这一点在复杂任务下会尤其明显。
在我们的自动化测试工程中,通常都会由 AI 来完成代码生成的工作,但很多同学总会反馈 AI 生成的代码一次通过率很低,大模型总会在一些细枝末节的地方出纰漏,或者没有理解准确我的意思。 这很可能是长上下文带来的影响。
这其实很好理解,整个自动化测试的项目太大了, 我们历史上可能已经构建了数千条测试用例。这些测试用例之间可能由于场景特性,相近的功能,但用了略有差异的执行和验证方式。这些就会给大模型带来困扰。我们应该让大模型只去理解那些必要的知识,而非把所有东西一股脑扔给他。
要如何做到渐进式披露
概念好理解,但概念太虚了,我要怎么实操呢? 这里我们先给出一个例子。 在我的编写接口自动化测试的 SKILL.md 中, 最开头就有这样一段:
自动化测试用例编写 - 公共知识库
工作流(必须严格按顺序执行)
每次编写测试用例时,必须按以下工作流依次执行:
Step 1:阅读规则
- 阅读本文件,获取公共模块知识
- 根据用例所属功能域,读取
references/目录下对应的参考文件(见下方分层索引) - 读取用例目标目录下的
.rules文件,获取该目录的特定规则
Step 2:参考已有用例
- 在用例目标目录下,找到 1-2 个功能最相近的已有测试用例文件
- 阅读这些用例的完整代码,学习其基类、导入、写法、命名、步骤风格
- 新用例的风格必须与同目录已有用例保持一致
分层参考文件索引
根据要编写的用例所属功能域,必须读取对应的参考文件:
| 功能域 | 参考文件 | 对应用例路径 |
|---|---|---|
| 权限测试 | references/auth.md |
cases/platform_management/auth/ |
| 计费测试 | references/billing.md |
cases/platform_management/price/ |
| 提示词模板 | references/prompt-tpl.md |
cases/prompt_templates/ |
| 模型广场 | references/model-market.md |
cases/model_marketplace/ |
| 插件广场 | references/plugin-market.md |
cases/plugin_marketplace/ |
| 多Agent模型 | references/multi-agent.md |
cases/app_dev/multi_agent_model/ |
重要:编写特定领域用例时,必须先读取对应的
references/*.md文件,获取该领域的基类、Service、测试模式等专用知识。
在 references 目录下的文件:
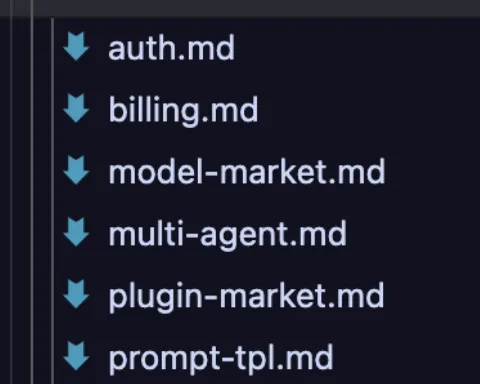
在这段 skill 的工作流中,首先说明需要大模型根据测试场景, 和测试存放的目录进行分层读取:
首先,如果是一个权限相关的测试用例。 大模型根据 skill 指引,读取 references 下的 auth.md 文件,这里面记录的是什么呢?我们可以看一下:
三、权限测试标准流程
3.1 创建工作空间并添加子账号
self.start_step("使用主账号创建工作空间")
self.create_workspace_with_sub_account("权限测试工作空间名称")
self.workspace_id 和 self.sub_uin 自动设置
3.2 三种授权方式
权限系统支持三种授权对象,使用不同的 API:
| 授权对象 | API 方法 | 说明 |
|---|---|---|
| 用户 | AuthAPI.SetUserResourcePermissions |
给用户直接赋予数据权限 |
| 组织 | AuthAPI.SetSubjectResourcePermissions |
给组织赋予数据权限,组织内成员继承 |
| 角色 | AuthAPI.SetRoleResourcePermissions |
给角色赋予数据权限,角色下用户继承 |
用户直接授权
from lib.lke_api.platform_management.auth.auth_api import AuthAPI
from cases.platform_management.auth.permissions import AppPermissions
res = AuthAPI.SetUserResourcePermissions(
SpaceId=self.workspace_id,
AccountUin=self.sub_uin,
Permissions=AppPermissions.adpAPP_no_permission, # 权限配置
account_name="Master_Default",
ResourceIds=[""], # "" 表示所有资源
ResourceType="app" # 资源类型
)
if"Error"in res["Response"]:
raise Exception(f"设置子账号权限失败. {res=}")
组织授权
SubjectType=1 表示组织
res = AuthAPI.SetSubjectResourcePermissions(
SpaceId=self.workspace_id,
SubjectId=self.dept_id, # 组织ID
SubjectType=1, # 1=组织
Permissions=AppPermissions.adpAPP_view,
ResourceIds=["*"],
ResourceType="app",
account_name="Master_Default"
)
if"Error"in res.get("Response", {}):
raise Exception(f"为组织设置权限失败. {res=}")
time.sleep(40) # 等待权限生效
角色授权
res = AuthAPI.SetRoleResourcePermissions(
SpaceId=self.workspace_id,
RoleId=self.role_id, # 角色ID
Permissions=AppPermissions.advance_custom_all,
ResourceIds=["*"],
ResourceType="app",
account_name="Master_Default"
)
if"Error"in res.get("Response", {}):
raise Exception(f"为角色设置权限失败. {res=}")
time.sleep(40) # 等待权限生效
上面那些是权限模块的公共方法, 但根据不同的场景, 它还有特定的知识, 比如根据角色设置权限的测试点和操作方法,与根据组织设置权限就会略有不同。所以 SKILL.md 中的工作流还会要求大模型去读取对应目录, 这些目录下的规则文件和相似的测试用例。 这些都是让大模型进行参考的重要知识。 所以在 SKILL.md 中才会在 step2 里规定:
Step 2:参考已有用例
- 在用例目标目录下,找到 1-2 个功能最相近的已有测试用例文件
- 阅读这些用例的完整代码,学习其基类、导入、写法、命名、步骤风格
- 新用例的风格必须与同目录已有用例保持一致
在整个知识体系中,我们其实是分了三层的:
第一层:SKILL.md 定义工作流和公共知识.
第二层:references:该目录存放了多个文件,记录着每个模块特有的代码知识。
第三层:特定场景测试 case 存放的目录:该目录下也有 rule 文件记录特定场景知识,也会让大模型读取这里的测试文件,进行一定的参考。
以上, 就是我在接口自动化测试项目中的一个实践。
进一步的扩展
事实上,在整个 Agent 和 SKILL 的优化实践中,让 Agent 只理解必要的知识,减少无关的内容,是贯穿了整个设计的原则。 渐进式纰漏只是其中的一种。 在后面要讲的多 Agent 隔离, 执行结果持久化 也是这种思想的体现。