目录
一、现象:背了三百道题的候选人,第一轮就被刷了
二、本质变化:面试官在筛选“做过事的人”,不是“读过书的人”
三、核心机制拆解:三个项目题到底在测什么
四、典型案例对比:两个候选人的回答实录
五、工程落地启示:没项目经验怎么办
六、最后一个问题
上个月公司校招,我坐在面试间里,对面是一个985硕士。简历漂亮:GPA前10%,两段大厂实习,技能栏写满了Spring Cloud、Kafka、Redis。
我问了第一个问题:“你简历上写做过秒杀系统,那我想知道,这个系统上线以后,你遇到过什么真实的问题?怎么解决的?”
他沉默了几秒,说:“呃,其实那个项目是跟网课做的,没有真的上线。”
我点点头,又问:“那你实习的时候,写过最复杂的一个功能是什么?代码还在你脑子里吗?”
他又沉默了。最后说了个“改了一个查询接口的SQL”。
面完出来,我跟HR说:“这个不行。他知道很多东西,但一样都没真的做过。”
这不是个例。今年我面了二十多个校招生,能让我觉得“这人是真干过活”的,不超过三个。
很多人还在靠背八股文准备面试,但面试官已经换了一套玩法。 我们现在不问HashMap的扩容机制,不问线程池的参数。不是因为这些不重要,是因为这些东西AI能答得比你好。我们只问三个真实项目题。
一、现象:背了三百道题的候选人,第一轮就被刷了
说几个今年的真实场景。
字节某组的一面,面试官直接说:“我们不问八股,你就挑一个你写得最爽的代码片段,给我讲讲你是怎么设计的。” 候选人懵了,因为他所有的代码都是跟着视频敲的,没有一个片段是他自己独立设计的。
阿里的二面,面试官扔了一个github地址:“这是我之前遇到的一个线上bug,代码在这里,给你十分钟,你说说问题出在哪。” 候选人连代码都没完全看懂。
美团的HR面之前加了一轮“项目深度面”,专门问:你这个项目上线了吗?多少用户?遇到最大的技术挑战是什么?如果让你重做,你会改哪里?
校招生的反馈也在印证这个变化。 牛客网上越来越多的人说:“面试官全程追着项目问,问得非常细,细到某个字段为什么用这个类型,某行日志怎么打的。”
而那些“背了三百道题,手撕了十道算法”的人,发现自己准备的东西,面试官一个都没问。
不是八股文完全没用了,是 它从“通过条件”变成了“不扣分条件”。你背得再好,也只能拿个基础分。真正决定你能不能进下一轮的,是那三个项目题。
二、本质变化:面试官在筛选“做过事的人”,不是“读过书的人”
为什么会有这个变化?
原因一:八股文的答案已经被AI平权了。
任何一个大模型,你问它“HashMap的put流程”,它能给你输出一份完美的答案,甚至比绝大多数候选人说得都好。面试官如果还问这种题,他无法区分谁是真的理解,谁是刚刚从GPT那儿背下来的。
原因二:大模型时代的业务复杂度,逼着面试官要找“能动手的人”。
现在的后端系统,动不动就要接大模型API,要做RAG,要处理不确定的输出。这些东西没有任何八股文可以背。你只有真正上手写过,才知道提示词模板怎么管理,才知道JSON解析失败怎么兜底,才知道成本怎么控制。
面试官的核心诉求变了:我不是要一个“知道很多”的人,我要一个“能带着我解决未知问题”的人。
而最能预测这种能力的,就是你过去有没有“完整地、独立地解决过一个真实问题”。三个项目题,就是在挖这个东西。
本质上,面试从“知识测试”变成了“行为面试”。 你过去的行为,是预测你未来行为的最佳指标。你做过项目,遇到过坑,解决过问题——这些经历形成的判断力,是AI给不了,也是八股文背不出来的。
三、核心机制拆解:三个项目题到底在测什么
我现在面试只问三个问题。不是固定的措辞,但内核不变。
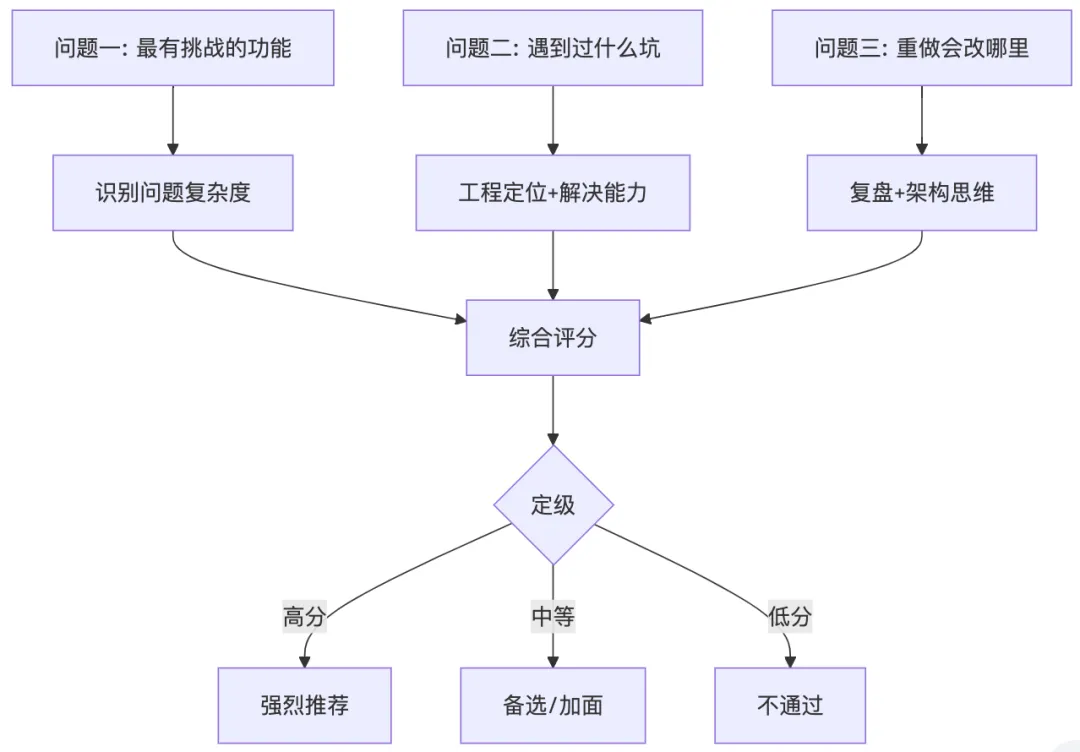
项目题一:“你做过的最有挑战的一个功能是什么?”
测什么:真实问题的复杂度感知能力。
高分回答会描述一个具体的场景(“用户反馈导出Excel超时”),而不是模糊地说“我做过一个微服务”
会解释为什么有挑战(“数据量从10万涨到500万,老方案OOM了”)
会说明自己的角色(“我一个人从定位到上线改了三天”)
低分回答:说“我做过登录功能”,或者“我用Redis做缓存”。没有过程,只有名词。
项目题二:“这个功能你遇到过什么坑?怎么解决的?”
测什么:工程现场的还原能力 + 问题定位的方法论。
高分回答会有清晰的时间线和动作序列(“我先看日志,发现full GC频繁,然后用jmap dump了堆,发现某个HashMap占了80%,再翻代码发现没设初始容量……”)
会讲出当时的权衡(“我本想用弱引用,但考虑到兼容性,最后选了定时清理”)
低分回答:“我查了一下,发现是bug,然后改好了。” 没有工具名,没有命令,没有数据。
项目题三:“如果让你重做,你会改哪里?为什么?”
测什么:复盘能力和技术品味。
高分回答会跳出具体实现,讲架构层面的改进(“我会把导出做成异步,用消息队列削峰,前端轮询下载”)
能说出改动带来的代价(“异步后用户不能实时拿到结果,需要加一个通知”)
低分回答:“我觉得当时的方案挺好的,没什么要改的。” 或者只改一些语法层面的东西。
这三个问题,如果候选人能答得扎实,我基本可以判断:这人入职后,三个月内能独立干活,半年后能带小任务。如果答得虚,哪怕简历上天,我也会打低分。
下面这张图是三个问题的考察链路:
四、典型案例对比:两个候选人的回答实录
我拿两个真实的面评(脱敏)来对比。
候选人X:985硕,简历漂亮,但项目全是课设
问:“你做过最有挑战的功能是什么?”
答:“我做过一个基于Spring Boot的博客系统。挑战是用户评论的嵌套展示,需要递归查询数据库,我用了MyBatis的嵌套查询解决了。”
追问:“遇到什么坑?”
答:“递归查询太深会慢,我就改成了只查两层。感觉还行。”
追问:“重做会改什么?”
答:“可能前端用Vue重构一下,界面好看点。”
我的面评:全程停留在“作业级别”。没有真实用户,没有性能压力,没有数据量。递归查询的深度和效率问题完全没有量化。不通过。
候选人Y:双非本科,一个实习项目+一个自己折腾的工具问:“你做过最有挑战的功能是什么?”
答:“我在实习的时候,有一个需求是把用户操作日志从MySQL迁移到ClickHouse,因为日志量从每天几十万涨到了千万级,MySQL的写入和查询都扛不住了。我负责写数据同步的Worker,保证不丢数据、不重复。”
追问:“遇到什么坑?”
答:“最大的坑是同步过程中MySQL主键和ClickHouse的排序键不一致,导致部分数据upsert的时候覆盖错了。我先用md5(主键)做去重,发现性能不行,后来改成用Flink的retract机制,先删后插。最终上线后延迟控制在5秒内。”
追问:“重做会改什么?”
答:“我不会再自己写Worker了。当时团队不知道有现成的CDC工具,现在看应该直接用Canal+消息队列,这样同步任务的稳定性更高,而且支持断点续传。代价是需要多维护一个Canal组件,但能省下我们团队三个人两周的自研时间。”
我的面评:三个问题的回答都有“真实感”——有数据、有工具名、有失败尝试、有对比选型。强烈推荐,直接发offer。
两个人的差距不在学历,不在智商。在于一个人真的在真实场景里解决过问题,另一个人只是在作业里“演示”过功能。
五、工程落地启示:没项目经验怎么办
很多在校生看到这里会慌:“我确实没有像样的项目经验,怎么办?”
三条路,都是我见过有人走通的。
第一条:把课设改造成“真项目”。
不要满足于老师给的需求文档。自己去加“真实世界的约束”:
原本单机跑的,改成支持100个并发用户(用JMeter压一下)
原本没登录的,加上JWT token和权限校验
原本数据放内存的,改成MySQL,然后观察慢查询,加索引
原本没有日志的,加上logback,然后模拟一个异常,去查日志定位
每加一个约束,你就会遇到一个真实的问题。把这些问题的解决过程记下来,面试的时候讲出来,效果不亚于公司实习。
第二条:去接真正的“脏活”。
找一个开源项目,去提issue。不需要是大项目。很多Python库、前端组件库的issue里,有“good first issue”标签。你去修一个bug,哪怕只是文档错误,你会经历完整的流程:看懂代码 → 定位问题 → 提PR → 被review → 修改 → 合并。
这个过程本身就是一个项目题的标准答案。面试官问你“最有挑战的事”,你直接说“我给xx开源项目修了一个bug,过程是这样的”。
第三条:自己做个工具,解决自己的痛点。
我见过最离谱也最有效的例子:一个同学嫌弃每次写周报要整理git log太麻烦,自己写了一个脚本,自动从commit message里提取本周工作,再调大模型润色成周报格式。他把这个脚本开源了,40多个star。 面试的时候直接演示,面试官当场说“这个好,能不能给我们团队也分享下”。
本质是一样的:做出一个“有真实输入、有明确输出、能解决实际问题”的东西。 哪怕代码只有200行,也比一个5000行的课设作业有说服力。
六、最后一个问题
回到开头那个985硕士。他的简历现在还在我的面试记录里,备注是“建议明年再投,先攒项目经验”。
我后来跟HR聊,她说最近收到的简历,越来越难筛选。因为大家简历上写的项目都一样:秒杀系统、RPC框架、在线聊天室。一看就是跟网课做的。
面试官想看到的东西其实很简单:一个你真正从头到尾负责过的、遇到过困难的、解决了的真实问题。
最后一个问题留给你,也是我每次面完都会在心里问自己的:
如果让你现在放下手机,拿一张白纸,把你做过最“真”的那个项目按“背景、动作、结果、复盘”写出来,你能写得比这篇文章里的候选人Y更具体吗?
(评论区可以写一句话描述你的项目中最亮眼的那个功能。我随机挑几个回复,给出面试官视角的反馈。)