敏感内容识别技术解析:防泄密系统如何判断一份文件是否值得重点保护

简介: 防泄密系统能不能真正工作,第一步不是拦截,而是识别。系统如果不知道哪些文件里包含客户信息、财务数据、投标底稿、研发资料或者源代码,那么后续所有拦截动作都只能是盲控。`Ping64` 这类产品真正要解决的,不是单纯看到一个上传动作,而是先判断上传的到底是不是敏感内容。

敏感内容识别技术解析:防泄密系统如何判断一份文件是否值得重点保护

防泄密系统能不能真正工作,第一步不是拦截,而是识别。系统如果不知道哪些文件里包含客户信息、财务数据、投标底稿、研发资料或者源代码,那么后续所有拦截动作都只能是盲控。Ping64 这类产品真正要解决的,不是单纯看到一个上传动作,而是先判断上传的到底是不是敏感内容。

敏感内容识别之所以难,是因为真实文件并不会统一写着“机密”两个字。很多重要数据可能藏在表格字段里,可能嵌在 PDF 页面里,也可能分散在目录结构、模板格式和业务上下文里。系统如果只看文件名,基本没有实际意义;只看少数关键词,也很难覆盖复杂场景。

常见的敏感内容识别方式

成熟系统通常不会依赖单一检测手段,而是多种方法叠加。

  • 关键字识别:适合项目代号、敏感标识、内部术语
  • 正则识别:适合身份证号、银行卡号、手机号、合同编号
  • 模板匹配:适合报表、合同、导出清单、标准化文档
  • 文档指纹:适合历史样本相似度识别
  • 上下文标签:适合研发目录、财务目录、审批流来源
def classify_file(file):
    score = 0
    score += keyword_score(file.text, {
   "内部机密", "客户名单", "投标报价"})
    score += regex_score(file.text, [ID_CARD, BANK_CARD, PHONE])
    score += template_score(file, ["finance-report", "crm-export", "bid-doc"])
    score += path_score(file.path, ["/finance/", "/legal/", "/rd/"])
    return "confidential" if score >= 70 else "restricted" if score >= 40 else "normal"

从这个逻辑就能看出来,稳定识别依赖的是“证据累加”,而不是单个命中项。

为什么只靠敏感词识别效果很差

很多企业初期都会先建一个敏感词库,看起来成本低、上线快,但很快会碰到两个问题。

  • 误报高:普通会议纪要里只要提到“客户”或“合同”,就可能被误判
  • 漏报高:真正关键的清单、图纸、报表,未必包含显眼关键词

这也是为什么敏感内容识别必须引入结构化和上下文化能力。Ping64 这类产品真正的难点,不在于搜到几个词,而在于理解数据在企业语境中的敏感性。

敏感内容识别为什么要和业务标签结合

并不是所有敏感性都来自文档文本本身。很多时候,一份文件之所以重要,是因为它来自特定系统、特定目录或特定流程。例如 CRM 导出的客户清单、财务系统生成的付款报表、研发项目目录下的设计资料,即使文件里没有明确“机密”字样,也应被视为高风险对象。

因此,真正可用的识别体系往往会把内容特征和业务上下文结合起来。Ping64 在这类场景中的价值,不应只被理解为“扫描文件内容”,而应理解为“理解文件的业务来源和流转场景”。
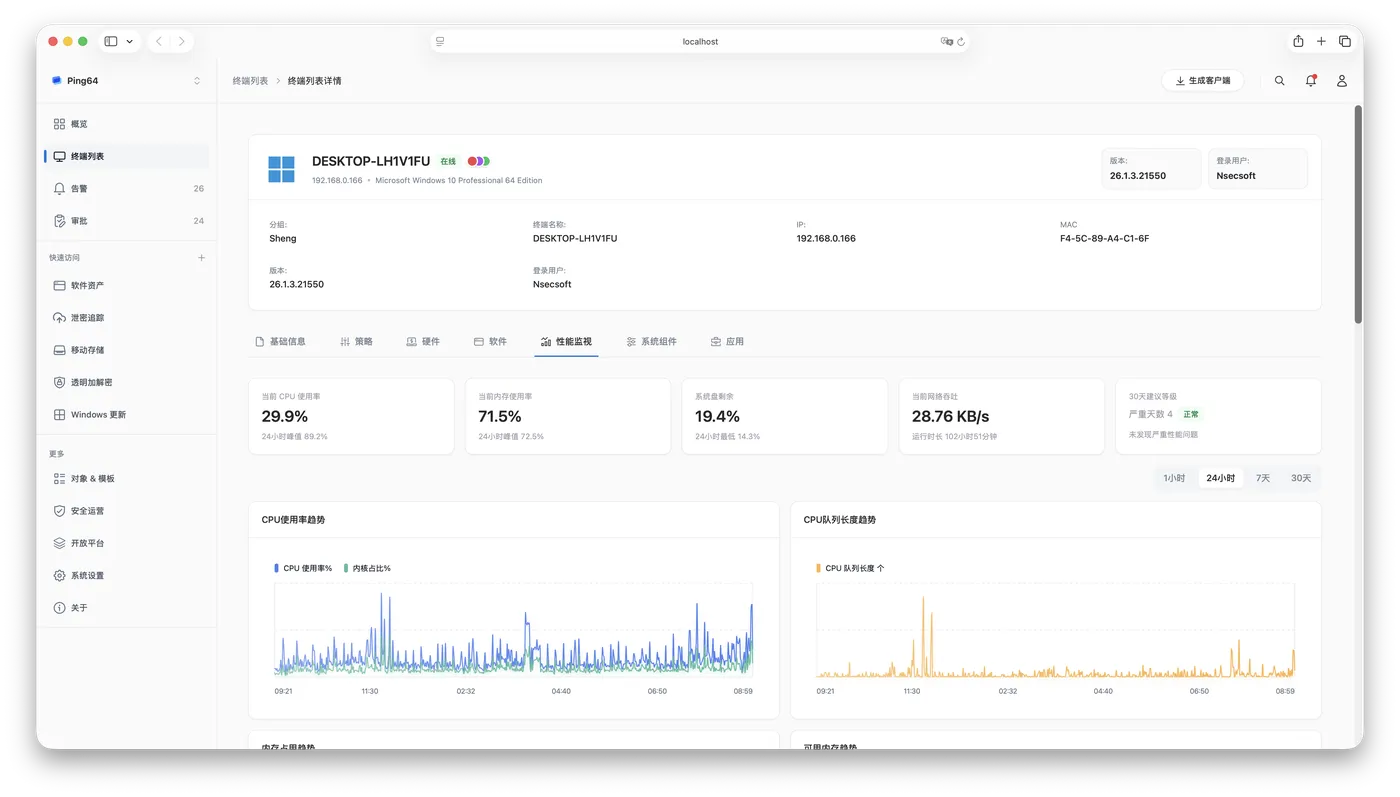
Ping64-dashboard-简体中文图.png

结语

敏感内容识别是防泄密系统的起点。没有这一层,外发控制、审批策略和审计留痕都会失去精度。评价一套方案是否成熟,不能只看它识别了多少敏感词,而要看它能否把内容特征、模板结构和业务语境统一成稳定的分类结果。Ping64 在这个问题上的工程意义,恰恰在于把“看见文件”推进为“理解文件的真实风险等级”。

相关文章
|
5月前
|
SQL 数据挖掘 API
信贷审核中如何验证用户地址与IP属地一致性?IP查询工具实现快速核验
本文详解信贷反欺诈中“IP属地与填报地址一致性核验”这一低成本、高时效的基础风控手段。结合真实团伙骗贷案例,拆解城市/省级比对、网络类型识别(如数据中心IP)、风险评分等核心规则,并提供基于IP数据云离线库/在线API的可落地技术方案与代码示例,助力提升欺诈识别率26%以上。(239字)
249 2
|
存储 网络协议 文件存储
手把手教你搭建Serv-U FTP服务器共享文件并实现外网远程访问「无公网IP」
|
5月前
|
Shell API 开发工具
Claude Code 快速上手指南(新手友好版)
AI编程工具卷疯啦!Claude Code凭借任务驱动+终端原生的特性,成了开发者的效率搭子。本文从安装、登录、切换国产模型到常用命令,手把手带新手快速上手,全程避坑,30分钟独立用起来。
5486 26
|
Windows
已解决Win11报错 OSError: [WinError 1455] 页面文件太小,无法完成操作。
Win11报错 OSError: [WinError 1455] 页面文件太小,无法完成操作。 Error loading "D:\aaaa\envs\gs\lib\site-packages\torch\lib\caffe2_detectron_ops_gpu.dll" or one of its dependencies.
14582 0
已解决Win11报错 OSError: [WinError 1455] 页面文件太小,无法完成操作。
|
6月前
|
人工智能 安全 API
阿里云轻量服务器部署OpenClaw全攻略:企业微信集成+千问Qwen3.6-Plus配置保姆级教程
OpenClaw(又称Clawdbot)是一款开源的AI智能体平台,能将各类大模型与即时通讯工具无缝集成,实现AI自动化对话、任务处理、信息查询等功能。对于个人与企业用户而言,在阿里云轻量服务器部署OpenClaw,可获得7×24小时稳定在线、公网可访问、团队共享使用的AI助手服务,搭配阿里云千问Qwen3.6-Plus大模型的强大能力,再接入企业微信,能完美满足办公协作、智能客服、自动化办公等场景需求。
1000 0
|
2月前
|
Java Linux Docker
【2026最新】Neo4j 下载安装教程(Windows/Linux/Docker 三平台安装,零基础友好)
本文是Java开发者学习Neo4j的实战笔记,涵盖Neo4j核心概念(节点、关系、属性、路径)、Windows手动安装踩坑指南(含第三方下载验证)、Docker快速部署方案,以及SpringBoot集成要点,助力快速入门图数据库。
【2026最新】Neo4j 下载安装教程(Windows/Linux/Docker 三平台安装,零基础友好)
|
3月前
|
人工智能 运维 NoSQL
OpenSpec 三阶段工作流实操:从 Propose 到 Archive让代码返工率降到三分之一以下
OpenSpec是AI原生规范驱动开发(SDD)框架,以Propose→Apply→Archive三阶段强制工作流,将需求精准转为AI可读、可验、可追溯的结构化规范,实测降低代码返工率超2/3。
505 0
|
9月前
|
Windows
typora-setup-x64编辑器安装步骤详解(附Markdown编辑入门)
`typora-setup-x64`是Typora官方64位Windows安装包。Typora是一款所见即所得的Markdown编辑器,支持实时预览、快捷排版、图片拖入、多格式导出等功能,适合写笔记、博客与技术文档,操作简洁高效。(239字)
|
人工智能 Java 开发者
阿里出手!Java 开发者狂喜!开源 AI Agent 框架 JManus 来了,初次见面就心动~
JManus是阿里开源的Java版OpenManus,基于Spring AI Alibaba框架,助力Java开发者便捷应用AI技术。支持多Agent框架、网页配置、MCP协议及PLAN-ACT模式,可集成多模型,适配阿里云百炼平台与本地ollama。提供Docker与源码部署方式,具备无限上下文处理能力,适用于复杂AI场景。当前仍在完善模型配置等功能,欢迎参与开源共建。
3773 58
阿里出手!Java 开发者狂喜!开源 AI Agent 框架 JManus 来了,初次见面就心动~
|
9月前
|
Ubuntu Linux 开发者
Ubuntu 24.04 安装 Docker 与 Compose:完整稳定版教程(小白必看)
本教程详细介绍在Ubuntu 24.04上安装Docker与Docker Compose的完整步骤,适合新手操作。涵盖环境准备、软件安装、验证及常见问题解决,助你快速掌握容器化部署技能,提升开发效率。

热门文章

最新文章