Hermes Agent、聊天机器人和 Copilot 的区别,应该先看工作流

简介: 围绕 AI Hermes Agent FAQ 页,拆解为什么比较 chatbot、coding copilot 和 long-running agent 时,应该先看工作形态和部署边界,而不是直接做优劣判断。

讨论 AI agent 时,我现在更倾向先问一个很朴素的问题:这件工作到底需要哪一种交互形态,而不是先比较哪个工具听起来更强。

聊天机器人、coding copilot 和 long-running agent 经常被放在一起讨论。它们都可以使用大模型,但用户真正要完成的工作并不一样。如果这个边界没有先讲清楚,后面的能力介绍很容易变成泛泛的“什么都能做”。

我在整理 AI Hermes Agent 的 FAQ 页面时,也把这个问题单独拆了出来:Hermes Agent 和 chatbot、coding copilot 的区别,不应该只看模型能力,而应该先看任务是否需要持续状态、工具调用、运行环境和自托管边界。

先把三类工具拆开

第一类是 chatbot。它更适合一次性问题、短上下文解释、临时整理和轻量决策。用户打开一个对话框,把问题说清楚,模型给出答案,任务通常就结束了。

第二类是 coding copilot。它更靠近编辑器和代码上下文,适合补全、解释局部代码、生成测试片段、修复小范围错误,或者帮助开发者在当前项目里更快推进一段具体实现。

第三类才是 long-running agent。它关心的不只是一次回答,而是能不能在一个更长的工作过程中保留上下文、调用工具、跨入口处理任务,并在需要时运行在开发者自己控制的环境里。

这三类工具不是简单的上下级关系。很多任务用 chatbot 已经足够,很多代码任务用 copilot 更直接。只有当任务确实需要持续性、工具连接和执行环境时,agent 才更值得认真考虑。

我会按这个顺序判断

如果要判断一件事是否适合 Hermes Agent 这类工具,我会先走一遍下面的路径:

  1. 这是不是一次性问答?如果是,chatbot 通常更轻。
  2. 主要工作是不是发生在编辑器里?如果是,coding copilot 往往更近。
  3. 任务是否需要跨工具、跨消息入口或跨上下文继续执行?
  4. 是否真的需要记忆、状态保留、计划任务或工具调用?
  5. 是否有 self-hosted 的安全、控制、集成或运行环境需求?
  6. 最后再回到官方文档和 GitHub 核对真实能力、安装方式和限制。

这个顺序的好处是,它不会一开始就把所有问题推向 agent。先排除轻量路径,反而能更清楚地看到 agent 应该接住哪一类工作。

自托管不是装饰,而是另一个判断维度

很多人讨论 agent 时,会把“更强的自动化”和“self-hosted”混在一起。但这两件事其实应该分开判断。

一件工作可能适合 agent,但不一定需要自托管;也可能因为数据、网络、集成、审计或运行环境要求,确实需要放在自己控制的机器上跑。后者会带来额外成本:部署、更新、权限管理、日志、失败恢复和安全边界都要有人负责。

所以我不太赞成把 self-hosted 写成单纯的卖点。更合理的写法是把它当成一个工程约束:当你需要控制运行位置、工具权限和长期状态时,它才有意义。

独立 FAQ 页应该把边界写清楚

这也是我把 FAQ 做成独立页面的原因。它不应该只告诉读者“这个工具能做什么”,还应该帮助读者判断“什么时候不该用它”。

AI Hermes Agent 是独立资源页,不是官方 Hermes Agent 网站,不由 Nous Research 拥有、运营或背书,也不提供 Hermes Agent 的托管运行、在线聊天、账号系统、订阅、积分、API 访问或托管 runtime;涉及真实部署的细节仍应回官方文档和 GitHub 核对。

这种边界说明看起来不够营销化,但对开发者内容更重要。因为读者真正需要的不是一句很大的能力承诺,而是知道什么时候该用 chatbot,什么时候该用 copilot,什么时候才值得继续看 Hermes Agent。

一个小结

我更愿意把 Hermes Agent 放回具体工作流里理解:如果任务只是一次对话,不要把它做重;如果任务主要在编辑器里,先看 copilot;如果任务需要持续上下文、工具调用、消息入口和自托管边界,再认真评估 agent。

这篇 FAQ 的目标也是这个:先给出判断框架,再把读者带到可以继续核对的资料。

完整页面在这里:

AI Hermes Agent FAQ

相关文章
|
6月前
|
人工智能 监控
HappyHorse 1.0 系列模型使用指南
HappyHorse 1.0 是一款基于原生多模态架构的新一代 AI 视频生成模型,支持音视频协同生成;产品深度适配广告营销、电商展示、短剧制作与社交媒体创意等内容生产场景。
|
10月前
|
机器学习/深度学习 人工智能 算法
构建AI智能体:六十八、集成学习:从三个臭皮匠到AI集体智慧的深度解析
集成学习不是简单的"模型堆砌",而是有深刻理论支撑的系统性方法。理解其核心思想:集体智慧,多个不完美的个体可以组成一个强大的集体,误差分解,通过降低方差或偏差来提升性能,多样性驱动,模型间的差异是集成效果的关键,分层学习,从数据学习到学习如何学习。集成学习代表了机器学习中的一个重要哲学:通过协作和组合,我们可以创造出超越任何单个组件能力的系统。这正是"三个臭皮匠,顶个诸葛亮"在人工智能时代的具体实践。
688 108
|
6月前
|
人工智能 自然语言处理 安全
Claude Code 全攻略:命令大全 + 实战工作流(建议收藏)
本文介绍了Claude Code终端AI助手的使用指南,主要内容包括:1)常用命令如版本查看、项目启动和更新;2)三种工作模式切换及界面说明;3)核心功能指令速查表,包含初始化、压缩对话、清除历史等操作;4)详细解析了/init、/help、/clear、/compact、/memory等关键命令的使用场景和语法。文章通过丰富的界面截图和场景示例,帮助开发者快速掌握如何通过命令行和交互界面高效使用Claude Code进行项目开发,特别强调了CLAUDE.md文件作为项目知识库的核心作用。
51348 73
Claude Code 全攻略:命令大全 + 实战工作流(建议收藏)
|
2月前
|
人工智能 测试技术 Shell
Opencode最被低估的6个测试指令:每天帮你省下3小时重复劳动
本文详解Opencode六大自定义指令(如/test、/coverage),助测试工程师30分钟配置、每日省3小时,告别重复Prompt输入,实现测试流程自动化提效。
|
6月前
|
人工智能 自然语言处理 测试技术
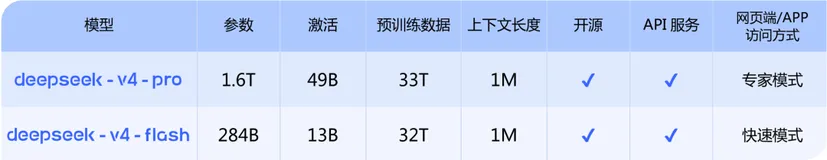
DeepSeek V4:百万上下文,万亿参数,以及重新泛起涟漪的开源池塘
DeepSeek V4发布Pro(1.6T参数/49B激活)与Flash(284B/13B)双模型,均支持1M上下文、thinking模式及Agent能力。全栈开源(权重+技术报告+API+定价),采用混合注意力架构显著降本,中文长文本与推理能力突出,是当前少有的万亿级开源系统级发布
3372 4
DeepSeek V4:百万上下文,万亿参数,以及重新泛起涟漪的开源池塘
|
5月前
|
人工智能 弹性计算 API
阿里云轻量应用服务器低成本部署OpenClaw方案:2核2G38元,2核4G199元,全球多地域可选
2026年阿里云轻量应用服务器低成本部署OpenClaw AI助理的方案:用户可通过每天10:00和15:00的限量抢购活动,以38元/年(2核2G/40G云盘)或9.9元/月、199元/年(2核4G/50G云盘)的价格入手服务器,预装OpenClaw镜像实现分钟级一键部署,免代码上手。部署后可通过Web UI或飞书、钉钉、QQ、企业微信等IM工具与AI智能体交互,并支持扩展Skill和自定义RPA流程。方案覆盖个人博客、AI应用开发等场景,大幅降低了AI Agent的技术与资金门槛,是低成本拥抱AI智能体的实用路径。
|
6月前
|
存储 缓存 自然语言处理
从零搭建企业私有知识库:RAG + 大模型实战(附完整代码)
本文详解如何用RAG技术构建企业私有知识库:支持PDF/TXT/DOCX等文档上传、向量化存储与智能问答,让大模型精准理解业务数据,兼顾数据隐私、领域专业性与实时性,附完整代码与部署方案。
10801 1
|
6月前
|
人工智能 弹性计算 小程序
阿里云轻量应用服务器2核4G抢购:200M峰值带宽,9.9元1月、199元1年,支持快速部署OpenClaw
阿里云推出轻量应用服务器抢购活动,2026年新增2核4G配置,月付9.9元、年付199元,默认200M带宽、50GB ESSD云盘,适合搭建AI助理等复杂应用。活动每天10点和15点限量抢购,用户需满足新用户条件。若未能抢购成功,新用户仍可以68元/年的优惠价购买2核2G配置。此外,还有云服务器ECS特惠等备选方案。

热门文章

最新文章