MoE技术分享

简介: MoE(Mixture of Experts,混合专家模型)的概念最早可以追溯到 1991 年的相关论文。这一开创性工作为后续 MoE 模型的发展奠定了理论基础,其核心思想是采用“分而治之”的方式,将复杂任务拆解为多个子问题,并分别交由不同的“专家”模型处理,从而提升模型的表达能力和处理效率。

《MoE技术分享》link

MoE(Mixture of Experts,混合专家模型)的概念最早可以追溯到 1991 年的相关论文。这一开创性工作为后续 MoE 模型的发展奠定了理论基础,其核心思想是采用“分而治之”的方式,将复杂任务拆解为多个子问题,并分别交由不同的“专家”模型处理,从而提升模型的表达能力和处理效率。

一、为什么需要MoE
随着大模型的持续发展,业界希望进一步提升模型能力和参数规模,但同时又不希望推理成本、显存占用和时延随着参数规模线性增长。MoE 提供了一种有效思路:虽然整体参数规模可以做得很大,但在实际推理时,每个 token 只会激活其中一小部分专家参数,因此模型可以在显著扩展参数量的同时,将单次计算量控制在相对稳定的水平。

2020 年,谷歌在 GShard 项目中首次将 MoE 技术引入 Transformer 架构,并提出了高效的分布式并行计算框架,使 MoE 模型能够在分布式环境下实现大规模训练与推理。此后,2021 年谷歌进一步推出了 Switch Transformer 和 GLaM 等模型,通过对门控机制和专家设计进行优化,进一步提升了 MoE 模型的性能和效率,也推动了该技术在大模型领域的快速发展。

近年来,MoE 模型的应用范围不断扩大。除了在自然语言处理领域持续取得突破外,它也逐步拓展到计算机视觉、多模态学习等方向,成为大规模模型架构演进中的重要技术路线之一。

二、 什么是MoE?
在理解 MoE 之前,首先需要区分稠密模型(Dense)和稀疏模型(Sparse)。两者最核心的区别在于:一次前向传播时,是否所有参数都会参与计算:
稠密模型中:所有参数都会被激活;
稀疏模型中:通常只有部分参数会被激活。

总体来看,Dense 模型的特点是结构简单、所有参数都参与计算,但随着模型规模增大,计算量和内存消耗也会持续上升。Sparse 模型则通过“按需激活”的方式降低单次计算成本,在扩大模型容量的同时保持较高效率。MoE 正是建立在这种稀疏计算思想之上的一种典型架构。

……

点击标题可阅读全文。

相关文章
|
11月前
|
机器学习/深度学习 人工智能 自然语言处理
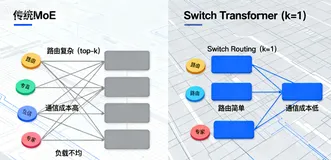
AI 十大论文精讲(七):Switch Routing 如何破解 MoE 的路由、通信与稳定性三大痛点
Switch Transformers通过简化MoE路由机制,实现万亿参数模型的高效训练。其核心创新在于Switch Routing(单专家激活)、选择性精度与三重并行架构,在降低计算成本的同时提升模型规模与稳定性,为大模型稀疏化发展奠定基础。
947 132
AI 十大论文精讲(七):Switch Routing 如何破解 MoE 的路由、通信与稳定性三大痛点
|
6月前
|
机器学习/深度学习 算法
Agentic RL 技术案例分享
大模型时代,强化学习正从“锦上添花”变成“不可或缺”。在千亿参数成为标配的当下,单纯依赖 Next-Token Prediction 的预训练范式已经触及了能力天花板。现在的核心工程难题,不再是如何让模型吐出流畅的文本,而是如何将其内部错综复杂的表征空间,收敛到符合人类逻辑与偏好的狭窄子集中。强化学习(RL)由此成为了跨越这道鸿沟的核心组件,它不仅在做对齐,更是在尝试将单步的概率预测,升维成一种具备多步规划属性的系统决策。
|
6月前
|
存储 运维 监控
互成软件终端智能告警体系(SIEM)设计与实施:从多源采集到多渠道通知的闭环方案
互成软件终端智能告警体系,覆盖违规外联、设备使用、安全风险、硬件/软件/配置/磁盘/性能等八大风险维度;支持动态模板通知、邮件短信双通道触达、多级关联聚合与降噪,并兼顾合规隐私。实现从事件检测到闭环处置的全链路安全运营。(239字)
|
20天前
|
人工智能 监控 API
千问大模型零成本上手教程:网页端与API免费额度完整实操指南
千问大模型的免费体验分为网页端和API新人额度两条路径。普通用户通过网页端零配置即可完成文档解析、问答创作;开发者领取API免费Token,通过curl、Python脚本实现模型调用,完成原型开发。使用过程中,开启额度用尽自动停止是重中之重,可以规避意外扣费风险。整套方案可以帮助零基础用户低成本熟悉大模型能力,完成学习、创意创作、AI原型验证等各类需求。
663 1
|
6月前
|
机器学习/深度学习 自然语言处理 供应链
大模型应用:销量预测升级:Qwen大模型让时序分析从算数值到给建议.82
本文提出“会说话的时序分析系统”,融合ARIMA、Prophet等专业预测算法与大模型,实现从冰冷数值到自然语言洞察的跃迁:算法精准算未来,大模型解读原因、生成可落地建议,让时序数据真正成为懂业务、会决策的智能助手。
773 3
|
5月前
|
人工智能 弹性计算 安全
Hermes Agent 极速部署指南+免费Token领取教程
Hermes Agent是全球增长最快(GitHub星标超14万)的开源自进化智能体框架,具备持久记忆、自主学习与技能优化能力。阿里云提供一键部署方案,2步即可完成配置,轻松启用越用越聪明的AI助手。
1002 1
|
1月前
|
人工智能 API 语音技术
技术实践|端云协同的百炼语音AI软件开发套件
Qwen-Audio-3.0移动端SDK是覆盖Android、iOS、HarmonyOS的语音AI套件,以C++为核心,提供可自由组合的原子能力(KWS、AEC、VAD、TTS等),通过统一API连接百炼云端ASR/TTS/Realtime等大模型,支持实时识别、合成、对话、翻译等场景。
482 4
|
6月前
|
人工智能 自然语言处理 安全
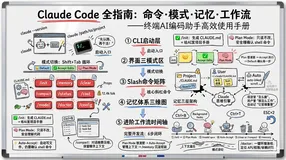
Claude Code 全攻略:命令大全 + 实战工作流(建议收藏)
本文介绍了Claude Code终端AI助手的使用指南,主要内容包括:1)常用命令如版本查看、项目启动和更新;2)三种工作模式切换及界面说明;3)核心功能指令速查表,包含初始化、压缩对话、清除历史等操作;4)详细解析了/init、/help、/clear、/compact、/memory等关键命令的使用场景和语法。文章通过丰富的界面截图和场景示例,帮助开发者快速掌握如何通过命令行和交互界面高效使用Claude Code进行项目开发,特别强调了CLAUDE.md文件作为项目知识库的核心作用。
51576 73
Claude Code 全攻略:命令大全 + 实战工作流(建议收藏)