作者信息
腾讯机器人X实验室、腾讯混元视觉团队
研究背景
- 智能体已成为问题求解与工作流自动化的核心范式,大语言模型的发展推动智能体向物理环境延伸成为前沿方向。
- 视觉语言模型(VLM)虽取得显著进展,但在面向物理世界的具身智能场景中存在明显短板:一是细粒度视觉感知能力不足,无法捕捉物理交互所需的细节信息;二是针对具身环境的预测、交互与规划能力薄弱,主流模型基于静态网页数据训练,难以适配动态物理场景。
- 现有具身视觉语言模型在架构设计、数据构建与训练策略上,未充分针对空间时序视觉感知与具身推理做专项优化,无法满足现实世界机器人等具身智能体的部署需求。
研究目的
- 弥合通用视觉语言模型与现实世界具身智能体需求之间的鸿沟,专项提升空间时序视觉感知、具身预测、交互与规划核心能力。
- 打造适配不同部署场景的具身基础模型家族,兼顾边缘端部署的高效性与复杂推理任务的高性能。
- 构建系统化的模型架构、数据与训练方案,将数字智能转化为物理世界的实际执行能力,并在真实机器人控制任务中验证有效性。
本文核心贡献
- 提出MoT混合Transformer架构:通过模态自适应计算分离视觉与文本参数,搭配视觉隐令牌,在提升细粒度视觉感知的同时,避免语言能力退化,且推理几乎无额外开销。
- 构建超亿级具身专项数据集:整合视觉感知、空间认知、具身交互三大类数据,覆盖2D/3D检测、深度估计、分割、轨迹预测、任务规划等全维度任务,为模型提供高质量训练支撑。
- 设计迭代自进化后训练范式:结合监督微调、强化学习与拒绝采样微调,交替优化模型推理与行为能力,同时通过大到小的在线策略蒸馏,将大模型能力迁移至小模型。
- 实现双版本模型的行业领先性能:2B激活参数版本适配边缘部署,32B激活参数版本对标前沿模型,在22项基准测试中表现优异,并成功落地真实机器人控制任务。
研究方法
1. 模型架构设计
- HY-ViT 2.0视觉编码器:400M参数轻量化设计,支持任意分辨率输入,通过大模型蒸馏实现高效精准视觉表征。
- MoT模态自适应架构:复制语言模型的FFN与QKV参数,视觉令牌使用独立参数,视觉分支采用双向注意力,新增视觉下一个编码预测任务强化视觉建模。
- 视觉隐令牌:在视觉序列末端添加可学习隐令牌,通过大模型全局特征监督,衔接视觉与语言模态。
2. 训练数据构建
- 视觉感知数据:包含62M全量检测数据、36M深度估计数据、5M分割数据、11M指向与计数数据,覆盖2D/3D感知、深度、分割等基础能力。
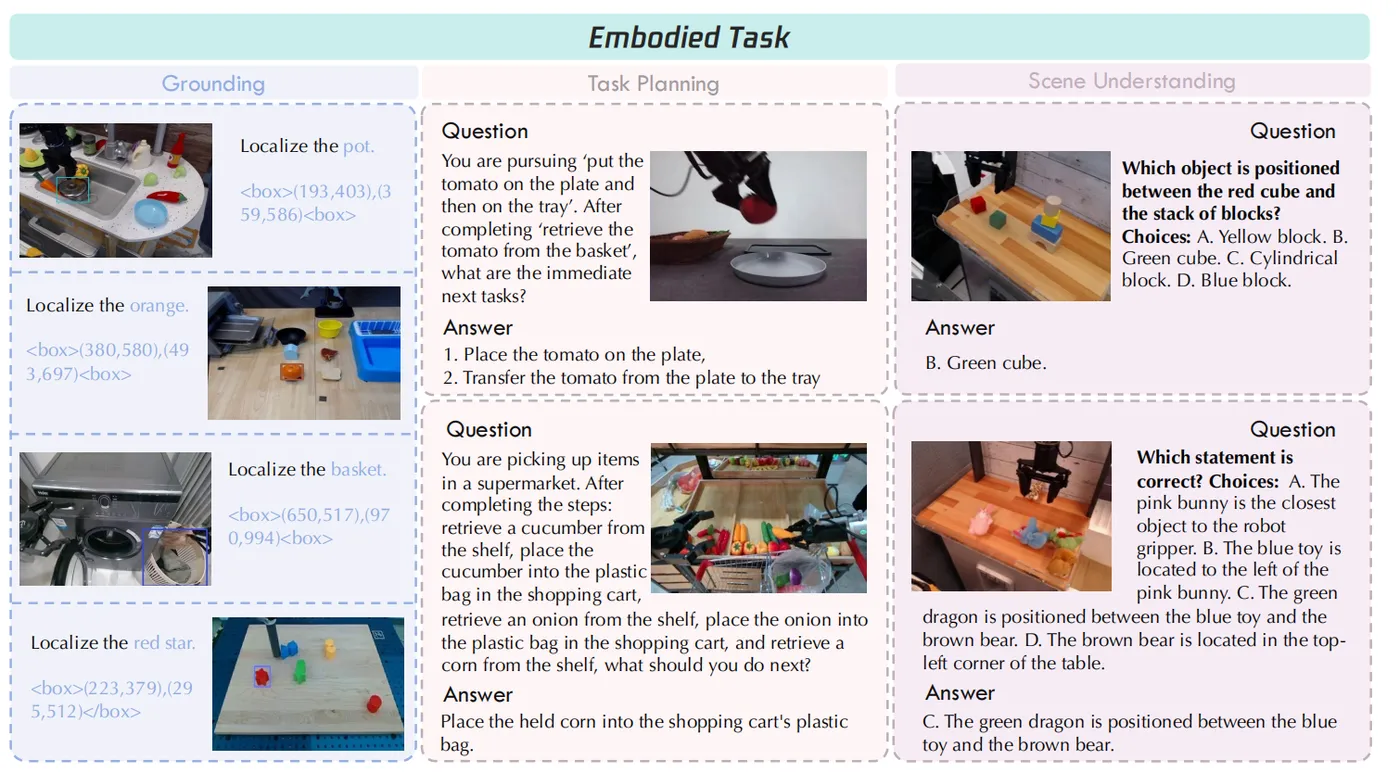
- 具身中心数据:涵盖视觉定位、可及性预测、轨迹预测、场景理解、任务规划、复杂推理,融合开源数据与真实机器人操作序列。
- 空间中心数据:分为对应关系、几何结构、空间配置、度量测量、动态变化五类,基于ScanNet等3D数据集构建,强化空间推理能力。
- 通用理解数据:覆盖通用语义、STEM、文档解析、复杂问题求解等,保障模型通用能力不退化。
3. 训练流程
- 预训练:超600B令牌多模态数据训练,融合视觉、具身、空间与通用数据,优化视觉、全局、语言三大损失函数。
- 中期训练:3000万高质量具身与空间数据,按比例混合通用数据,冻结ViT仅更新模型主体。
- 后训练:
- 监督微调:构建10万冷启动思维链数据,强化长链推理。
- 强化学习:采用GRPO目标,设计定位、回归、轨迹、文本四类任务感知奖励函数。
- 迭代自进化:交替强化学习与拒绝采样微调,固化高质量推理模式。
- 在线策略蒸馏:将32B大模型能力迁移至2B小模型,最小化令牌分布KL散度。
4. 实验评估
- 在22项公开基准测试中评估视觉感知、空间推理、具身理解能力,对比Qwen3-VL、RoboBrain 2.5、Gemini 3.0 Pro等模型。
- 基于MoT-2B构建视觉-语言-动作(VLA)模型,在真实机器人精密装箱、餐具堆叠、杯子悬挂任务中验证实际控制效果。
研究结果
- MoT-2B版本性能:在22项基准中16项取得最优,平均得分58.0%,超越Qwen3-VL 4B(+10.2%)、RoboBrain 2.5 4B(+8.6%),通用视觉任务能力与同规模通用VLM持平。
- MoE-A32B版本性能:22项基准平均得分67.0%,超越Gemini 3.0 Pro(63.6%)、Seed 2.0(66.2%)、Qwen 3.5 A17B(66.1%)、Kimi K2.5(61.1%),达到前沿模型水平。
- 真实机器人控制效果:VLA模型在精密装箱任务成功率85%、餐具堆叠80%、杯子悬挂75%,显著优于π0与π0.5基线模型,尤其在高难度悬挂任务提升明显。
- 架构效率验证:MoT架构训练收敛更快、最终损失更低,推理速度与标准Transformer接近,无明显额外开销。
总结与展望
本文提出的HY-Embodied-0.5模型家族,通过创新的MoT架构、亿级具身专项数据、迭代自进化训练与在线策略蒸馏方案,有效解决了通用VLM在具身智能场景的感知与推理短板,实现了边缘高效版与大型高性能版的协同设计,在多项基准测试与真实机器人任务中验证了技术有效性,为现实世界具身智能体提供了强大的基础模型支撑。
未来将进一步探索语言模型与动作模型的衔接,训练更适配复杂现实场景的具身智能“大脑”,持续优化模型在多机器人平台、长时序任务、未知环境中的泛化与执行能力。