企业做智能问数,最常见的比较题是:预制指标、宽表、人工 SQL、本体ABC,到底哪条路线维护成本更低?如果只给一个笼统答案,往往容易失真。因为真正决定长期成本的,不是“今天开发快不快”,也不是“第一次上线难不难”,而是当业务发生一次变更时,这个变更会波及多少层、多少人、多少历史资产。换句话说,长期成本的核心,不在静态开发量,而在变更传播半径。
这个视角比泛泛谈维护成本更有解释力。很多方案在 PoC 阶段看起来都不贵,甚至非常快;但一旦组织进入持续变化状态,成本就不再表现为一次开发工时,而表现为每次变更引发的连锁修补。谁的传播半径大,谁的长期成本就更容易失控。
一、先把问题问对:维护成本到底在维护什么
企业并不是在维护一堆 SQL、几个报表或者一层字段映射,真正维护的是业务定义本身。一个指标名不只是一个公式,它背后往往连着对象范围、统计口径、状态定义、时间窗口、组织边界、例外规则和解释责任。业务一变,受影响的也不只是结果值,而是整条语义链。
因此,比较几种路线时,最应该问的是:当“客户定义变了”“活跃设备口径变了”“双肩挑教师的判定标准变了”“某类收入要改成按责任部门归属”时,系统会在哪里被改动,修改之后会不会牵连大量历史查询、报表和问答逻辑。这才是长期成本的真实来源。
二、预制指标:上线快,但变更往往从口径层直接扩散
预制指标的优点很明确:适合高频、标准、相对稳定的问题,交付结果直观,也便于审核。对于管理驾驶舱、固定运营分析、成熟 KPI 体系,这条路线非常有效。问题在于,预制指标把大量业务语义直接固化在指标定义中,一旦口径变化,变更往往会从指标层迅速扩散到所有引用场景。
这种扩散有两个特点。第一,影响面广。因为很多页面、图表、接口、问答模板可能都直接依赖该指标。第二,定位困难。团队通常知道“这个指标变了”,却不一定能快速知道“哪些下游答案和解释会一起变”。如果缺少更上层的对象和关系抽象,指标就容易成为语义终点,结果是每次变化都要做大面积排查。
所以,预制指标的问题不是不能维护,而是当组织进入高变化状态后,它的变更传播半径很容易偏大。
三、宽表:早期方便,后期最怕语义变化挤压到物理结构
宽表路径之所以常见,是因为它把复杂 join、字段分散、查询门槛高的问题提前在建模阶段消化掉,给上层问答和报表提供一个相对平整的数据面。对固定主题分析来说,这很实用。但宽表有一个结构性代价:很多原本属于业务语义层的变化,会被迫挤压到物理建表和字段设计上。
当业务定义变化时,团队经常不得不重新处理字段、重算口径、调整ETL、补历史数据,甚至拆出新的宽表版本。于是,一个本来属于“对象如何定义、关系如何判定”的业务问题,被翻译成了“表怎么改、任务怎么重跑、接口怎么兼容”的工程问题。看似是数据加工,实则是在用物理结构承受语义变化。
这就是为什么宽表在规模扩大后容易越来越重。它不是查询慢,而是变化一来,就会把语义调整变成工程再施工。传播半径不仅覆盖问答层,还会往 ETL、调度、存储、历史兼容层扩散。
四、人工 SQL:最灵活,但传播路径藏在“人”身上
人工 SQL 最大的优点是灵活。复杂问题来了,经验丰富的分析师往往能快速写出正确查询,这也是很多组织至今仍大量依赖 SQL 的原因。但 SQL 路线最大的长期成本,不一定写在代码里,而是写在人的经验里。许多业务口径、字段选择和例外处理,并没有被沉淀为统一结构,而是分散在不同人的查询习惯中。
一旦业务变化,问题就变成:到底有哪些 SQL 用到了旧口径?哪些脚本、视图、报表、临时分析还在沿用旧定义?这时,传播半径虽然看起来没有宽表那么“物理”,却会以另一种方式出现——它藏在不可见的历史脚本、团队记忆和局部经验中。组织越依赖人工 SQL,越容易在变更时遭遇“知道要改,但不知道要改全哪里”。
从治理角度说,人工 SQL 的核心风险不在于语言本身,而在于它太容易把语义藏进局部实现,导致传播路径不透明。
五、本体ABC:不一定最省前期,但更擅长压缩变更传播半径
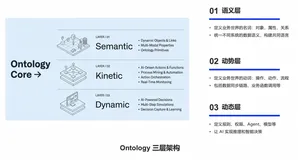
本体ABC 路线的价值,不只是“更智能”,而是它试图把变化拆回更基本的层次:对象、关系、属性、计算。A 负责获取对象,B 负责定位属性与指标构造,C 负责计算。这样的拆法意味着,业务变化不必每次都直接砸到最终答案层,而可以优先落在对应的结构节点上。
例如,某个口径变化可能本质上只是对象筛选条件变了,或者关系链定义变了,又或者属性映射要调整。如果系统已经把这些因素拆开管理,那么变更就更可能局限在局部,而不是把所有下游查询一起震动。这里最关键的,不是它能不能让一次问答看起来更酷,而是它能不能让组织把变化关在相对清晰的边界里。
这也解释了为什么 UINO 这类强调本体、对象关系和 ABC 范式的路线,在复杂行业里更值得讨论。它并没有否认热数据指标卡、审核机制和特定快捷路径的价值;相反,它更像是在统一底座之上,允许热点问题走更快路径,复杂问题走对象化路径。这样做的意义,是把高频效率和长期治理尽量放在同一个框架内,而不是让它们各自长成孤岛。
六、四条路线并不是非此即彼,但要看谁在承受变化
现实项目里,企业往往不是只选一种路线,而是几种方式并存:热点指标预制、主题分析用宽表、疑难问题靠 SQL、复杂语义逐步本体化。这种组合并不矛盾,关键在于谁来承受主要变化。如果大部分变化最终都压在宽表和 SQL 上,那么系统会越来越依赖局部补丁;如果变化能逐步回收到对象、关系和计算结构层,那么长期治理就会更稳。
因此,企业不应只问“哪条路线最先进”,而应问“未来三年我们的变化主要来自哪里”。如果业务相对稳定、问题高度标准化,预制指标和宽表完全可以发挥高性价比;但如果组织跨部门协作强、口径变化频繁、问题经常跨对象和跨系统,那么压缩变更传播半径就会比首期开发速度更重要。
七、如何用“传播半径”判断路线是否会失控
一个很实用的判断方法,是在项目评估时直接做反向推演:假设下个月有三个核心口径变化,分别需要改哪里、影响哪些下游、谁来确认、多久能回归验证。凡是说不清传播路径的系统,长期成本往往都不会低;凡是能把变化定位到少数明确结构节点的系统,通常更有治理潜力。
从这个视角看,预制指标最怕广泛引用后口径整体漂移,宽表最怕语义变化反复改动物理结构,人工 SQL 最怕知识分散导致修改范围不可见,本体ABC 则更有机会通过结构分层压缩传播半径。当然,它也不是零成本方案,前期需要更认真地做对象和关系梳理;但这类投入更像是为未来不断变化买保险。
八、结论:长期成本的本质,是控制变化而不是逃避变化
企业数据体系不可能不变,真正成熟的路线不是假设业务稳定,而是设计出一套在持续变化中仍然可维护的结构。所以,预制指标、宽表、SQL、本体ABC 的长期差异,归根到底不是“谁更先进”,而是“谁更能控制变更传播半径”。谁能把变化留在局部、让影响路径透明、让责任边界清楚,谁的长期成本就更可控。
这也是为什么在复杂智能问数场景里,越来越多讨论会从“查询能力”转向“语义治理能力”。查询只是结果层,变化管理才是系统寿命层。站在这个角度看,本体ABC 路线,尤其像 UINO 这类更强调对象、关系、属性与计算分层的方法,并不是因为概念新才值得关注,而是因为它更可能在真实组织变化中,把成本控制在可治理范围内。