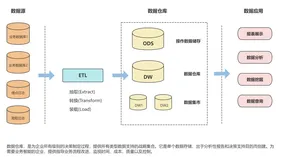
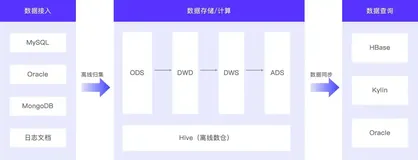
数据分层,核心就是为了实现数据的有序与可控。经过层层清洗、规整、聚合与优化,把零散、杂乱的原始数据转化为干净、标准、易用的数据产品。
我们常说的ODS、DWD、DIM、DWT……每一层都有各自的核心职责和统一加工规范。今天,就带大家全面了解数据分层的核心逻辑,理清每一层的定位与价值。
一、先说为什么要分层
同一个用户信息散落在核心系统、CRM系统、营销系统里,字段命名各不相同,口径也对不上。下游每个人都自己写逻辑从源头捞数据,重复计算,重复存储,出了问题也不知道从哪里查起。
分层的核心价值,说白了就是四件事:
第一,结构清晰。 每一层有明确的职责边界,数据在哪一层、做了什么处理,一目了然。
第二,血缘可追踪。 某张报表数据出了问题,能快速定位是哪一层、哪张表出了问题,影响范围有多大。
第三,减少重复计算。 公共的中间层数据只算一次,下游所有人共用,不用各自重新从源头跑一遍。
第四,屏蔽源系统复杂性。 源系统字段命名混乱、业务逻辑变更,这些变化由数仓内部消化,不传导到下游使用方。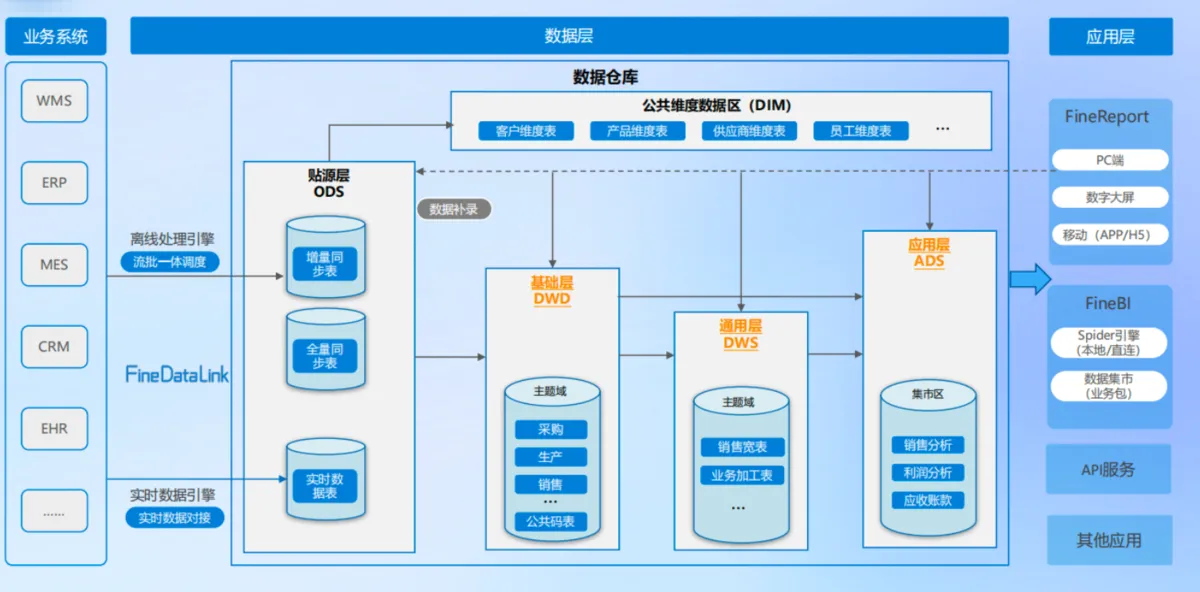
数仓分层的整体结构
目前业界比较通行的分层方式是:
ODS → DWD → DWS → DWT → ADS ↑ DIM(维表层,贯穿多层)
不同公司叫法可能略有差异,层数也不完全一样,有的三层,有的五层。我一直强调,分层不是目的,解决实际问题才是目的。
二、ODS:贴源层
ODS,全称 Operational Data Store,也叫数据引入层或贴源层。
这一层的核心就是把源系统的数据原封不动地同步过来。结构上与源系统保持一致,数据粒度最细,数据量也最大。
简单来说,ODS层应该做的是最基础的处理:格式错误的数据过滤掉,关键字段为空的记录丢弃,时间字段统一格式,字段命名做基本规范化。至于复杂的业务清洗逻辑,不建议放在这里。
数据存储策略上,ODS通常有三种方式:
- 增量存储:每天只存当天新增或变更的数据,按日期分区。适合数据量大、更新频繁的事务型数据,比如订单日志、行为日志。
- 全量存储:每天存储截止当天的全量数据。适合数据量小、变化缓慢的维度数据,比如商品类目表。
- 拉链存储:通过增加开始时间和结束时间两个字段,记录数据每次变更的历史状态。适合需要追踪历史变化的场景,比如用户状态变更。
历史数据一般保留3到6个月,数据量不大的情况下可以保留更长时间。
在实际落地过程中,很多企业会借助专业工具提升分层效率、降低落地难度,比如 FineDataLink 这类一站式的数据集成工具,支持多源数据集成,能轻松打破核心系统、CRM、营销系统等不同源头的数据壁垒,实现各类数据的高效整合与同步,完美匹配 ODS 层的多源数据接入需求。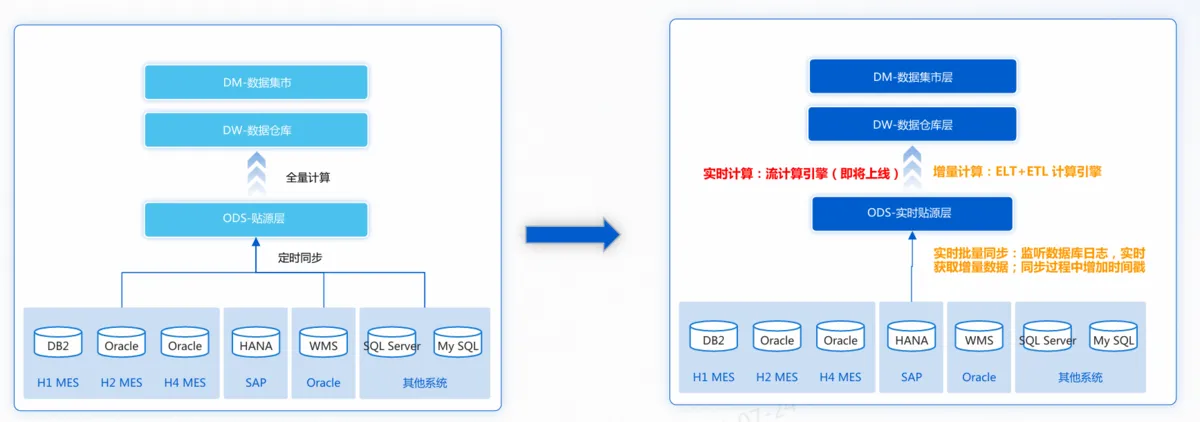
三、DWD:明细层
DWD,全称 Data Warehouse Detail,数据明细层。这一层是整个数仓体系里数据治理最密集的地方。它以业务过程为建模驱动,构建最细粒度的明细事实表。
DWD层主要做这几件事:
- 数据清洗。 去除空值、脏数据、枚举值异常、超出合理范围的数据。比如订单ID为空的记录,支付金额为负数的记录,直接过滤掉。
- 数据规范化。 来自不同源系统的同一字段,格式可能不一样。有的系统用0/1表示布尔值,有的用true/false;日期格式有的是时间戳,有的是字符串。这些都要在DWD层统一。
- 数据脱敏。 手机号、身份证号、银行卡号等敏感字段,在这一层做脱敏处理,防止下游误用。
- 维度退化。 这是DWD层一个比较重要的设计手段。简单来说,就是把一些维度信息直接冗余到事实表里,减少查询时的关联操作。比如订单ID这个维度,数据量极大,单独建一张维度表意义不大,就直接冗余在事实表里。
事实表里的每一条记录,代表一个具体的业务事件,比如一次下单、一次支付、一次退款。事实表里的度量值是可以统计的数字,比如下单金额、下单次数、退款金额。
DWD层的数据粒度通常与ODS层保持一致,但数据质量要比ODS层高得多。FineDataLink内置丰富的数据清洗、转换功能,能辅助 DWD 层完成数据规整、脱敏等治理工作,这一层是业务层与数仓之间的隔离层,下游不需要关心源系统有多复杂,只需要用DWD层干净、一致的数据。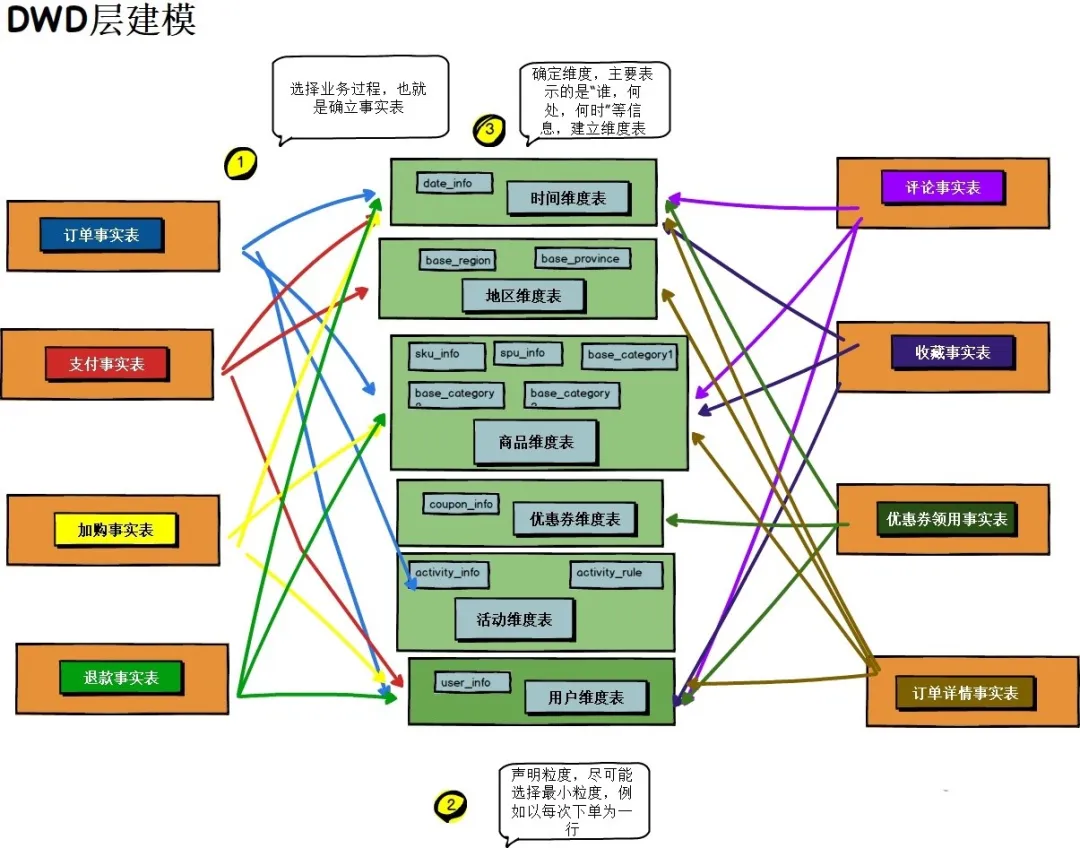
四、DIM:维表层
DIM,全称 Dimension,维表层。
维表存储的是描述性信息,是分析数据的角度和坐标。比如地区维表存储省、市、区的层级关系;日期维表存储年、月、周、季度的对应关系;商品维表存储商品名称、类目、品牌等属性。
维表分两类:
- 高基数维度:数据量大,比如用户资料表、商品资料表,可能有千万甚至上亿条记录。
- 低基数维度:数据量小,比如枚举值对应的中文含义、日期维表,可能只有几千条记录。
维表的设计原则是宽表化,把相关属性尽量放在一张表里,减少查询时的多表关联。同时,维表更新不宜过于频繁,对于缓慢变化的维度,通常用拉链表来处理历史变更。
五、DWS:数据服务层
DWS,全称 Data Warehouse Service,数据服务层。这一层以DWD为基础,按照分析主题对数据进行轻度汇总,通常以天为单位。
DWS不是把所有明细数据都聚合成一个数字,而是在保留一定粒度的前提下,把相关指标整合到一张宽表里。
比如用户主题的DWS宽表,会把一个用户在某一天的所有行为汇总到一行里——当天登录次数、下单次数、下单金额、支付次数、支付金额、加购次数……这些字段都在同一张表里,一行代表一个用户一天的行为总和。
DWS层的宽表字段往往很多,有的宽表有60到200个字段。这样设计的好处是,下游做分析的时候,大多数需求不需要再做复杂的关联,直接在这张宽表上聚合就能出结果。
DWS层按主题划分,常见的主题有:用户主题、商品主题、订单主题、流量主题、物流主题等。每个主题通常对应1到3张宽表。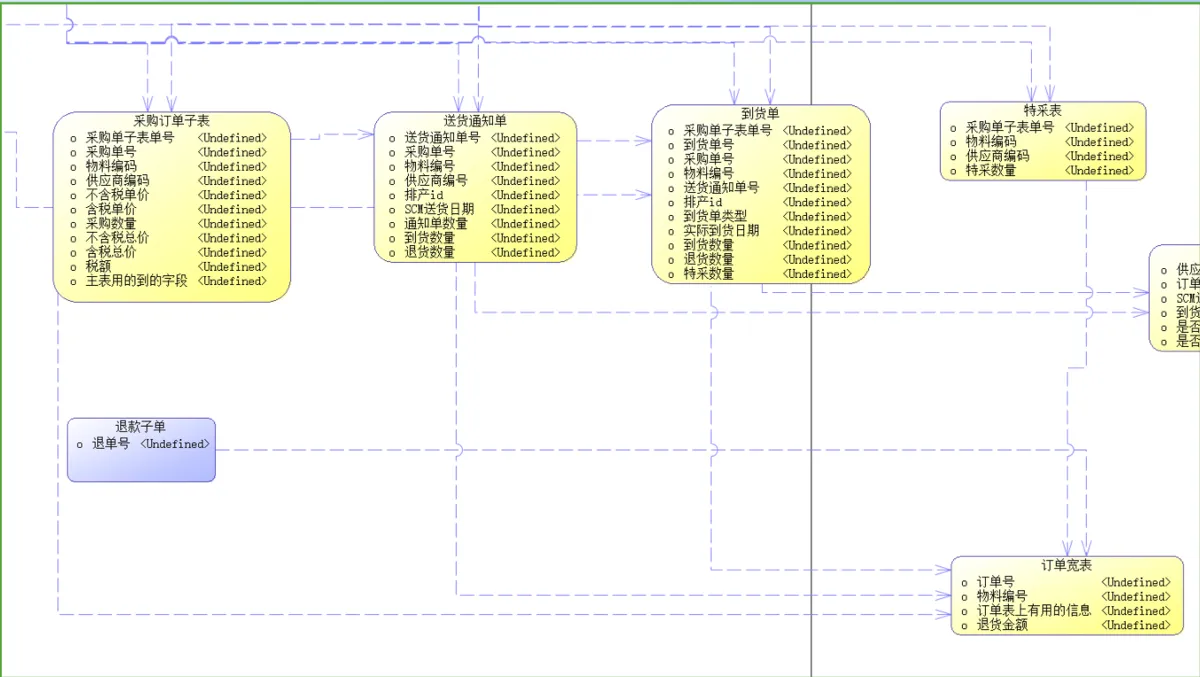
六、DWT:数据主题层
DWT,全称 Data Warehouse Topic,数据主题层。如果说DWS是按天汇总,那DWT就是把时间维度拉长,做累积汇总。
DWT层以DWS层数据为基础,构建主题对象的全量宽表。一行数据代表一个主题对象从开始到当前的累积行为。
比如用户主题的DWT宽表,一行代表一个用户从注册至今的全部行为总量——历史累计下单次数、历史累计支付金额、历史累计登录天数……
DWS和DWT的区别,说白了就是时间维度的差异:DWS是某一天的行为快照,DWT是截止到当前的历史累积。
DWT层的数据是以需求为驱动建模的,不再像DWD那样以业务过程为驱动。它更关注的是分析某个主题对象,需要哪些维度和指标,就把这些内容组织成一张宽表。
七、ADS:应用层
ADS,全称 Application Data Service,数据应用层。这是整个数仓体系的最上层,直接面向具体的业务需求。
ADS层的数据高度汇总,针对特定的业务场景定制。比如报表系统需要的日活月活数据、运营需要的用户留存率、商品团队需要的复购率排行、风控团队需要的异常用户名单……这些都在ADS层生成。
ADS层的数据通常会导入到MySQL、Redis、Elasticsearch等存储系统,供线上业务接口调用,或者导入到BI工具供分析师使用。
这一层的特点是数据量相对小,但针对性强,每张表都是为了满足某个具体的分析或应用场景而存在的。
八、层次调用规范
数仓各层之间的调用有严格的方向性,这一点我一直强调:
ODS → DWD → DWS → ADS ODS → DWD → ADS DWD → ADS DWS → ADS
各层之间禁止反向调用。ADS不能被DWS调用,DWS不能被DWD调用。这个规范一旦破坏,数据血缘就乱了,后续维护和排查问题会非常困难。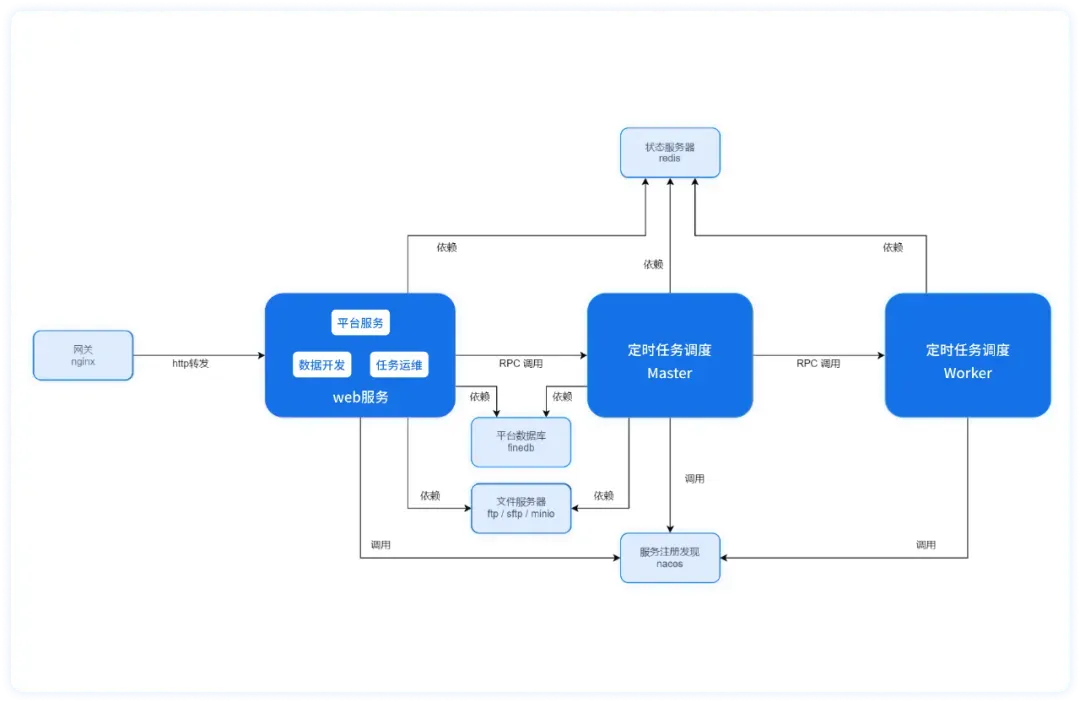
最后
数仓分层不是一个纯理论的问题,落地的时候会遇到很多现实困境。比如ODS和DWD的边界,有的公司在ODS层就做了比较精细的清洗,有的公司ODS层完全不处理,全部交给DWD。这没有绝对的对错,关键是团队内部要有一致的规范,不能各做各的。
还有一个常见的误区:认为层数越多越好,越分越细就越专业。实际上,每多一层就意味着多一层的开发成本、调度成本和维护成本。三层是最基础的,DW层内部如何细分,要根据自己公司的业务体量和团队能力来决定。
数仓分层的本质,是用结构化的方式管理数据复杂度。层次清晰了,数据才能真正流动起来,分析才能建立在可靠的基础上。