✅作者简介:热爱科研的Matlab仿真开发者,擅长毕业设计辅导、数学建模、数据处理、建模仿真、程序设计、完整代码获取、论文复现及科研仿真。
🍎 往期回顾关注个人主页:Matlab科研工作室
👇 关注我领取海量matlab电子书和数学建模资料
🍊个人信条:格物致知,完整Matlab代码获取及仿真咨询内容私信。
🔥 内容介绍
一、光伏功率预测的重要性
随着太阳能光伏发电在能源领域的占比不断增加,准确的光伏功率预测变得至关重要。一方面,光伏功率的间歇性和波动性给电力系统的稳定运行带来挑战,例如可能导致电网频率和电压波动。准确的预测有助于电力调度部门提前做好发电计划和负荷分配,保障电网安全稳定运行。另一方面,对于光伏电站运营商来说,精确的功率预测能够优化电站的运维管理,合理安排设备检修,提高发电效率和经济效益。
二、经验模态分解(EMD)原理
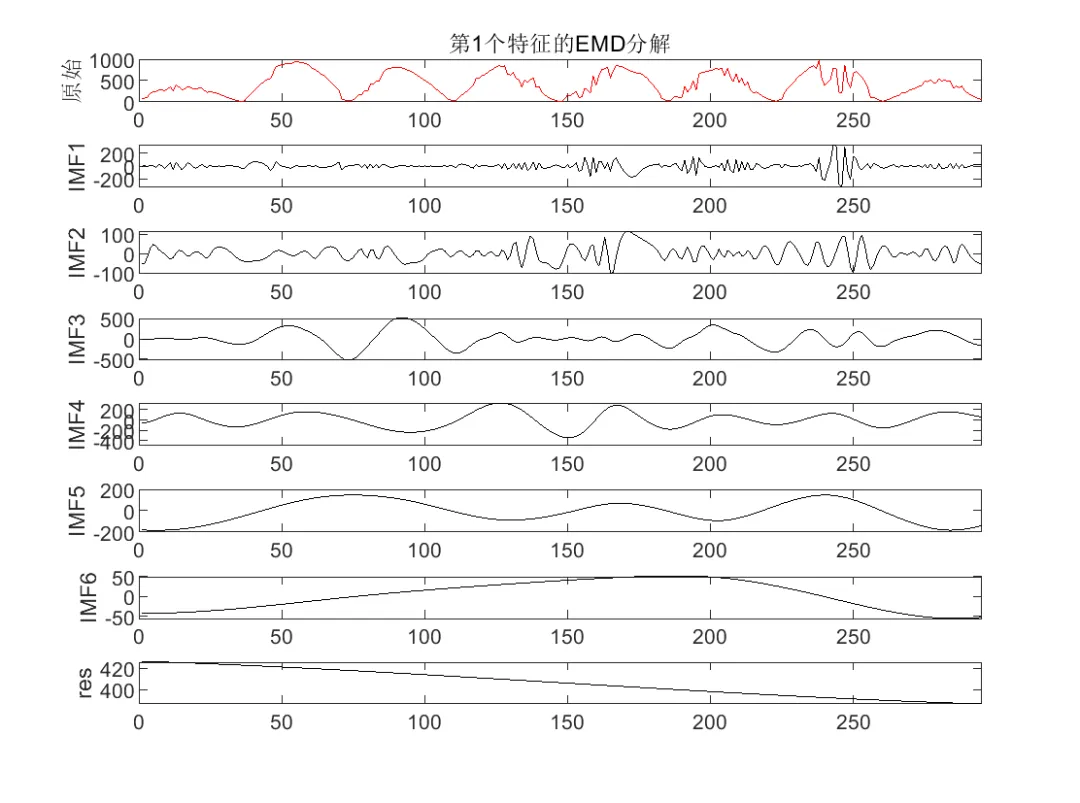
- 分解目的 :光伏功率受多种复杂因素影响,如光照强度、温度、云层变化等,其时间序列呈现出非线性和非平稳的特性。EMD 方法旨在将这种复杂的时间序列分解为一系列具有不同时间尺度的固有模态函数(IMF)。每个 IMF 分量都代表了原时间序列中不同频率特征的波动,从而将复杂的原始信号简化为多个相对简单且具有物理意义的分量。
- 分解过程 :EMD 通过筛选过程来确定 IMF。首先,找出时间序列的所有局部极大值和极小值,利用三次样条函数分别拟合出上包络线和下包络线,上下包络线的均值作为平均包络线。原时间序列减去平均包络线得到一个去掉低频成分的新序列,对这个新序列重复上述过程,直到满足一定的停止条件,得到第一个 IMF 分量。从原时间序列中减去第一个 IMF 分量,对剩余部分继续进行分解,依次得到其他 IMF 分量。最后剩下的趋势项为残余分量。这样,原光伏功率时间序列就被分解为多个 IMF 分量和一个残余分量之和。
三、主成分分析(PCA)原理
- 数据降维需求 :经过 EMD 分解得到的多个 IMF 分量虽然有助于分析光伏功率时间序列的特征,但这些分量之间可能存在相关性,且维度较高,增加了后续模型的计算复杂度。PCA 用于对这些 IMF 分量进行数据降维,在保留数据主要特征的同时减少维度。
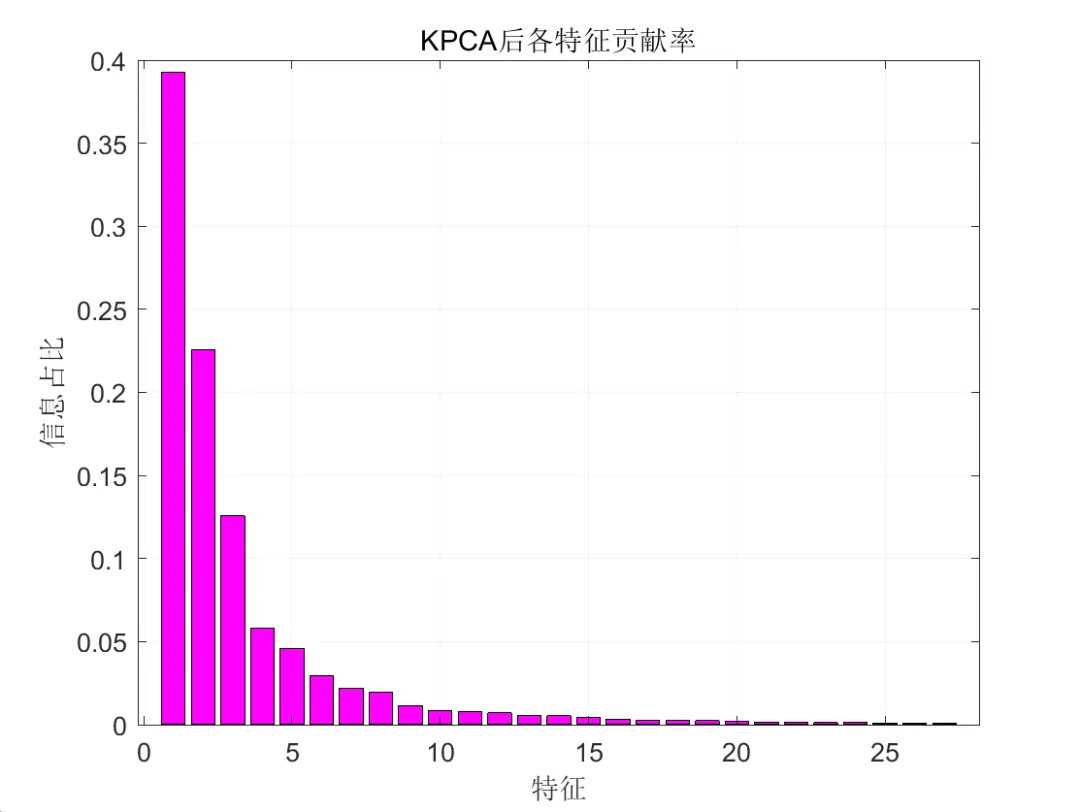
- 降维过程 :PCA 的核心是通过线性变换将原始数据投影到新的坐标系中。首先计算数据的协方差矩阵,协方差矩阵描述了各个变量之间的相关性。然后对协方差矩阵进行特征值分解,得到特征值和特征向量。特征值表示数据在对应特征向量方向上的方差大小,方差越大说明该方向上的数据信息越丰富。按照特征值从大到小的顺序选择前 k 个特征向量,这些特征向量构成了新的低维空间。将原始数据投影到这个新的低维空间,就实现了数据降维。在光伏功率预测中,通过 PCA 对 EMD 分解后的 IMF 分量进行降维,可以去除冗余信息,保留对光伏功率影响最大的主要成分,同时减少数据量,提高后续模型的训练效率。
四、长短期记忆网络(LSTM)原理
- 处理时间序列优势 :LSTM 是一种特殊的循环神经网络(RNN),专门用于处理时间序列数据中的长期依赖问题。传统 RNN 在处理长时间序列时容易出现梯度消失或爆炸的问题,导致难以学习到长期的依赖关系。LSTM 通过引入门控机制解决了这一难题。
- 门控机制 :LSTM 单元包含输入门、遗忘门和输出门。输入门决定当前输入信息有多少进入细胞状态,遗忘门控制细胞状态中保留多少过去的信息,输出门确定细胞状态中哪些信息将被输出。细胞状态就像一个传送带,能够在时间序列上传递信息,使得 LSTM 能够有效地捕捉时间序列中的长期依赖信息。在光伏功率预测中,LSTM 可以学习到光伏功率时间序列的历史数据与未来功率之间的复杂关系,利用这些信息进行准确的预测。
五、EMD - PCA - LSTM 光伏功率预测模型构建
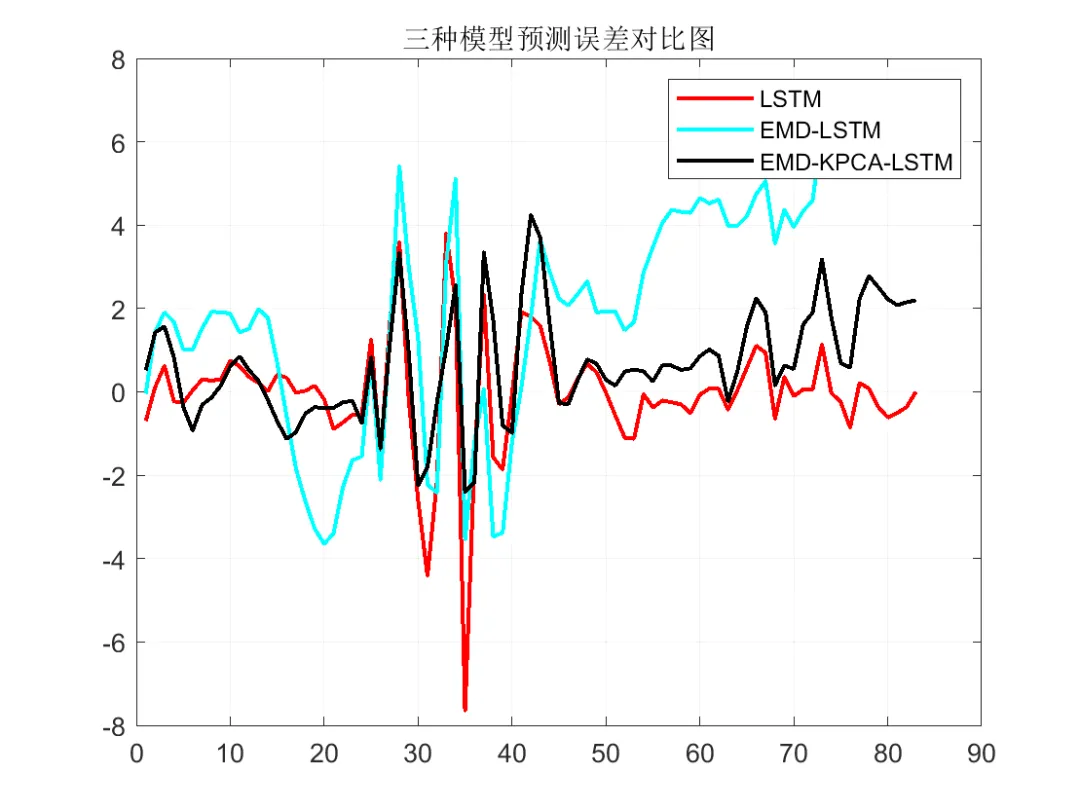
- 模型流程 :首先对光伏功率历史时间序列数据进行 EMD 分解,得到多个 IMF 分量和残余分量。然后对这些 IMF 分量进行 PCA 降维,去除冗余信息,保留主要特征。将降维后的 IMF 分量和残余分量作为 LSTM 模型的输入,LSTM 模型通过对这些数据的学习,挖掘光伏功率时间序列的内在规律和特征,从而对未来的光伏功率进行预测。
- 优势 :这种组合模型结合了 EMD 对非线性非平稳数据的分解能力、PCA 的数据降维能力以及 LSTM 处理时间序列长期依赖关系的优势。EMD 分解能够有效提取光伏功率时间序列中的不同频率特征,PCA 降维减少数据维度并去除冗余,LSTM 则基于处理后的数据进行精准预测。三者结合可以提高光伏功率预测的精度和效率,更好地应对光伏功率的复杂变化特性。
⛳️ 运行结果
 编辑
 编辑
 编辑
📣 部分代码
function Df = cfgaussder (t,nu,mu,sigma)
% Read input arguments
%
if nargin < 4
sigma = sqrt(2)/2;
if nargin < 3
mu = 0;
if nargin < 2
nu = 0.5;
if nargin < 1
error('There is not value for t, Df = cfgaussder(t)');
end
end
end
end
if size(t,1) ~= 1, t = t'; end
%% CRUZ and AVINA :: MODIFIED
% Calculate the theoretical function value
alpha = nu./(1 - nu);
par1 = -(t - mu - sigma^2.*alpha/2).*alpha;
par3 = (mu/sigma + sigma.*alpha)/sqrt(2);
par2 = t/sigma/sqrt(2) - par3;
%% Explicit PseudoGaussian Integrals (mu - x).
[rows,columns] = size(t);
fcn = @(x, a1, t1) exp(-(x.*x - 2*x.*(mu + sigma^2.*a1) + mu^2 + ...
2*sigma^2.*a1.*t1)/2/sigma^2);
Y = nan(rows,columns);
for ir = 1 : rows
for ic = 1 : columns
Y(ir,ic) = integral(@(x) fcn(x,alpha,t(ir,ic)), 0, t(ir,ic));
end
end
K1 = sqrt(1/2/pi)*(1+alpha);
Df1 = K1.*(exp(par1-par2.^2)-exp(par1-par3.^2))/sigma;
Df2 = K1.*alpha.*Y/sigma;
Df = Df1-Df2;
🔗 参考文献
[1]张雲钦,程起泽,蒋文杰,等.基于EMD-PCA-LSTM的光伏功率预测模型[J].太阳能学报, 2021.DOI:10.19912/j.0254-0096.tynxb.2019-0817.
🍅往期回顾扫扫下方二维码