API 视角:Gemini 3.1 Flash (Nano Banana 2) 图像生成能力基准测试

简介: 本文基于Nano Banana AI实测,评测Gemini 3.1 Flash图像生成能力:在Prompt遵循度(精准颜色绑定)、OCR文本生成(端到端可读路牌)、高分辨率细节(2K无伪影)三方面表现优异,具备高准确度、原生多模态与低延迟(<10s),适合广告、游戏资产及合成数据等云上生产场景。

作为云架构师,我们评估一个模型 API 是否值得集成到生产环境,主要看其能力边界 (Capability Frontier)、稳定性 (Stability) 以及可控性 (Controllability)。

本文基于 API 实测数据,对 Google Gemini 3.1 Flash 的图像生成能力进行基准评测。测试工具为 Nano Banana AI 。

1. Prompt 遵循度测试 (Prompt Adherence)

Prompt 遵循度决定了 API 是否“听话”,即能否准确执行开发者的指令,而不发生幻觉或遗漏。

测试用例:

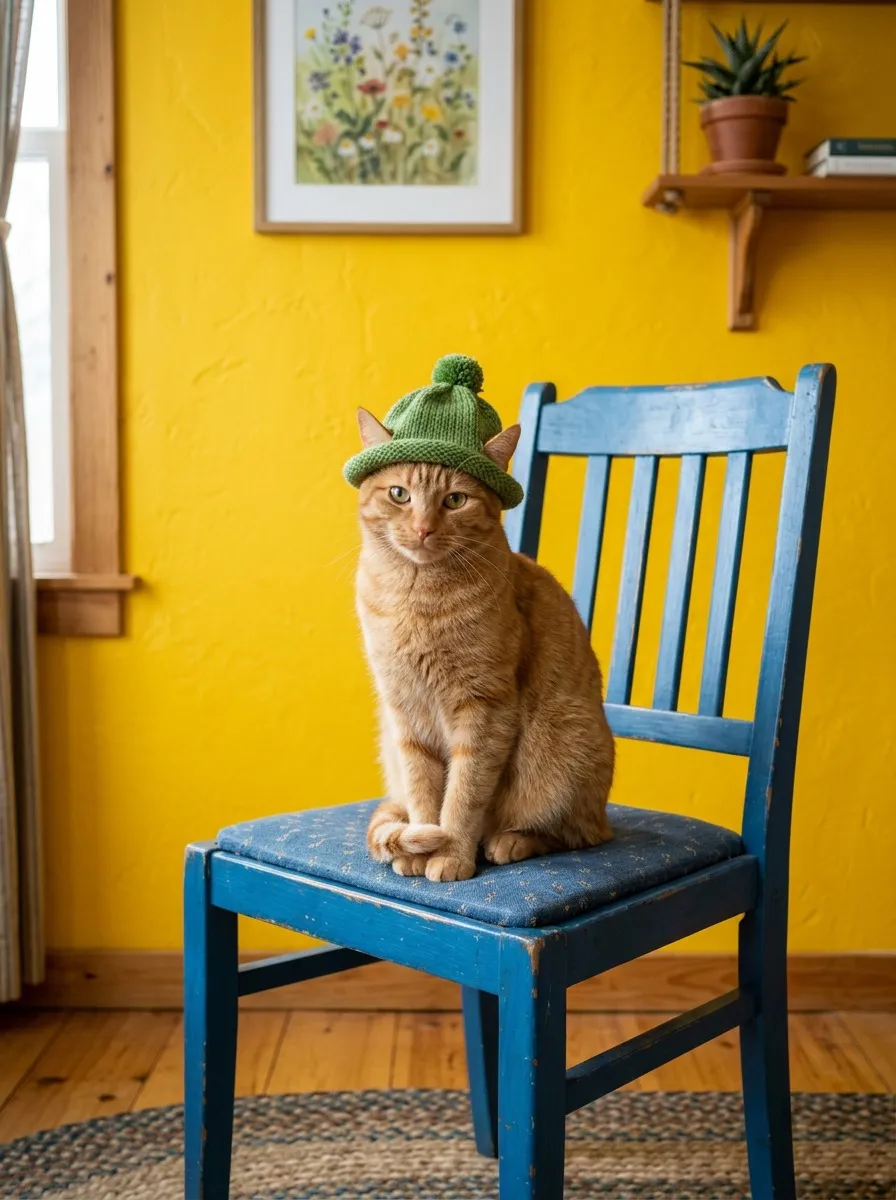
"一只红色的猫,坐在蓝色的椅子上,戴着绿色的帽子,背景是黄色的墙。" (测试颜色绑定能力)
nanobanana-edited-2026-02-27T03-08-22-896Z.jpg

结果分析:

  • 颜色解耦:模型准确地将四种颜色分配给了正确的对象(猫-红,椅-蓝,帽-绿,墙-黄)。
  • 无溢出:未出现常见的“颜色溢出”(Color Bleeding)现象(例如椅子变红、猫变绿)。这表明其 Cross-Attention 机制非常精准,能够正确处理多个形容词与名词的绑定关系。

2. OCR 与 文本生成能力 (Text Generation)

在构建交通标志识别训练集、或自动生成路引数据的场景中,生成准确的文字至关重要。

测试用例:

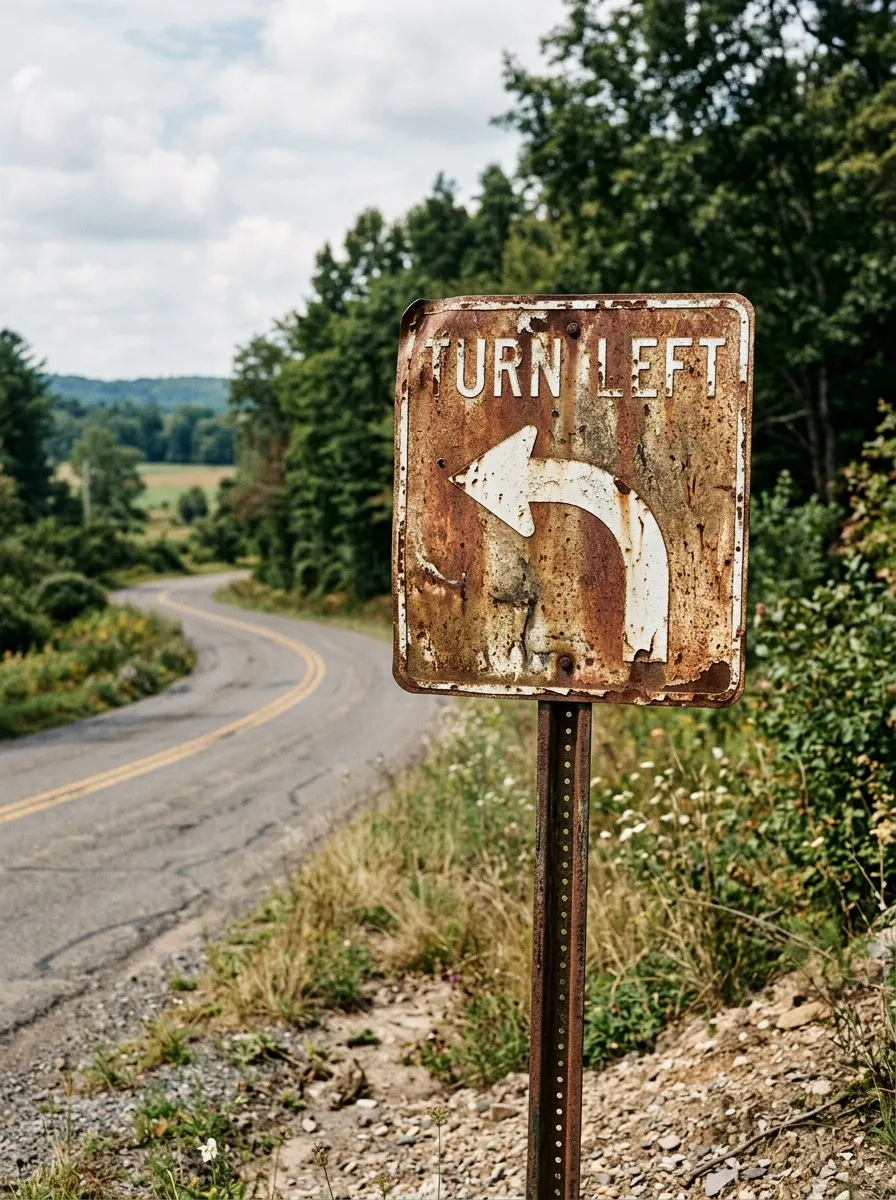
"A rusty road sign indicating 'Turn Left' with a curved arrow, realistic style."
nanobanana-edited-2026-02-27T03-10-07-666Z.jpg

结果分析:

  • OCR 可读性:生成的路牌上清晰地写着 "Turn Left",字母间距合理,对比度高。
  • 语义一致性:箭头正确地指向了左边,与文字内容匹配。
  • 价值:相比于需要额外 OCR 矫正的旧模型,Flash 模型展现了 End-to-End 的图文生成能力,大大简化了合成数据生成的管线。

3. 分辨率与伪影测试 (Artifacts & Resolution)

在大场景生成中,低分辨率模型往往会导致远景模糊或出现伪影。

测试用例:

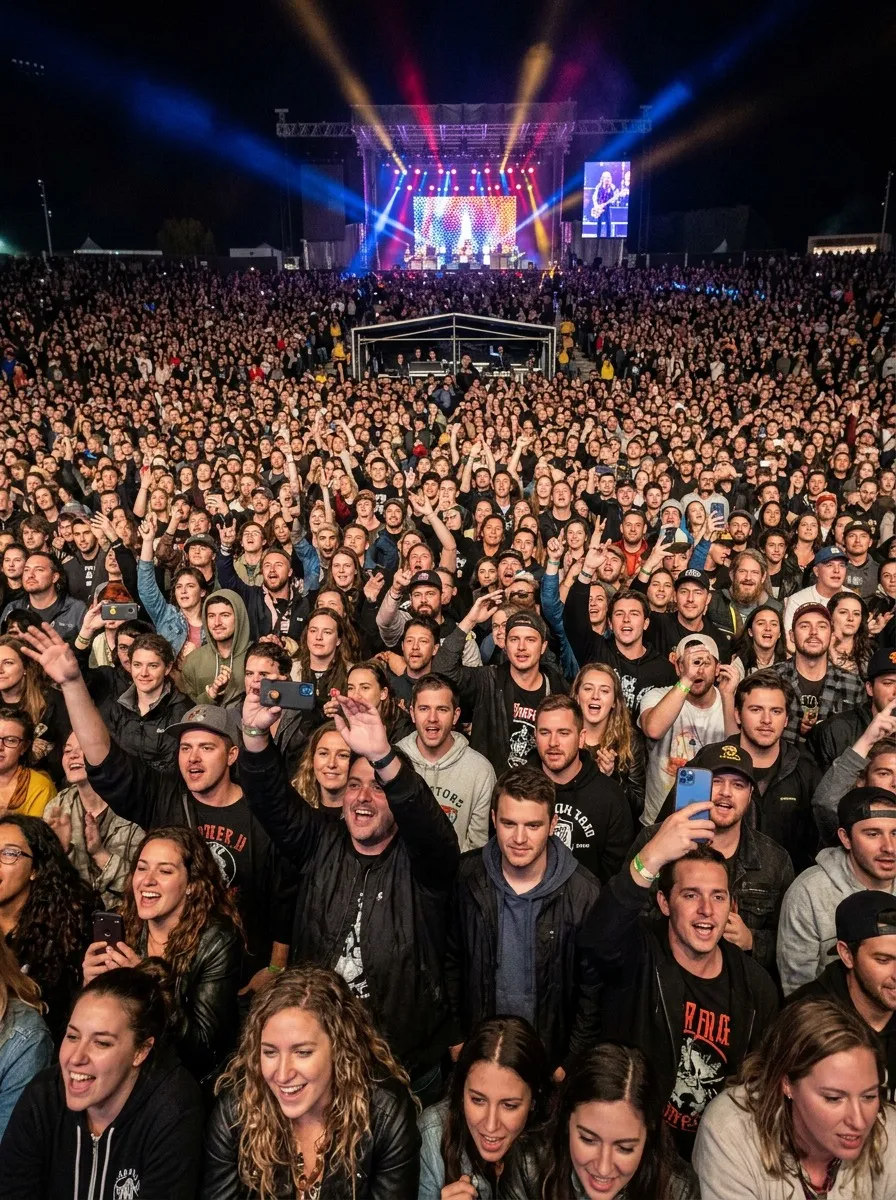
"Crowded concert audience, wide angle shot, 4k resolution, detailed faces." (拥挤的音乐会观众,广角,4k)nanobanana-edited-2026-02-27T03-11-17-799Z.jpg

结果分析:

  • 远景细节:在大场景、多主体(人群)生成中,远处的面部通常是 AI 的重灾区。Flash 模型在 2K 原生分辨率下,远处观众的面部结构保持了基本的完整性(五官位置正确),没有崩坏成扭曲的色块。
  • 无重复纹理:没有出现为了填充像素而产生的重复纹理(Tiling Artifacts)。
  • 原生优势:原生高分辨率极大地提升了复杂场景的可用性,无需依赖后置的 Upscaler。

4. 结论与架构建议

从 API 调用的角度来看,Gemini 3.1 Flash Image Preview 是一个高可用的图像生成后端。

  • 高准确度:精准的 Prompt 遵循和颜色绑定,适合程序化生成(Programmatic Generation)。
  • 原生多模态:集成了优秀的文本生成能力,减少了后处理步骤。
  • 高性能:<10s 的 P90 Latency,支持高并发调用。

架构建议:
它非常适合集成到需要精准控制、高频调用的云端应用中,如:

  1. 动态广告生成系统:根据用户画像实时生成带价格和文案的 Banner。
  2. 游戏资产自动化管线:批量生成道具图标、纹理贴图。
  3. 合成数据生成 (Synthetic Data):为计算机视觉模型训练生成带标注的高质量图像数据。
目录
相关文章
|
人工智能 Java API
Google Gemini API 接口调用方法
Google 最近发布的 Gemini 1.0 AI 模型通过其升级版,Gemini,标志着公司迄今为止最为强大和多功能的人工智能技术的突破。
|
算法 Unix API
指数退避(Exponential backoff)在网络请求中的应用
## 一、背景 最近做云服务 API 测试项目的过程中,发现某些时候会大批量调用 API,从而导致限流的报错。在遇到这种报错时,传统的重试策略是每隔一段时间重试一次。但由于是固定的时间重试一次,重试时又会有大量的请求在同一时刻涌入,会不断地造成限流。 这让我回想起两年前在查阅[Celery Task 文档](http://docs.celeryproject.org/en/latest
15228 1
|
7月前
|
人工智能 Linux API
OpenClaw阿里云/本地保姆级部署使用教程!支持的ACP协议详解+免费大模型API配置+避坑指南
2026年开源AI代理框架OpenClaw在发布重磅版本,正式全面支持ACP(Agent Client Protocol)协议,彻底改写AI代理生态协作规则。这一更新让Codex、Claude Code、Gemini等顶级编码AI成为OpenClaw的一级子代理,实现跨模型无缝调度,中英日开发者社区瞬间引爆,单条更新推文最高斩获636万浏览、3699个点赞,标志着AI代理从各自为战的草莽时代,迈入协议统一、工程化落地的标准化新阶段。
2628 1
|
8月前
|
人工智能 监控 API
Claude Code终于有仪表盘了:3条命令装个HUD,上下文用了多少一眼就知道
老金我最近用Claude Code,遇到一个特别烦的事。 写着写着,突然蹦出来一句"context window is getting full"。 然后AI就开始犯傻了——回答变短、逻辑变乱、之前说好的方案全忘了。 每次遇到这种情况,老金我都想骂人。 问题出在哪? Claude Code的终端界面,压根看不到上下文用了多少。 你只能输入 /context手动查,但谁写代码的时候
13247 10
|
6月前
|
机器学习/深度学习 缓存 测试技术
DeepSeek-V4开源:百万上下文,Agent能力比肩顶级闭源模型
DeepSeek-V4正式开源!含V4-Pro(1.6T参数)与V4-Flash(284B参数)双版本,均支持百万token上下文。首创混合注意力架构,Agent能力、世界知识与推理性能全面领先开源模型,数学/代码评测比肩顶级闭源模型。
7858 12