
你好,我是maoku。
我们之前探讨了如何用强化学习(RL)“教化”大语言模型,赋予其价值观。今天,我们将目光转向一个更具挑战性的领域——具身智能(Embodied AI)。在这里,智能体不再仅仅是处理文本的“大脑”,而是拥有了一个需要在物理世界中行动的“身体”。
想象一下,教一个机器人从零开始学会走路、抓取物品,甚至组装家具。这其中的核心算法,同样是强化学习,但难度呈指数级上升。本文将作为你进入具身智能算法世界的“引路人”,我们将绕过繁杂的数学,用直觉、比喻和清晰的实践路径,把核心原理与实现步骤讲透。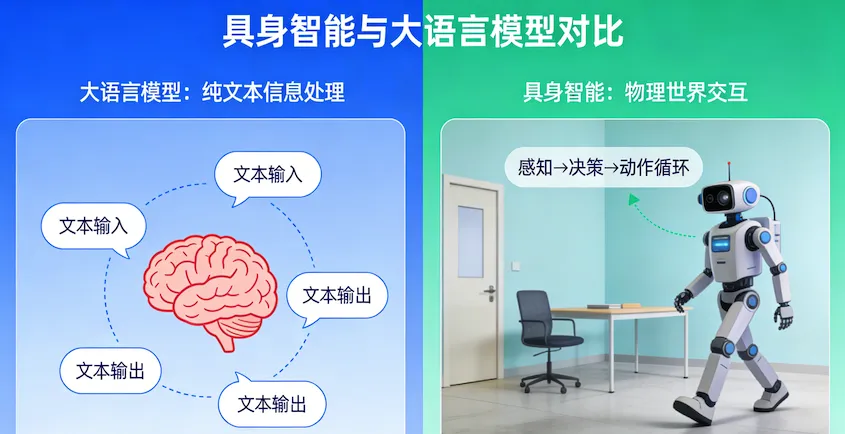
一、引言:为什么具身智能是RL的终极试炼场?
具身智能的核心思想是:智能源于身体与环境的互动。一个智能体(如机器人)通过传感器感知世界,通过执行器(如电机)影响世界,并从这种互动中学习。
为什么它如此困难?
- 感知的复杂性:物理世界是连续、高维且充满噪声的。机器人需要融合摄像头(视觉)、陀螺仪(本体感觉)、力传感器(触觉)等多种信息,才能“理解”自身状态。
- 动作的连续性:机器人的动作(如关节角度、电机扭矩)是连续的,且受物理规律(如惯性、摩擦力)严格约束,不像选择文本中的一个词那样离散。
- 试错成本极高:在现实中让机器人随机探索、跌倒成千上万次,既危险又昂贵。因此,仿真模拟器(如MuJoCo, Isaac Sim)成为了核心训练场。
- 仿真到现实的鸿沟:在仿真中学得再好,直接搬到真实的机器人上,往往因为模型不精确(如摩擦力、材质弹性)而失败。
强化学习,正是解决“如何在复杂、不确定的交互中,通过试错找到最优行为策略”这一核心问题的钥匙。而具身智能,则是对RL算法鲁棒性、样本效率、泛化能力的全面大考。
二、技术原理:攻克具身化的三大核心挑战
要让RL算法在“身体”上发挥作用,我们必须先解决几个根本问题。
挑战一:如何让机器“感知”世界?—— 状态表示
人类通过眼睛、耳朵、皮肤等多种感官综合感知世界。机器人亦然。我们无法将原始的像素和传感器读数直接丢给RL算法,需要先进行编码。
多模态感知融合是标准解决方案:
- 视觉编码器:处理RGB或深度(Depth)图像。通常使用一个预训练的卷积神经网络(如ResNet),将一张图片压缩成一个有意义的特征向量。
- 本体感知编码器:处理机器人自身的关节角度、角速度、扭矩等数据。这通常用一个简单的多层感知机(MLP)来处理。
- 融合:将视觉特征和本体感知特征拼接(Concatenate)起来,形成一个全面的状态表示,再输入给RL的策略网络。
通俗理解:这就好比你在走路时,眼睛(视觉)告诉你前面有台阶,肌肉和关节的感觉(本体感知)告诉你当前腿的弯曲程度。你的大脑(RL策略网络)需要同时结合这两类信息,才能决定“迈多大的步子”这个动作。
挑战二:如何让机器“行动”自如?—— 动作空间
机器人的动作是连续的物理量。RL算法需要输出的是每个关节电机的目标角度或扭矩。这带来了两个要求:
- 连续性:策略网络通常输出一个高斯分布的均值和方差,然后从这个分布中采样得到具体动作。这既保证了探索(随机性),又能进行连续的策略更新。
- 分层控制:对于复杂任务(如“去厨房拿杯水”),直接学习从像素到每一个电机扭矩的映射极其困难。高级的解决方案是分层强化学习:高层策略将任务分解为“移动”、“抓取”、“返回”等子技能;底层策略则负责执行每个子技能的具体动作序列。
挑战三:如何在仿真中学会现实?—— 领域迁移
这是具身智能从研究走向应用的关键瓶颈。我们用两个核心战术来解决:
- 动力学随机化:在仿真训练时,随机化物理参数(如质量、摩擦力、执行器力度)。让机器人在成千上万种不同的“物理规律”下学习。这样,当它遇到现实世界(无非是另一种没见过的随机参数)时,就有了很强的泛化能力。
- 系统辨识与自适应:在真实机器人上少量试运行,收集数据,反推出现实世界的物理参数,并据此微调仿真模型或策略本身。这是一个“用实践修正理论”的过程。
三、实践步骤:从PPO到SAC的算法进化之路
理论铺垫完毕,让我们进入激动人心的实操环节。下面是一个循序渐进的四周学习路线图。
第一周:打好地基,掌握PPO
PPO(近端策略优化) 是RL在具身智能领域的“瑞士军刀”。它稳定、易于调参,是绝佳的入门算法。
核心思想(回顾):PPO的核心是“小步快跑,不忘根本”。它通过裁剪机制限制每次策略更新的幅度,防止因单次更新过大而崩溃;同时通过与一个参考策略(通常是旧策略或一个基础策略)保持相似性(KL散度约束)来维持稳定性。
具身智能中的PPO调参要点:
- 裁剪系数ε:通常设在
0.1~0.3之间。这是策略更新的“步长限制器”,值越小更新越保守。 - GAE参数λ:通常设为
0.9~0.99。这个值越高,算法在估计优势时看得越“长远”。 - 实战任务:在MuJoCo仿真环境中,尝试让“蚂蚁”(Ant)或“人形机器人”(Humanoid)学会行走。你的目标是复现经典论文中的性能曲线。
第二周:追求高效,进阶SAC
当你熟悉PPO后,会发现它在复杂任务上可能样本效率较低(需要更多次的环境交互)。这时,SAC(软演员-评论家) 就该登场了。
SAC为何更强大?
- 最大熵原则:SAC不仅要求回报高,还要求策略的随机性(熵)尽可能大。这激励智能体进行更充分的探索,避免过早陷入局部最优。就像一个好奇心旺盛的孩子,愿意尝试多种走法,而不仅仅是跟着脚印走。
- 双Q网络:使用两个独立的Q值估计网络,并取其中的较小值来计算目标,有效缓解了RL中常见的Q值过估计问题,让学习更稳定。
- 自动化:SAC能自动调节“探索”(熵)与“利用”(奖励)之间的平衡系数,减少了关键超参数的手动调优。
从PPO切换到SAC:你可以明显感觉到,在同样的训练步数下,SAC能让机器人更快地学到有效策略。它是目前解决复杂连续控制任务(如灵巧手操作)的主流选择。
第三周:师从专家,模仿学习加速
纯粹的RL是从“随机乱动”开始学起,效率低下。如果有一些专家演示数据(哪怕只是人类遥控机器人录下的动作轨迹),我们可以用模仿学习来“开个好头”。
经典范式:行为克隆 + RL微调
- 行为克隆:像监督学习一样,直接用专家数据训练策略网络去模仿专家的动作。这能让机器人快速获得一个不错的初始策略。
- RL微调:将专家数据与智能体自己交互得到的数据混合放入经验池,然后用SAC等算法继续训练。这样,智能体既能巩固专家知识,又能超越专家水平,探索出更优解。
第四周及以后:挑战高阶,融合高级技巧
掌握了上述基础,你就可以尝试组合更强大的技术:
- 分层强化学习:为机器人建立“技能库”。高层大脑负责规划“用什么技能”,底层小脑负责“如何执行技能”。这是解决长 horizon(多步骤)任务的利器。
- 自动课程学习:让训练环境根据智能体的表现动态调整难度。成功率太高就增加干扰或提高精度要求;成功率太低就简化任务。这就像一位聪明的教练,为学生量身定制训练计划。
- 系统化工具实践:理论到实践的最后一步,往往是工程实现的复杂度。对于希望快速验证想法、专注算法本身而非底层框架的研究者,可以利用一些高度集成的平台。例如,【[LLaMA-Factory Online]】这类工具虽然最初为大模型设计,但其模块化、可视化的思想,同样适用于管理和实验复杂的具身智能训练流水线,能有效管理仿真环境、算法实现和超参数调优。
四、效果评估:超越“分数”的多维体检
在具身智能中,仅看累积奖励(训练曲线)是远远不够的。一个“好用”的机器人策略需要经过多维度评估:
- 成功率:最硬核的指标。在N次独立测试中,成功完成任务的次数比例。
- 样本效率:学习曲线下的面积。它衡量算法“学到相同水平需要尝试多少次”。SAC通常优于PPO。
- 泛化能力:
- 扰动测试:给机器人施加干扰(如推它一下),看它能否恢复平衡和任务。
- 跨场景测试:在训练未见过的新物体、新灯光、新背景纹理下测试。
- 运动质量:
- 能量效率:完成任务所消耗的能量(与关节扭矩的平方和相关)。优雅的策略通常更节能。
- 平滑度:计算动作的“急动度”(Jerk,加速度的导数)。真实、安全的机器人动作应该是平滑的,而非剧烈抖动的。
- 仿真到现实的成功迁移:这是终极检验。将在仿真中训练好的策略直接部署到真实机器人上,评估其性能保持率。
五、总结与展望
具身智能的强化学习之路,是一场从理论算法到物理直觉的深刻融合。我们总结一下关键收获:
- PPO是可靠的起点,其稳定性让你能专注于理解RL训练的基本循环和具身智能的独特挑战。
- SAC是高效的进阶,其最大熵框架和自动调参特性,使其成为解决复杂任务的首选。
- 模仿学习是强大的助推器,能用专家知识显著加速训练进程。
- 领域随机化和课程学习是跨越“仿真-现实”鸿沟的桥梁,它们让算法学会的不是一个特解,而是应对变化的通法。
展望未来,具身智能的研究正朝着更通用、更安全、更高效的方向发展。未来,我们可能看到:
- 更多基础模型:如同大语言模型,能理解物理场景、具备通用操作技能的“具身基础模型”。
- 更紧密的人机协作:机器人不仅能从人类演示中学习,还能理解人类的模糊指令和意图。
- 全天候训练系统:在仿真与现实构成的循环中,实现7x24小时不间断的自进化学习。
这条道路虽然漫长,但每一步都充满魅力。当你看到自己编写的算法让虚拟的“蚂蚁”从蹒跚学步到健步如飞,那份成就感是独一无二的。
真正的突破,往往诞生于你对算法的深刻理解与对物理世界的敏锐直觉交汇的那一刻。 现在,是时候打开MuJoCo,开始你的第一次训练了。祝你训练顺利!
思考与实践:
如果让你设计一个让机器人学会“用壶倒水”的RL任务,你会如何设计奖励函数?如何构建课程学习的难度阶梯?欢迎在评论区分享你的设计方案。


