Transformer基础结构

简介: Transformer是Vaswani等人于2017年提出的基于注意力机制的神经网络架构,摒弃了传统RNN,实现并行化处理,显著提升自然语言处理性能。其核心为编码器-解码器结构,通过自注意力机制捕捉长距离依赖,结合位置编码、残差连接与层归一化,有效训练深层模型。多头注意力机制增强特征表达能力,广泛应用于机器翻译、文本生成等任务,成为现代大模型基石。

Transformer是一种基于注意力机制的神经网络架构,由Vaswani等人在2017年提出,彻底改变了自然语言处理领域。
🏗️ 核心组件
1️⃣ 编码器-解码器架构
● 编码器:将输入序列转换为隐藏表示
● 解码器:基于编码器输出生成目标序列
2️⃣ 关键创新
● 自注意力机制:并行处理序列,捕获长距离依赖
● 位置编码:为模型提供序列位置信息
● 残差连接:缓解深层网络训练问题
● 层归一化:稳定训练过程
📋 架构详解
编码器结构
每个编码器层包含:

  1. 多头自注意力:计算输入序列内部关系
  2. 前馈神经网络:非线性变换
  3. 残差连接和层归一化
    解码器结构
    每个解码器层包含:
  4. 掩码多头自注意力:防止信息泄露
  5. 编码器-解码器注意力:关注输入序列
  6. 前馈神经网络
  7. 残差连接和层归一化
    🔍 数学原理
    缩放点积注意力
    $\text{Attention}(Q,K,V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$
    多头注意力
    $\text{MultiHead}(Q,K,V) = \text{Concat}(\text{head}_1,...,\text{head}_h)W^O$
    其中 $\text{head}_i = \text{Attention}(QW_i^Q, KW_i^K, VW_i^V)$
    🚀 代码示例
    import torch
    import torch.nn as nn

class TransformerBlock(nn.Module):
def init(self, d_model, n_heads, d_ff, dropout=0.1):
super().init()
self.attention = nn.MultiheadAttention(d_model, n_heads)
self.feed_forward = nn.Sequential(
nn.Linear(d_model, d_ff),
nn.ReLU(),
nn.Linear(d_ff, d_model)
)
self.norm1 = nn.LayerNorm(d_model)
self.norm2 = nn.LayerNorm(d_model)
self.dropout = nn.Dropout(dropout)

def forward(self, x, mask=None):
    # 自注意力 + 残差连接
    attn_output, _ = self.attention(x, x, x, attn_mask=mask)
    x = self.norm1(x + self.dropout(attn_output))

    # 前馈网络 + 残差连接
    ff_output = self.feed_forward(x)
    x = self.norm2(x + self.dropout(ff_output))

    return x

📚 深入阅读
● 原始论文:Attention Is All You Need
● 分词器详解
● 注意力机制详解

相关文章
|
机器学习/深度学习 人工智能 自然语言处理
编码器-解码器架构详解:Transformer如何在PyTorch中工作
本文深入解析Transformer架构,结合论文与PyTorch源码,详解编码器、解码器、位置编码及多头注意力机制的设计原理与实现细节,助你掌握大模型核心基础。建议点赞收藏,干货满满。
2384 3
|
7月前
|
机器学习/深度学习 人工智能 自然语言处理
手撕 Transformer:从原理到代码,一步步造一个“小型大模型”
1057 6
|
9月前
|
监控 搜索推荐 物联网
一文读懂LoRA微调原理:大模型高效适配的核心逻辑
通过冻结大模型参数、仅训练少量低秩矩阵,实现高效微调:成本低、周期短、不破坏通用能力。适配医疗、金融等垂直场景,支持多任务复用与边缘部署,成为大模型落地首选技术。
一文读懂LoRA微调原理:大模型高效适配的核心逻辑
|
9月前
|
存储 人工智能 数据库
2026 AI Agent 搭建师职业全景指南:从技术基石到商业闭环
2026年,AI职业迎来范式变革,“AI Agent搭建师”取代提示词工程师,成为集架构设计、系统集成与智能协同于一体的“数字流程总设计师”。他们构建具备感知-思考-行动闭环的智能体,推动企业从“聊天机器人”迈向“行动中心”与“数字员工团队”。通过异构模型路由、多智能体编排、MCP工具协议与GraphRAG记忆系统等核心技术,实现业务流程自动化与决策智能化。该职业融合技术、业务与战略,人才缺口巨大,薪酬领先,被誉为AI时代的“黄金职业”,并持续向AI架构师与伦理治理等方向演进。
2189 1
|
机器学习/深度学习 人工智能 数据可视化
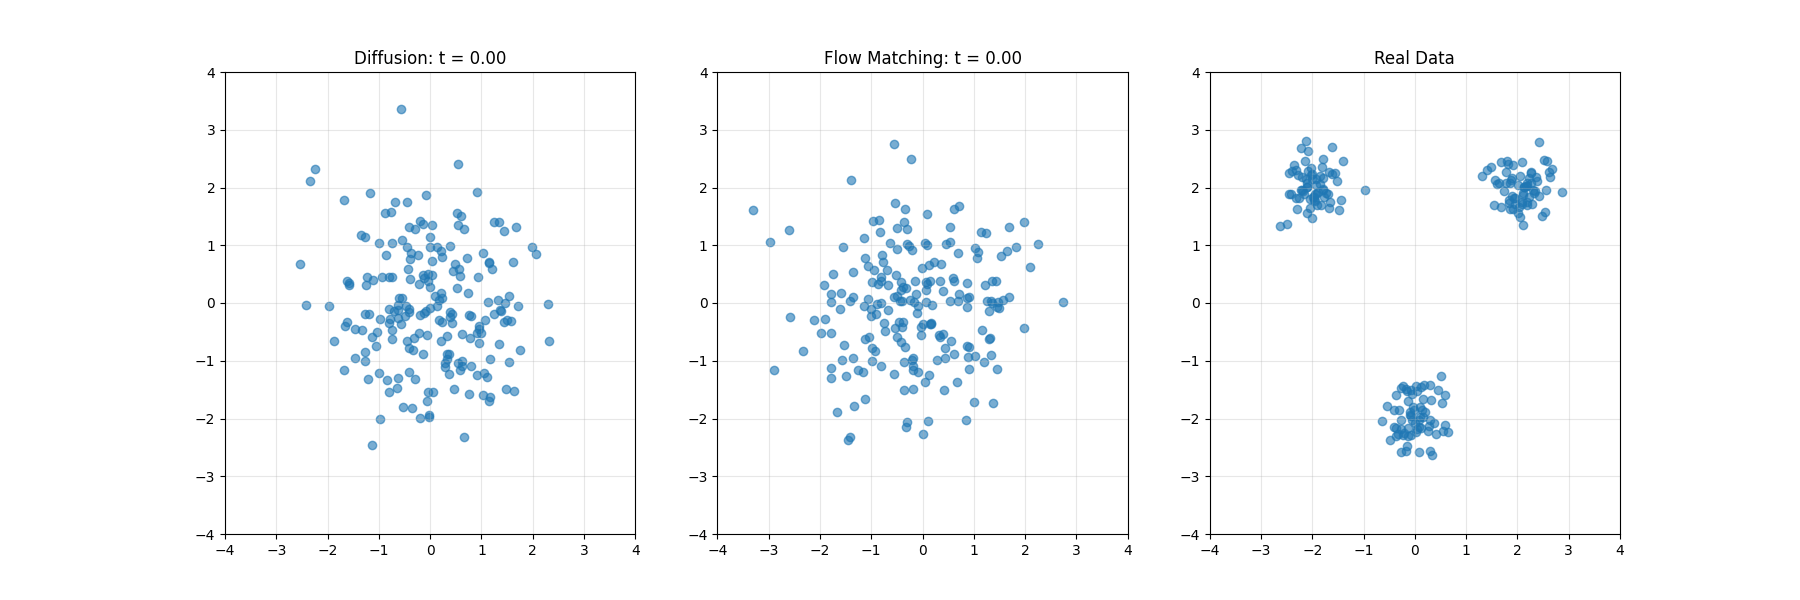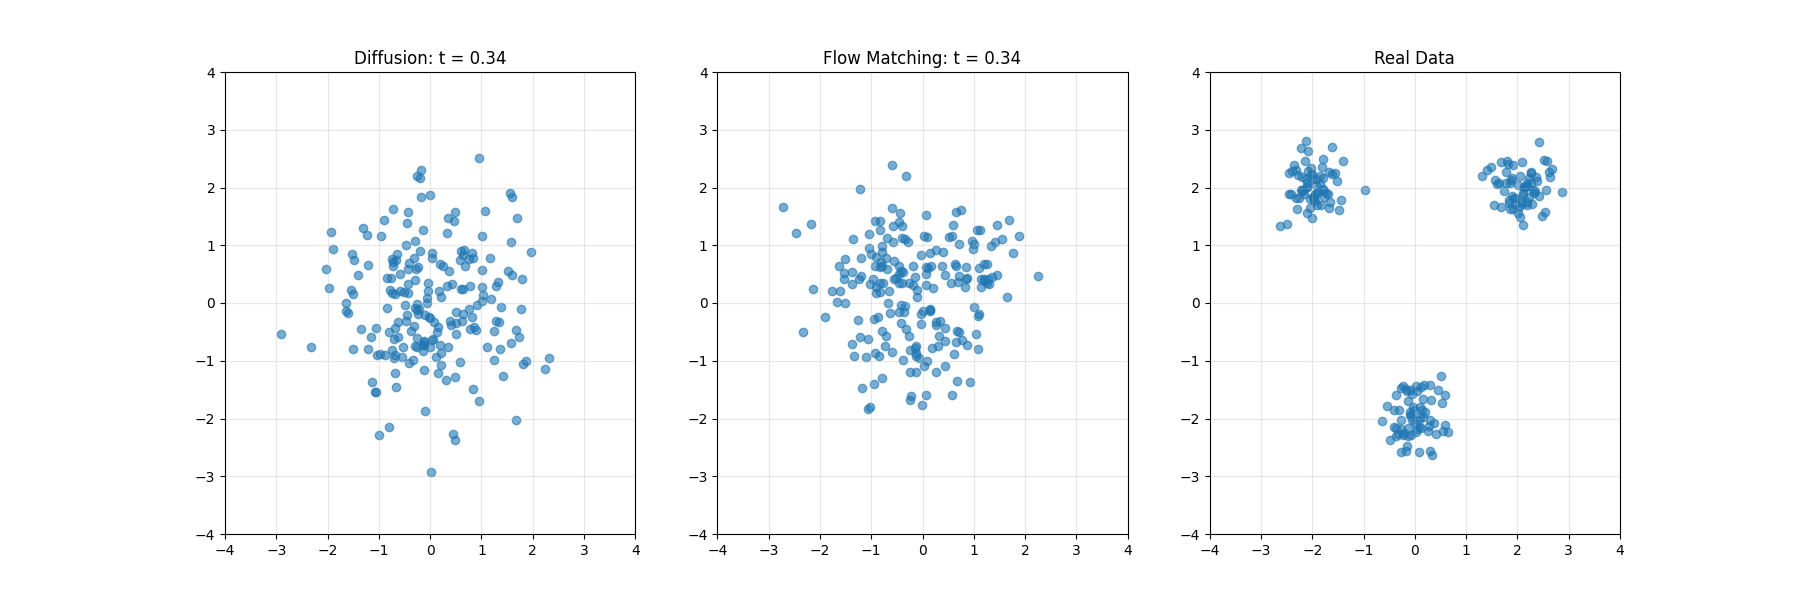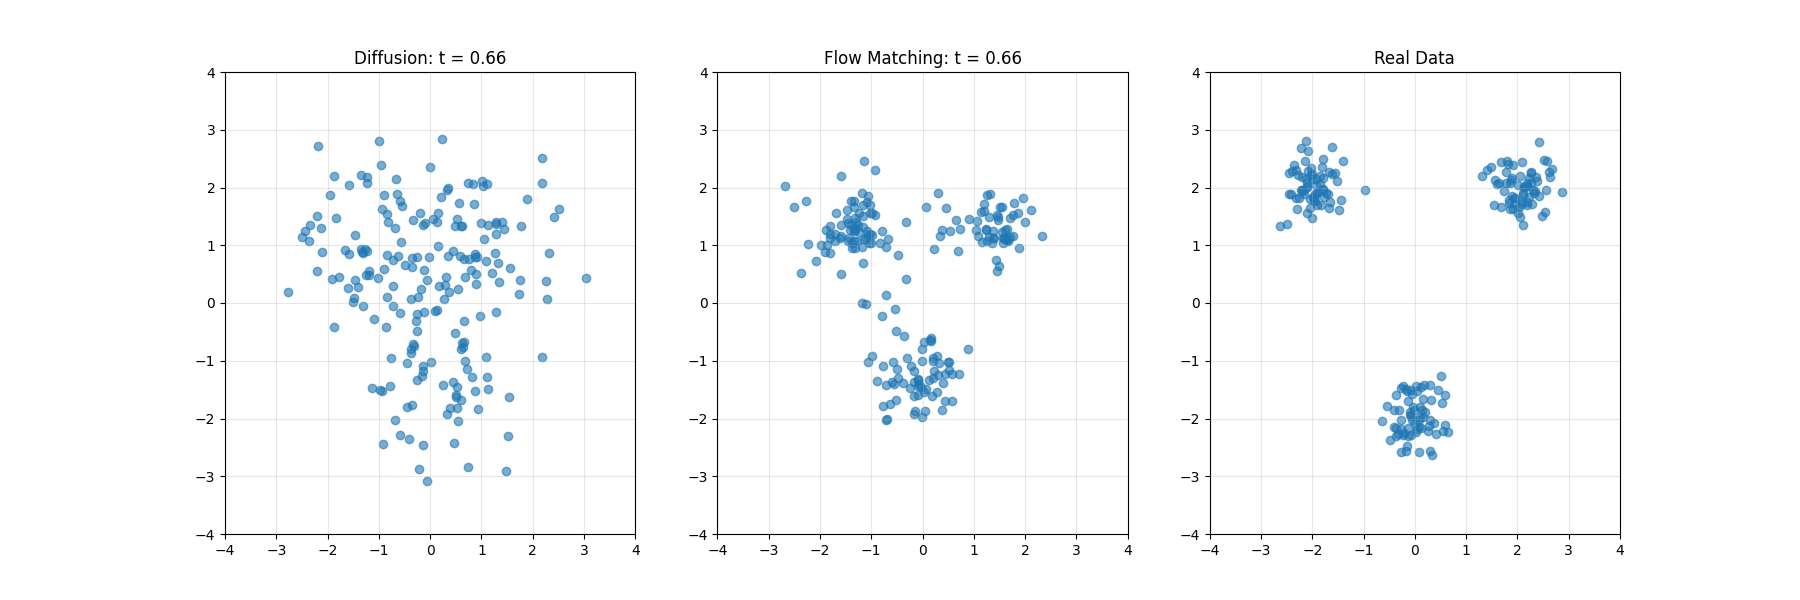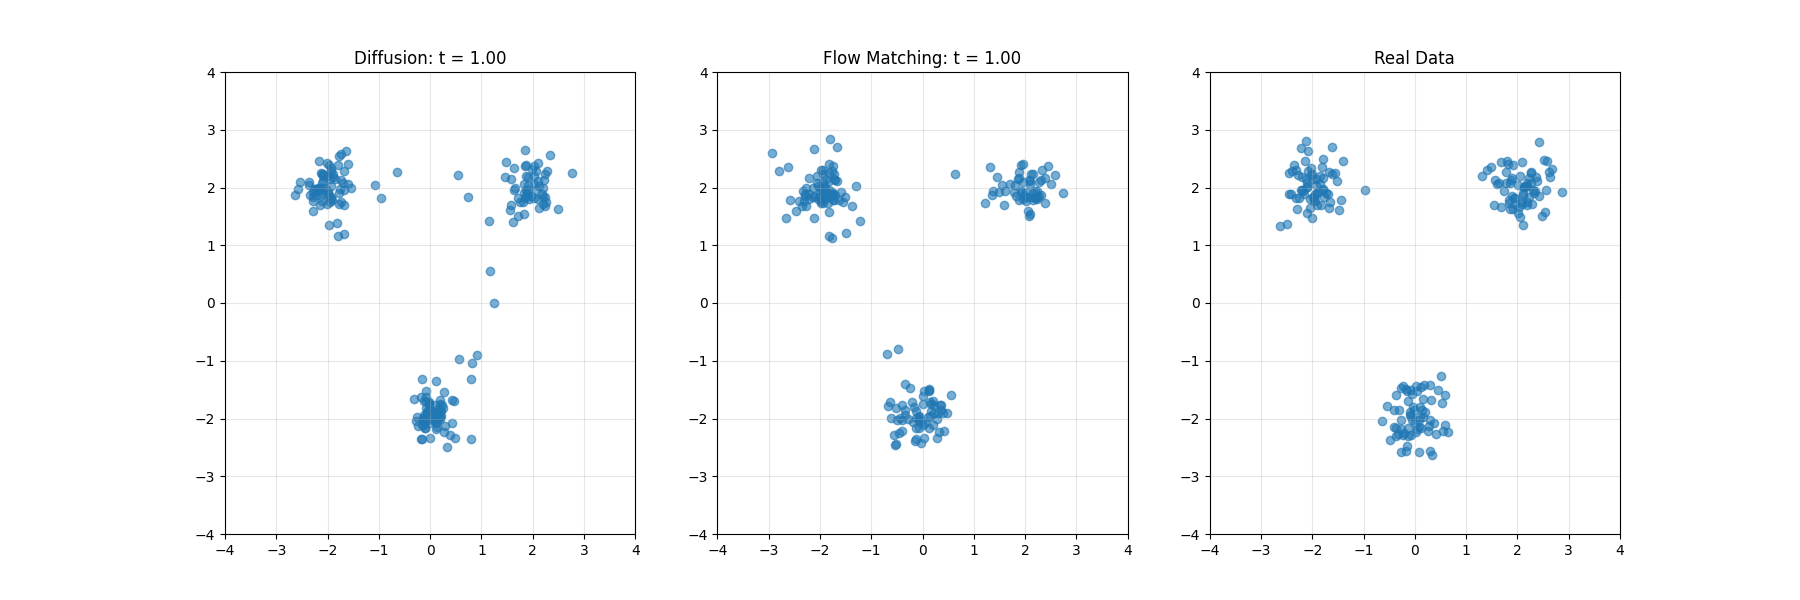
生成AI的两大范式:扩散模型与Flow Matching的理论基础与技术比较
本文系统对比了扩散模型与Flow Matching两种生成模型技术。扩散模型通过逐步添加噪声再逆转过程生成数据,类比为沙堡的侵蚀与重建;Flow Matching构建分布间连续路径的速度场,如同矢量导航系统。两者在数学原理、训练动态及应用上各有优劣:扩散模型适合复杂数据,Flow Matching采样效率更高。文章结合实例解析两者的差异与联系,并探讨其在图像、音频等领域的实际应用,为生成建模提供了全面视角。
3940 1
生成AI的两大范式:扩散模型与Flow Matching的理论基础与技术比较
|
10月前
|
机器学习/深度学习
位置编码详解
位置编码为Transformer提供序列位置信息,弥补注意力机制无位置感知的缺陷。主要分绝对(如可学习、Sinusoidal)和相对(如RoPE、ALiBi)两类。RoPE通过旋转矩阵支持长序列,ALiBi以线性偏置增强外推能力。不同方法在长度外推、效率上各有优劣,广泛应用于LLaMA、BLOOM等大模型,是面试考察重点。
|
10月前
|
机器学习/深度学习 缓存 关系型数据库
🎯 注意力机制详解
注意力机制是Transformer核心,实现动态信息聚焦。涵盖自注意力、交叉注意力及多头、分组、多查询等变体,平衡效率与性能。广泛应用于编码器-解码器、多模态融合等场景,是大模型设计与面试考察重点。
|
机器学习/深度学习 存储 人工智能
【科普向】我们所说的AI模型训练到底在训练什么?
人工智能(AI)模型训练类似于厨师通过反复实践来掌握烹饪技巧。它通过大量数据输入,自动优化内部参数(如神经网络中的权重和偏置),以最小化预测误差或损失函数,使模型在面对新数据时更加准确。训练过程包括前向传播、计算损失、反向传播和更新权重等步骤,最终生成权重文件保存模型参数,用于后续的应用和部署。理解生物神经网络的工作原理为人工神经网络的设计提供了灵感,后者广泛应用于图像识别、自然语言处理等领域。

热门文章

最新文章