高质量人体检测与行人识别数据集-千张标注图片全解析已标注(目标检测任务数据集)
在计算机视觉和人工智能的发展浪潮中,人体检测与行人识别 是一个极具应用价值和研究意义的方向。从智能监控到自动驾驶,从智慧城市到公共安全,人体检测数据集的质量与规模往往直接决定了算法模型的性能。本文将围绕一个包含 上千张图片、已完成划分与标注 的 人体检测、行人识别数据集 展开介绍,帮助研究者和开发者快速了解该数据集的特点、优势及其适用场景。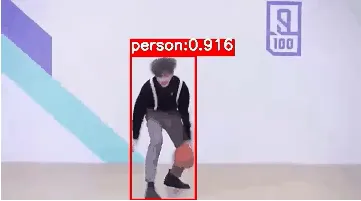
背景
随着深度学习技术的不断演进,计算机视觉在现实生活中的应用变得越来越广泛。在这一过程中,行人识别 成为一个不可忽视的研究课题。
智能安防领域
在城市安防监控系统中,行人识别可以帮助实现目标追踪、异常行为检测、人员流动分析,从而辅助公安部门进行快速反应与风险防控。自动驾驶场景
对于自动驾驶系统而言,准确地识别和预测行人行为是确保车辆安全行驶的关键。一个高质量的人体检测数据集,可以为训练鲁棒性更强的模型提供坚实的基础。人机交互与零售应用
在智能商店、无人零售终端中,行人检测与人体识别可用于客流统计、热力图绘制、用户行为偏好分析,从而优化服务体验。
然而,想要让模型在复杂环境中表现出高精度与高鲁棒性,离不开高质量的数据集。一个涵盖多场景、多姿态、多光照条件的数据集,往往能够帮助模型在真实应用中具备更强的泛化能力。
数据集概述
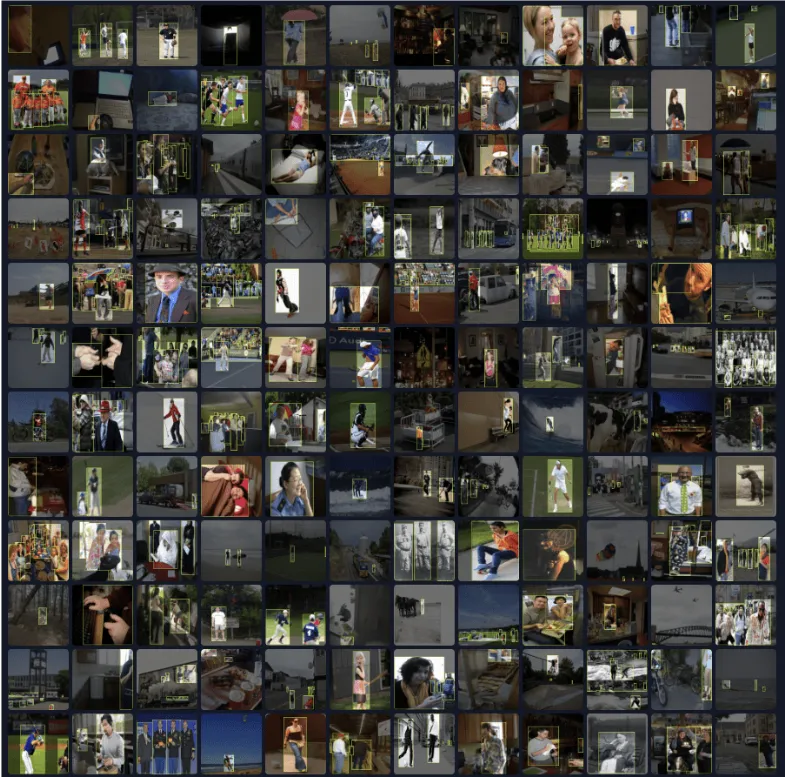
本数据集是一套 专门面向人体检测和行人识别任务 的视觉数据资源,具有以下特点:
- 图像数量:上千张高质量图片,满足深度学习模型的训练需求。
- 任务定位:专注于 人体检测 与 行人识别,覆盖多种姿态与场景。
- 标注信息:已完成高精度标注,采用 YOLO / VOC / COCO 格式(可兼容主流目标检测框架)。
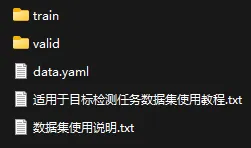
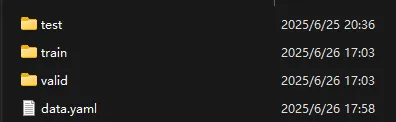
- 数据划分:已按照 训练集(train)、验证集(valid) 合理分配,比例约为 5:1,保证了训练的充分性与测试的公正性。
数据标注类别
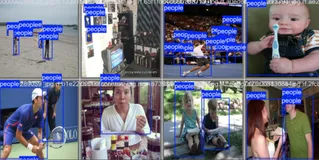
数据集的类别主要集中在 单一类别「行人/人体」,确保研究者能够快速将该数据集应用到行人检测、姿态识别等下游任务中。同时,也为后续的迁移学习或多类别扩展留出了接口。
数据集详情
为了让研究者能够更直观地了解数据集的组成,下面将从 数量、格式、标注质量、图像来源 等几个方面展开。
1. 数据数量与划分
- 训练集(train):约 80% 的样本,用于深度神经网络的拟合与学习。
- 验证集(valid):约 20% 的样本,用于模型在训练过程中的性能评估。
- 总量:超过 1000 张图片,足以支撑小型项目与学术研究的实验需求。
2. 标注格式
本数据集提供了主流的标注文件,常见的格式包括:
- YOLO格式:每张图对应一个
.txt文件,标注内容为[class, x_center, y_center, width, height],数值均为归一化坐标。 - VOC格式:采用 XML 文件标注,兼容 Pascal VOC 框架。
- COCO格式:采用 JSON 格式,支持更复杂的任务与批量标注管理。
这种多格式支持的设计,极大地方便了研究人员快速适配不同的深度学习框架(如 YOLOv8、Detectron2、MMDetection 等)。
3. 标注质量
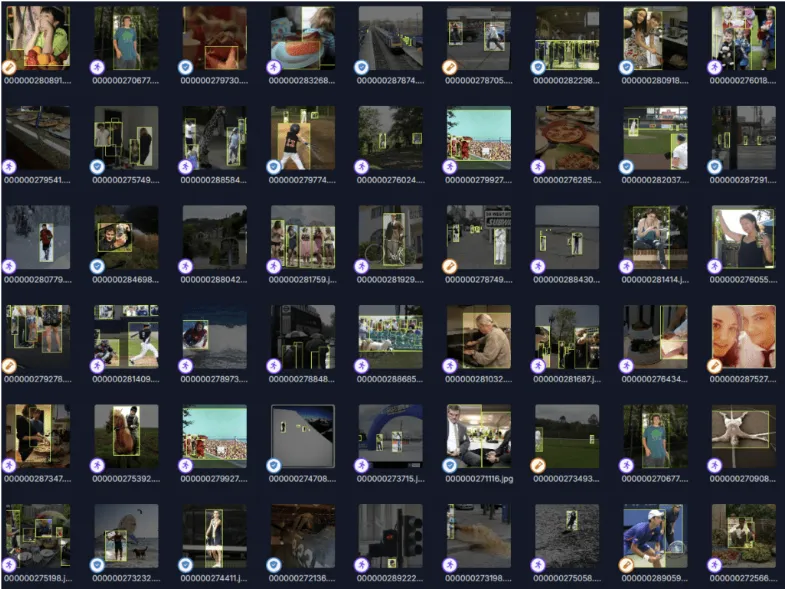
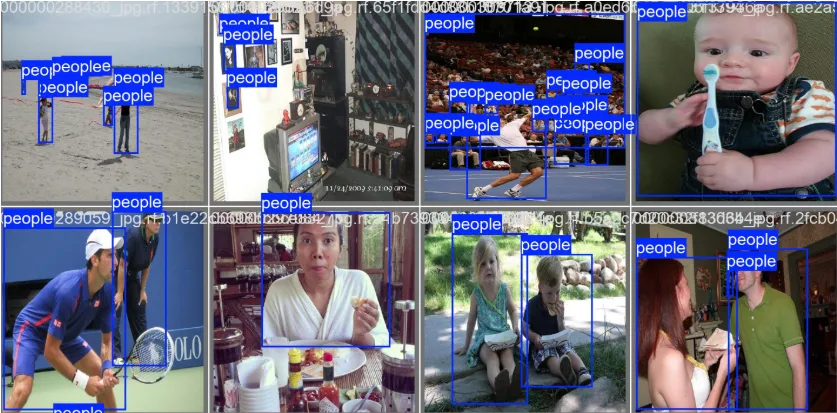
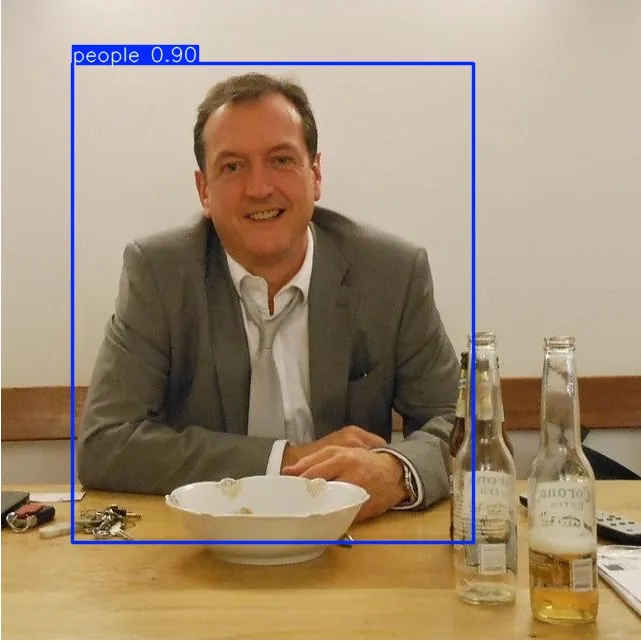
- 所有图片均由人工进行精细化标注,确保边界框(bounding box)能够紧密贴合人体轮廓。
- 针对复杂场景中的遮挡、行人重叠问题,标注人员采用 多实例框定 的方式,尽可能提高数据集的准确性。
- 标注审核流程包含两轮人工检查,减少了误标、漏标的情况。
4. 图像来源与多样性
数据集的图片涵盖了多种环境:
- 室内场景:商场、写字楼、地铁站等。
- 室外场景:街道、校园、车站广场。
- 光照条件:白天、夜晚、逆光、弱光环境。
- 行人姿态:走路、站立、坐下、转身、部分遮挡。
这种多样性为模型训练提供了更多的真实世界鲁棒性,避免了模型在单一场景下过拟合。
适用场景
该数据集适用于多个研究与应用方向,以下列举几个典型场景:
1. 智能安防
通过在监控视频中部署基于该数据集训练的行人检测模型,可以实现:
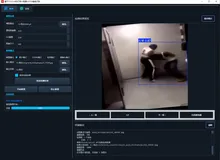
- 实时行人检测
- 入侵区域报警
- 异常行为监控(如跌倒检测、奔跑检测)
2. 自动驾驶
行人检测是自动驾驶中最为关键的任务之一。该数据集可用于训练:
- 前视摄像头中的行人检测模型
- 夜间/低光行人检测模型
- 多目标跟踪(MOT)系统
3. 智慧零售与客流分析
在商超或展馆场景中,基于该数据集训练的模型能够:
- 实时统计客流数量
- 分析顾客行为模式
- 提供数据支持以优化场地布局与人流管理
4. 学术研究与教学
该数据集非常适合作为 教学案例 或 科研论文实验数据,可用于:
- 行人检测算法对比实验
- 小样本学习与迁移学习研究
- 深度神经网络优化实验
结语
综上所述,这份 人体检测、行人识别数据集 不仅具备 数量适中、标注精准、划分合理、场景多样 等优势,还能够为多个研究方向和实际应用提供支持。无论是学术研究、项目开发,还是模型原型设计,该数据集都能够成为一个理想的起点。
在人工智能逐步深入各行各业的今天,高质量数据集的重要性不言而喻。正如一句话所说:“数据是人工智能的燃料,优质数据决定了模型的上限。”
对于开发者来说,掌握并善用这样的数据集,不仅能加速实验进度,更能推动算法在真实场景中的落地应用。未来,随着数据规模和多样性的不断扩大,我们有理由相信,行人检测与人体识别技术将会在 智慧城市、交通安全、公共服务 等领域发挥更为关键的作用。
数据集下载
链接:https://pan.baidu.com/s/1KzALixlMKDDCGLRv0Zu8Eg?pwd=x7nm
提取码:x7nm 复制这段内容后打开百度网盘手机App,操作更方便哦