多智能体强化学习(Multi-Agent Reinforcement Learning, MARL)是强化学习的一个重要分支,专注于训练多个智能体在复杂环境中协同工作或竞争。与单智能体强化学习不同,多智能体强化学习需要考虑智能体之间的交互和协作,这使得问题更加复杂和具有挑战性。DeepSeek提供了强大的工具和API,帮助我们高效地构建和训练多智能体强化学习模型。本文将详细介绍如何使用DeepSeek进行多智能体强化学习,并通过代码示例帮助你掌握这些技巧。
1. 多智能体强化学习的基本概念
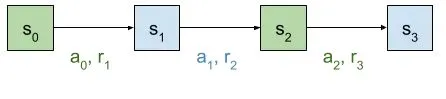
多智能体强化学习的核心概念包括:
- 智能体(Agents):多个学习和决策的主体。
- 环境(Environment):智能体交互的外部世界。
- 状态(State):环境在某一时刻的描述。
- 动作(Action):每个智能体在某一状态下采取的行为。
- 奖励(Reward):每个智能体采取动作后获得的反馈。
- 策略(Policy):每个智能体在某一状态下选择动作的规则。
多智能体强化学习的目标是通过最大化每个智能体的累积奖励,找到最优策略。接下来,我们将通过代码示例详细讲解如何使用DeepSeek构建和训练多智能体强化学习模型。
2. 构建多智能体环境
在DeepSeek中,我们可以使用gym库来构建多智能体强化学习环境。以下是一个使用gym构建多智能体环境的示例:
import gym
import numpy as np

# 创建多智能体环境
env = gym.make("ma_gym:Switch2-v0")

# 初始化环境
state = env.reset()

# 与环境交互
for _ in range(1000):
    env.render()
    actions = [env.action_space.sample() for _ in range(env.n_agents)]  # 随机选择动作
    next_state, rewards, done, info = env.step(actions)
    if done:
        break

# 关闭环境
env.close()
在这个示例中,我们使用gym创建了一个多智能体环境Switch2-v0,并随机选择动作与环境交互。
3. 定义多智能体
在多智能体强化学习中,每个智能体都有自己的策略和学习算法。我们可以使用DeepSeek构建多个Q学习智能体。以下是一个多Q学习智能体的定义示例:
import numpy as np
import deepseek as ds

# 定义Q学习智能体
class QLearningAgent:
    def __init__(self, state_size, action_size, learning_rate=0.1, discount_factor=0.99, epsilon=1.0, epsilon_decay=0.995, epsilon_min=0.01):
        self.state_size = state_size
        self.action_size = action_size
        self.learning_rate = learning_rate
        self.discount_factor = discount_factor
        self.epsilon = epsilon
        self.epsilon_decay = epsilon_decay
        self.epsilon_min = epsilon_min
        self.q_table = np.zeros((state_size, action_size))

    def choose_action(self, state):
        if np.random.rand() <= self.epsilon:
            return np.random.choice(self.action_size)
        return np.argmax(self.q_table[state, :])

    def learn(self, state, action, reward, next_state, done):
        target = reward + self.discount_factor * np.max(self.q_table[next_state, :])
        self.q_table[state, action] += self.learning_rate * (target - self.q_table[state, action])
        if done:
            self.epsilon = max(self.epsilon_min, self.epsilon * self.epsilon_decay)
在这个示例中,我们定义了一个Q学习智能体,使用Q表来存储状态-动作值,并通过ε-greedy策略选择动作。
4. 训练多智能体
在定义了多个智能体之后,我们可以通过与环境交互来训练智能体。以下是一个训练多Q学习智能体的示例:
# 初始化环境
env = gym.make("ma_gym:Switch2-v0")
state_size = env.observation_space.shape[0]
action_size = env.action_space.n

# 初始化智能体
agents = [QLearningAgent(state_size, action_size) for _ in range(env.n_agents)]

# 训练参数
episodes = 1000

# 训练循环
for episode in range(episodes):
    state = env.reset()
    state = np.argmax(state)  # 离散化状态
    total_rewards = [0] * env.n_agents

    while True:
        actions = [agent.choose_action(state) for agent in agents]
        next_state, rewards, done, info = env.step(actions)
        next_state = np.argmax(next_state)  # 离散化状态
        for i, agent in enumerate(agents):
            agent.learn(state, actions[i], rewards[i], next_state, done)
        state = next_state
        total_rewards = [total_rewards[i] + rewards[i] for i in range(env.n_agents)]

        if done:
            break

    print(f"Episode: {episode}, Total Rewards: {total_rewards}")

# 关闭环境
env.close()
在这个示例中,我们通过与环境交互训练了多个Q学习智能体,并记录了每个回合的总奖励。
5. 使用深度Q网络(DQN)进行多智能体强化学习
对于更复杂的环境,Q学习可能无法处理高维状态空间。我们可以使用深度Q网络(DQN)来解决这个问题。以下是一个使用DeepSeek构建多DQN智能体的示例:
from deepseek.layers import Dense
from deepseek.models import Sequential
from deepseek.optimizers import Adam

# 定义DQN模型
def build_dqn(state_size, action_size):
    model = Sequential([
        Dense(24, activation='relu', input_shape=(state_size,)),
        Dense(24, activation='relu'),
        Dense(action_size, activation='linear')
    ])
    model.compile(optimizer=Adam(learning_rate=0.001), loss='mse')
    return model

# 初始化DQN智能体
class DQNAgent:
    def __init__(self, state_size, action_size):
        self.state_size = state_size
        self.action_size = action_size
        self.model = build_dqn(state_size, action_size)

    def choose_action(self, state):
        if np.random.rand() <= self.epsilon:
            return np.random.choice(self.action_size)
        q_values = self.model.predict(state[np.newaxis, :])
        return np.argmax(q_values[0])

    def learn(self, state, action, reward, next_state, done):
        target = reward + self.discount_factor * np.max(self.model.predict(next_state[np.newaxis, :]))
        target_f = self.model.predict(state[np.newaxis, :])
        target_f[0][action] = target
        self.model.fit(state[np.newaxis, :], target_f, verbose=0)
在这个示例中,我们使用深度神经网络代替Q表来估计状态-动作值。
6. 训练多DQN智能体
在定义了多个DQN智能体之后,我们可以通过与环境交互来训练智能体。以下是一个训练多DQN智能体的示例:
# 初始化环境
env = gym.make("ma_gym:Switch2-v0")
state_size = env.observation_space.shape[0]
action_size = env.action_space.n

# 初始化DQN智能体
agents = [DQNAgent(state_size, action_size) for _ in range(env.n_agents)]

# 训练参数
episodes = 1000

# 训练循环
for episode in range(episodes):
    state = env.reset()
    total_rewards = [0] * env.n_agents

    while True:
        actions = [agent.choose_action(state) for agent in agents]
        next_state, rewards, done, info = env.step(actions)
        for i, agent in enumerate(agents):
            agent.learn(state, actions[i], rewards[i], next_state, done)
        state = next_state
        total_rewards = [total_rewards[i] + rewards[i] for i in range(env.n_agents)]

        if done:
            break

    print(f"Episode: {episode}, Total Rewards: {total_rewards}")

# 关闭环境
env.close()
在这个示例中,我们通过与环境交互训练了多个DQN智能体,并记录了每个回合的总奖励。
7. 常见问题与解决方案
- 问题1:智能体无法学习到有效策略。
- 解决方案:调整学习率、折扣因子或探索率(ε)。
- 问题2:训练过程不稳定。
- 解决方案:使用经验回放(Experience Replay)和目标网络(Target Network)技术。
- 问题3:训练速度慢。
- 解决方案:使用硬件加速(如GPU)或分布式训练。
8. 总结
本文详细介绍了如何使用DeepSeek进行多智能体强化学习。我们从构建多智能体环境、定义多智能体、训练多Q学习智能体到使用深度Q网络(DQN),全面覆盖了多智能体强化学习的各个环节。通过本文的学习,你应该已经掌握了如何利用DeepSeek构建和训练多智能体强化学习模型,并在复杂环境中协同工作或竞争。