前言
本文是在学习Transformer过程中记录的笔记,可能有一些理解不到位的错误。望指正。

在 Transformer 模型中,Encoder 部分由多个相同的 Encoder Layer 堆叠而成,每个 Encoder Layer 包含两个主要子层,分别是 Multi-Head Self-Attention (多头自注意力机制) 和 Position-wise Feed-Forward Network(前馈网络)。
Multi-Head Self-Attention由 Scaled Dot-product Attention 和 Multi-Head Attention 以及 Self Attention 和 Add & Norm 组成。
(1)多头自注意力层处理
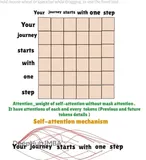
每个 Encoder 子模块在接收到输入后,首先会将其传递到多头自注意力层(Multi-Head Self-Attention layer)。在这一层中,通过多头自注意力机制(如前面所述,查询、键、值都来自同一个输入序列自身)去计算输入序列不同位置之间的关联关系,生成相应的自注意力输出。
(2)前馈层处理
自注意力层的输出紧接着被传递到前馈层(Feedforward layer)。前馈层一般是由全连接网络等构成,对自注意力层输出的特征做进一步的非线性变换,提取更复杂、高层次的特征,然后将其输出向上发送到下一个编码器(如果不是最后一个 Encoder 的话),以便后续 Encoder 子模块继续进行处理。
下图是一层Encoder Layer 的图解。
- Multi-Head Attention (多头注意力机制)
- Residual connection (残差连接)
- Normalisation (层归一化)
- Position-wise Feed-Forward Networks(前馈网络)
Residual connection (残差连接)
"残差" 的字面意思是 "剩余的差异" 或 "误差"。 在神经网络中,残差 指的是 期望输出与模型实际输出之间的差异。 但在 残差连接 的语境下,"残差" 的含义略有不同,更侧重于 "输入与输出的差异部分" 或者说 "模型学习到的输入之外的 额外信息"。
数学定义:假设我们有一个神经网络层,输入是 x,输出是 F(x)(F(x) 表示对 x 进行某种变换,例如自注意力计算或前馈网络计算)。
- 没有残差连接: 输出就是 F(x)。
- 有残差连接: 输出是 x + F(x)。 这里,F(x) 就是 残差,它表示网络层学习到的 相对于输入的变化。
过程:
1. 输入: 将网络层(例如,自注意力层或前馈网络层)的输入 x 复制一份。
2. 变换: 对输入 x 进行正常的变换,得到 F(x)。
3. 相加: 将 F(x) 与 原始输入 x 相加,得到最终输出:x + F(x)。
简而言之,残差连接就是在网络层的输出上加上它的输入。
总结
残差连接 将子层的输出添加到其输入上,这样可以形成一个短路,允许梯度直接流过网络层,有助于缓解深层网络中的梯度消失问题。
数学上,残差连接可以表示为: $$Residual=x+SubLayer(x)$$ 其中 x 是子层的输入 $SubLayer(x)$ 是子层的输出。
Normalisation (层归一化)
- 输入 (X + Sublayer_output): 层归一化的输入是 残差连接后的结果 $X + Sublayer_output$。
- 计算均值和方差 (Mean and Variance): 对于 每个样本 (在 Transformer 中,可以理解为序列中的每个 token 位置),计算其 所有特征维度 的均值 (mean) 和方差 (variance)。 注意: 层归一化是 对每个样本 内部 的特征维度进行归一化,而不是像 Batch Normalization 那样对整个 batch 的样本进行归一化。
- 归一化 (Normalization): 使用计算出的均值和方差,对每个样本的特征进行 标准化,使其均值为 0,方差为 1。
缩放和偏移 (Scale and Shift - 可选): 为了增加灵活性,层归一化通常还会引入两个 可学习的参数: 缩放系数 γ (gamma) 和 偏移量 β (beta)。 归一化后的结果会再经过 缩放和偏移 操作: y = γ * normalized_x + β。 模型可以学习到最佳的缩放和偏移参数。
层归一化可以 稳定神经网络的训练过程。 它可以 减少 Internal Covariate Shift (内部协变量偏移) 现象,即网络层输入分布在训练过程中不断变化的问题。 稳定的输入分布有助于网络更快、更稳定地学习。
将这两个操作结合在一起,“Add & Norm” 的步骤如下:
- 计算子层的输出: $SubLayer(x)$
- 执行残差连接:$Residual=x+SubLayer(x)$
- 应用层归一化: $Output=LayerNorm(Residual)$
所以,“Add & Norm” 的整个过程可以表示为: $Output=LayerNorm(x+SubLayer(x))$
多头注意力
Q,K,V 叫法的起源 Q、K 和 V 分别代表 Query(查询)、Key(键)和 Value(值)。这些术语的来源和它们在注意力机制中的角色都与数据库的查询概念有相似之处。
在注意力机制中:
- Query (Q): 它代表了正在询问的信息或关心的上下文。在自注意力机制中,每个序列元素都有一个对应的查询,它试图从其他部分找到相关信息。
- Key (K): 这些是可以查询的条目或“索引”。在自注意力机制中,每个序列元素都有一个对应的键。
- Value (V): 对于每一个“键”,都有一个与之关联的“值”,它代表实际的信息内容。当查询匹配到一个特定的键时,其对应的值就会被选中并返回。
这种思路与数据库查询非常相似,可以将 Query 看作是搜索查询,Key 看作是数据库索引,而 Value 则是实际的数据库条目。
在 "Attention Is All You Need" 这篇 Transformer 论文中,这些术语首次被广泛地采纳和使用。注意力机制的核心思想是:对于给定的 Query,计算其与所有 Keys 的相似度,然后用这些相似度对 Values 进行加权求和,得到最终的输出。
多头(Multi-Head) 的方式是将多个 head 的输出 z,进行拼接(concat)后,通过线性变换得到最后的输出 z。

缩放点积注意力(Scaled Dot-Product Attention)

也就是说,Q、K、V 都是对输入 x 的线性映射:
- query = linear_q(x)
- key = linear_k(x)
- value = linear_v(x)
注意:这里的 linear_q(x),linear_k(x),linear_v(x) 相互独立,通过 softmax 函数对 Query(Q)和 Key(K)向量缩放点积的分数进行归一化,得到权重系数(attention weights),值都介于0到1之间。按照公式: $$Attention(Q,K,V)=softmax(\frac{QK^T}{\sqrt{d_k}})V$$ 使用权重系数对$Value(V)$向量进行加权求和,得到最终的注意力输出 $Attention(Q, K, V)$。

其中,$\sqrt{d_k}$ 为缩放因子。这个缩放因子可以防止内积过大,防止它经过 softmax 后落入饱和区间,因为饱和区的梯度几乎为0,容易发生梯度消失。
在多头注意力机制中,参数 $dk$ (每个头的维度)通常是由总的模型维度 $d{model}$ 和多头注意力的头数 (h) 决定的。具体来说,$d_k$ 通常是这样计算的:
$$d_k=\frac{d_{\mathrm{model}}}h$$
总结

参考资料
https://www.datawhale.cn/learn/summary/87
https://www.researchgate.net/publication/355061779_Lightweight_Transformer_in_Federated_Setting_for_Human_Activity_Recognition?_tp=eyJjb250ZXh0Ijp7ImZpcnN0UGFnZSI6Il9kaXJlY3QiLCJwYWdlIjoiX2RpcmVjdCJ9fQ
https://github.com/xmu-xiaoma666/External-Attention-pytorch