【02】仿站技术之python技术,看完学会再也不用去购买收费工具了-本次找了小影-感觉页面很好看-本次是爬取vue需要用到Puppeteer库用node.js扒一个app下载落地页-包括安卓android下载(简单)-ios苹果plist下载(稍微麻烦一丢丢)-优雅草卓伊凡
开发背景
本次看到了小影很好看,但是目前看了稍微有些知名的平台都是vue,毕竟vue超过普通html+css性能太多了,vue的渲染机制决定的,请注意奥我们python开发的落地页修改下只是临时用,并且赠送给客户,python使用一定要注意合法合规!!
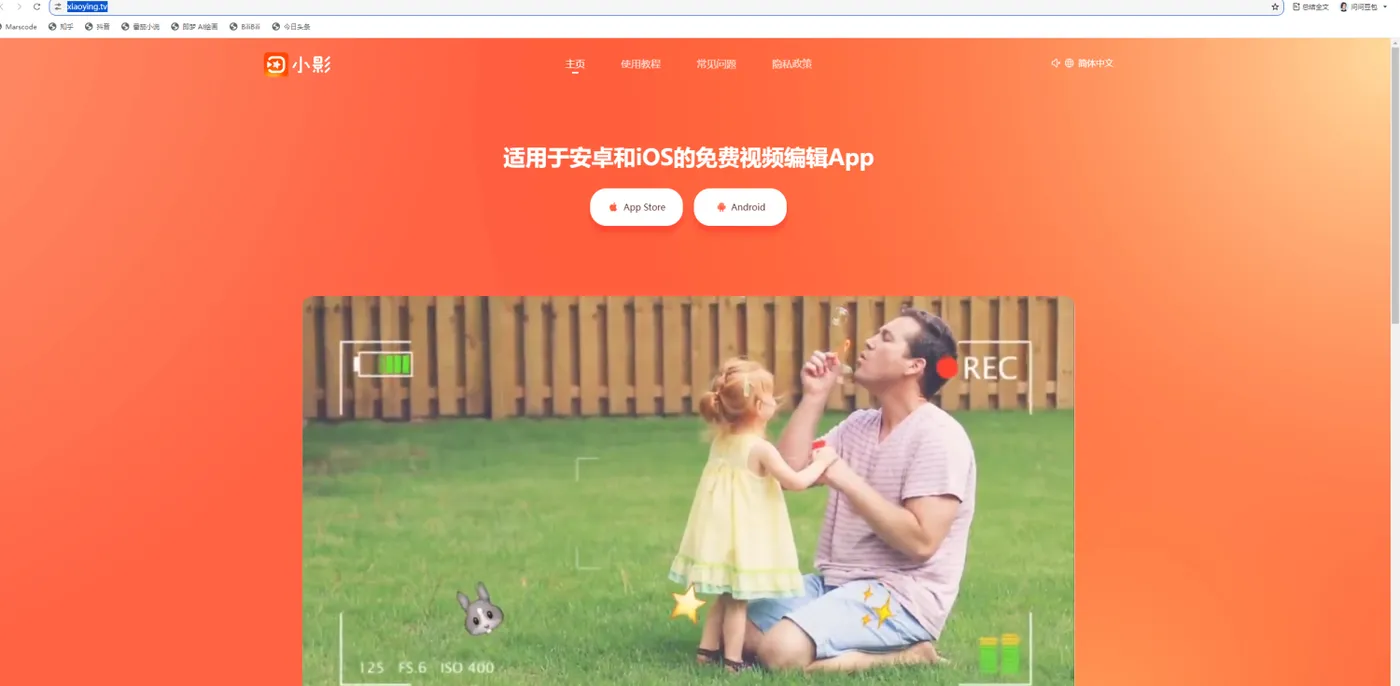
实战开发
目标网站是由 Vue.js 编译后生成的单页应用程序(SPA)时,爬取和保存网页内容的步骤会有所不同。Vue.js 和其他前端框架(如 React 和 Angular)生成的 SPA 通常依赖于动态加载的资源和客户端渲染。要完整保存这些网页的内容,通常需要执行以下步骤:
- 使用无头浏览器:为了正确处理客户端渲染和动态加载,建议使用无头浏览器(如 Puppeteer 或 Selenium)来模拟用户在浏览器中的操作。这些工具可以渲染页面并下载所有相关的静态资源。
- 保存页面内容:通过无头浏览器获取页面的 HTML、CSS、JS 文件和其他静态资源,并将其保存到本地。
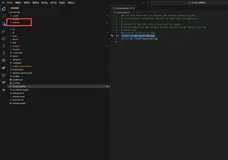
根据已知信息我们需要用到node.js,因此我们切换掉python,新建download.js
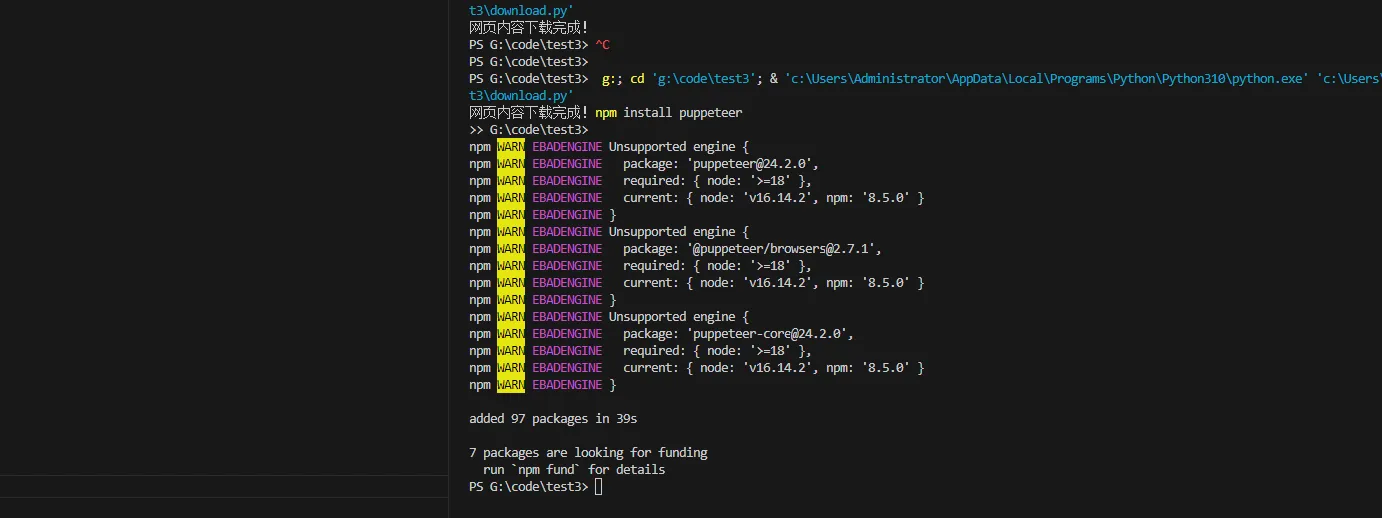
写入编写的js爬虫代码
const puppeteer = require('puppeteer');
const fs = require('fs');
const path = require('path');
const url = require('url');
// 目标URL
const targetUrl = 'https://www.xiaoying.tv/';
// 创建保存目录
const saveDirectory = 'xiaoying_tv';
const cssDirectory = path.join(saveDirectory, 'css');
const jsDirectory = path.join(saveDirectory, 'js');
const assetsDirectory = path.join(saveDirectory, 'assets');
if (!fs.existsSync(saveDirectory)) fs.mkdirSync(saveDirectory);
if (!fs.existsSync(cssDirectory)) fs.mkdirSync(cssDirectory);
if (!fs.existsSync(jsDirectory)) fs.mkdirSync(jsDirectory);
if (!fs.existsSync(assetsDirectory)) fs.mkdirSync(assetsDirectory);
(async () => {
    const browser = await puppeteer.launch();
    const page = await browser.newPage();
    await page.goto(targetUrl, { waitUntil: 'networkidle2' });
    // 保存HTML文件
    const html = await page.content();
    fs.writeFileSync(path.join(saveDirectory, 'index.html'), html, 'utf8');
    // 下载并保存CSS文件
    const cssLinks = await page.$$eval('link[rel="stylesheet"]', links => links.map(link => link.href));
    for (const link of cssLinks) {
        const response = await page.goto(link);
        const cssContent = await response.text();
        const cssFileName = path.basename(url.parse(link).pathname);
        fs.writeFileSync(path.join(cssDirectory, cssFileName), cssContent, 'utf8');
    }
    // 下载并保存JS文件
    const jsLinks = await page.$$eval('script[src]', scripts => scripts.map(script => script.src));
    for (const script of jsLinks) {
        const response = await page.goto(script);
        const jsContent = await response.text();
        const jsFileName = path.basename(url.parse(script).pathname);
        fs.writeFileSync(path.join(jsDirectory, jsFileName), jsContent, 'utf8');
    }
    // 下载并保存图片等静态文件
    const imgLinks = await page.$$eval('img[src]', imgs => imgs.map(img => img.src));
    for (const img of imgLinks) {
        const response = await page.goto(img);
        const imgBuffer = await response.buffer();
        const imgFileName = path.basename(url.parse(img).pathname);
        fs.writeFileSync(path.join(assetsDirectory, imgFileName), imgBuffer);
    }
    // 下载并保存其他静态文件(如视频、音频等)
    const staticLinks = await page.$$eval('a[href], video[src], audio[src]', elements => elements.map(el => el.href || el.src).filter(src => src));
    for (const link of staticLinks) {
        const response = await page.goto(link);
        const fileBuffer = await response.buffer();
        const fileName = path.basename(url.parse(link).pathname);
        const fileExtension = path.extname(fileName).toLowerCase();
        let filePath = '';
        if (['.png', '.jpg', '.jpeg', '.gif', '.svg', '.mp4', '.mp3'].includes(fileExtension)) {
            filePath = path.join(assetsDirectory, fileName);
        } else if (fileExtension === '.css') {
            filePath = path.join(cssDirectory, fileName);
        } else if (fileExtension === '.js') {
            filePath = path.join(jsDirectory, fileName);
        }
        fs.writeFileSync(filePath, fileBuffer);
    }
    await browser.close();
    console.log('网页内容下载完成!');
})();
完成后,我分了一下目录 ,此前python也是有用的,于是我这样
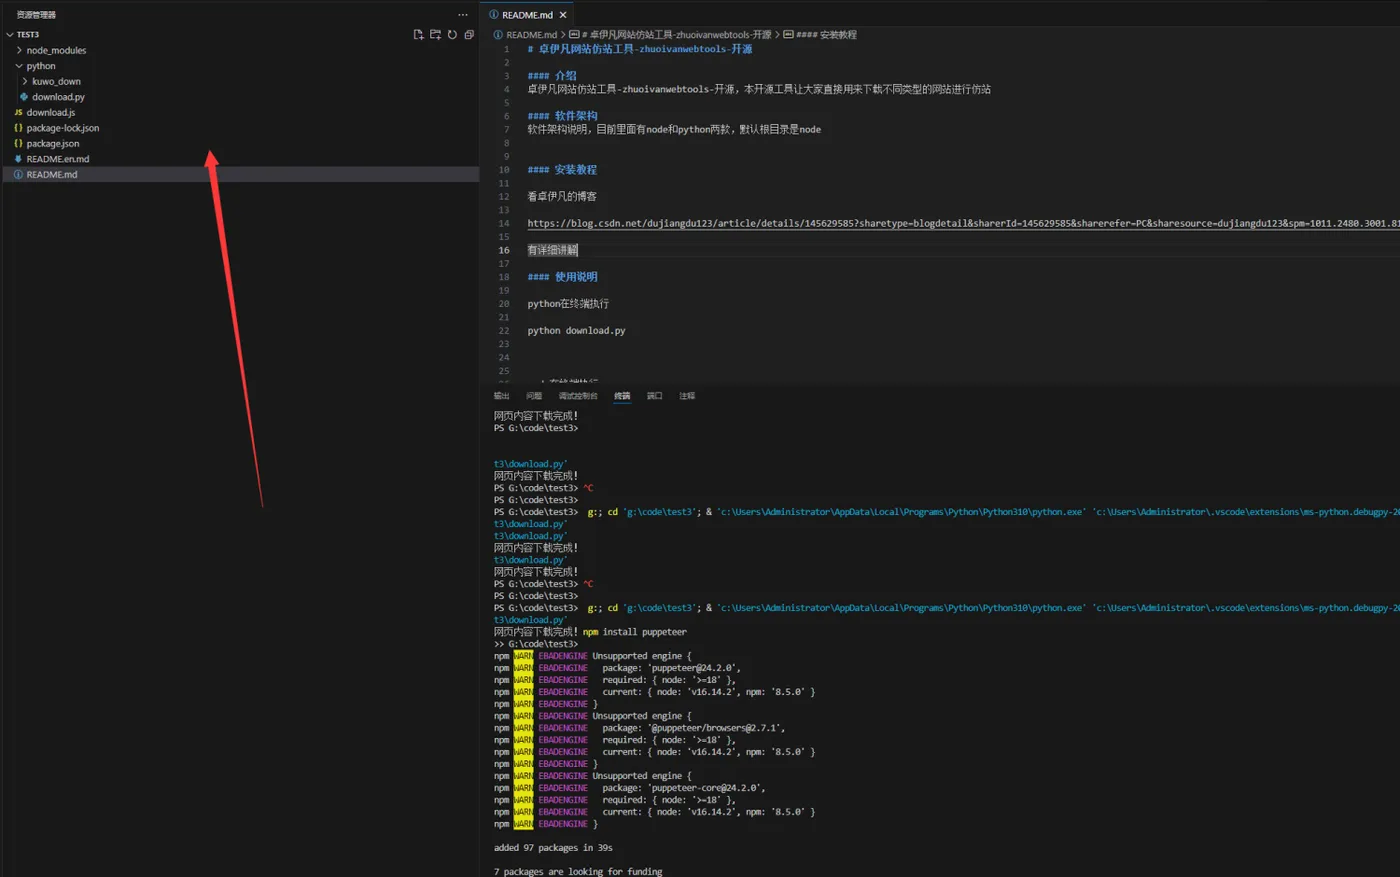
由于安装了node依赖因此我默认根目录是node,继续我们的爬取
思路
详细说明:
- 安装 Puppeteer:使用
npm安装 Puppeteer 库。 - 设置保存目录:创建保存 HTML、CSS、JS 文件和静态资源的目录。
- 使用 Puppeteer 模拟浏览器操作:
- 启动浏览器并导航到目标 URL。
- 保存 HTML 内容到本地文件。
- 查找并下载所有 CSS 文件,并保存到
/css目录。 - 查找并下载所有 JS 文件,并保存到
/js目录。 - 查找并下载所有图片等静态资源,并保存到
/assets目录。
实战
以下是使用 Puppeteer 爬取 Vue.js 编译后网站的示例代码:
步骤 1:安装 Puppeteer
首先,安装 Puppeteer 库。在终端中运行以下命令:
npm install puppeteer
步骤 2:编写爬虫脚本
使用 Puppeteer 模拟浏览器操作并下载页面内容。以下是详细的代码示例:
const puppeteer = require('puppeteer');
const fs = require('fs');
const path = require('path');
const url = require('url');
// 目标URL
const targetUrl = 'https://www.xiaoying.tv/';
// 创建保存目录
const saveDirectory = 'xiaoying_tv';
const cssDirectory = path.join(saveDirectory, 'css');
const jsDirectory = path.join(saveDirectory, 'js');
const assetsDirectory = path.join(saveDirectory, 'assets');
if (!fs.existsSync(saveDirectory)) fs.mkdirSync(saveDirectory);
if (!fs.existsSync(cssDirectory)) fs.mkdirSync(cssDirectory);
if (!fs.existsSync(jsDirectory)) fs.mkdirSync(jsDirectory);
if (!fs.existsSync(assetsDirectory)) fs.mkdirSync(assetsDirectory);
(async () => {
    const browser = await puppeteer.launch();
    const page = await browser.newPage();
    await page.goto(targetUrl, { waitUntil: 'networkidle2' });
    // 保存HTML文件
    const html = await page.content();
    fs.writeFileSync(path.join(saveDirectory, 'index.html'), html, 'utf8');
    // 下载并保存CSS文件
    const cssLinks = await page.$$eval('link[rel="stylesheet"]', links => links.map(link => link.href));
    for (const link of cssLinks) {
        const response = await page.goto(link);
        const cssContent = await response.text();
        const cssFileName = path.basename(url.parse(link).pathname);
        fs.writeFileSync(path.join(cssDirectory, cssFileName), cssContent, 'utf8');
    }
    // 下载并保存JS文件
    const jsLinks = await page.$$eval('script[src]', scripts => scripts.map(script => script.src));
    for (const script of jsLinks) {
        const response = await page.goto(script);
        const jsContent = await response.text();
        const jsFileName = path.basename(url.parse(script).pathname);
        fs.writeFileSync(path.join(jsDirectory, jsFileName), jsContent, 'utf8');
    }
    // 下载并保存图片等静态文件
    const imgLinks = await page.$$eval('img[src]', imgs => imgs.map(img => img.src));
    for (const img of imgLinks) {
        const response = await page.goto(img);
        const imgBuffer = await response.buffer();
        const imgFileName = path.basename(url.parse(img).pathname);
        fs.writeFileSync(path.join(assetsDirectory, imgFileName), imgBuffer);
    }
    // 下载并保存其他静态文件(如视频、音频等)
    const staticLinks = await page.$$eval('a[href], video[src], audio[src]', elements => elements.map(el => el.href || el.src).filter(src => src));
    for (const link of staticLinks) {
        const response = await page.goto(link);
        const fileBuffer = await response.buffer();
        const fileName = path.basename(url.parse(link).pathname);
        const fileExtension = path.extname(fileName).toLowerCase();
        let filePath = '';
        if (['.png', '.jpg', '.jpeg', '.gif', '.svg', '.mp4', '.mp3'].includes(fileExtension)) {
            filePath = path.join(assetsDirectory, fileName);
        } else if (fileExtension === '.css') {
            filePath = path.join(cssDirectory, fileName);
        } else if (fileExtension === '.js') {
            filePath = path.join(jsDirectory, fileName);
        }
        fs.writeFileSync(filePath, fileBuffer);
    }
    await browser.close();
    console.log('网页内容下载完成!');
})();
执行
node download.js
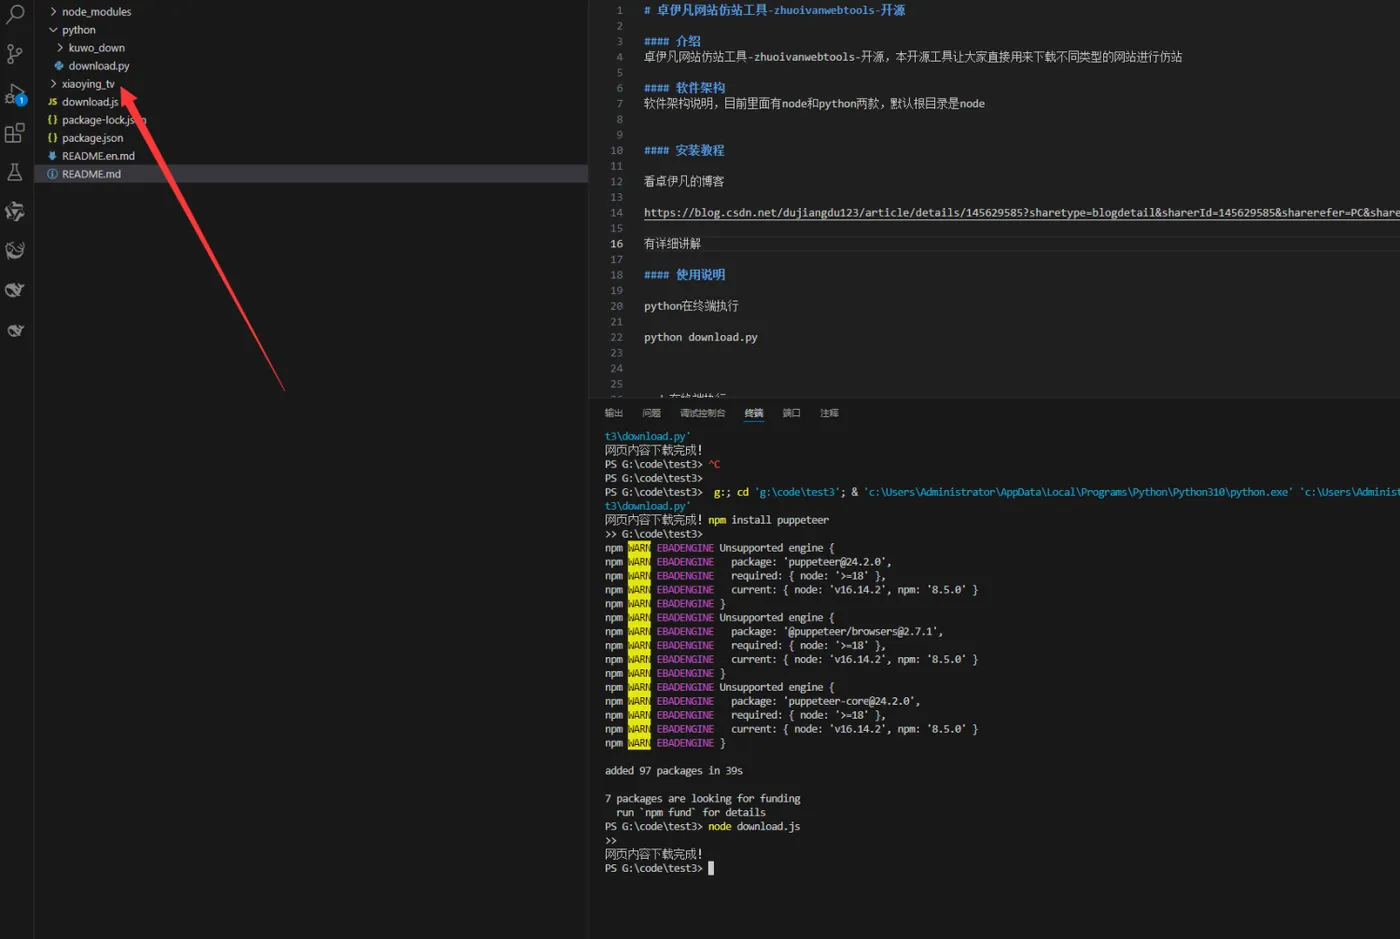
完成爬取
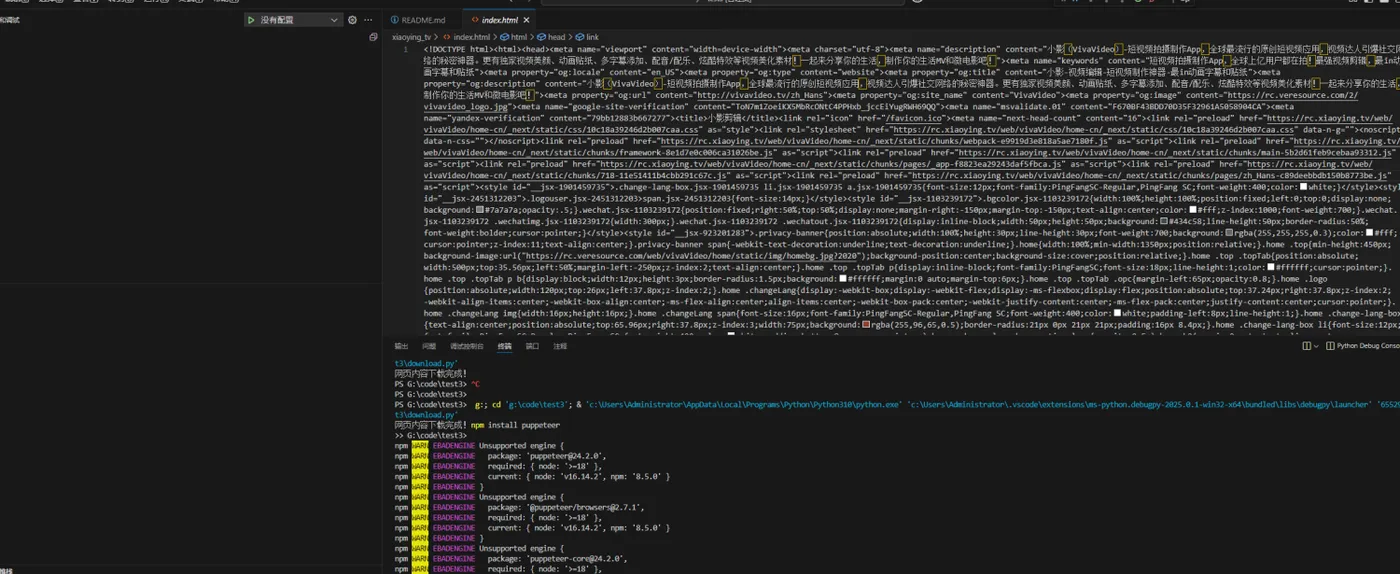
查看代码,完美,

查看预览效果,也很完美
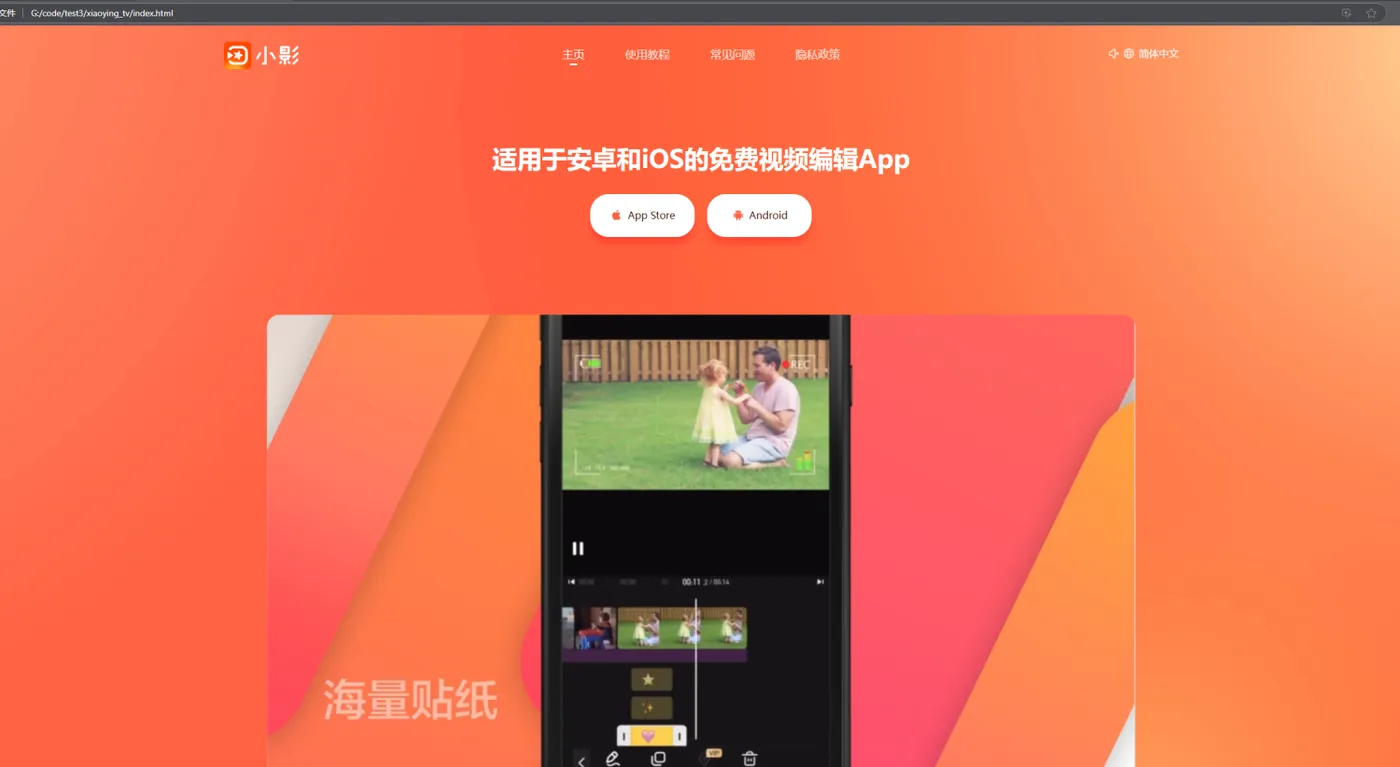
下一步我们来做安卓下载和苹果下载,以及修改网页整体内容