❤️ 如果你也关注 AI 的发展现状,且对 AI 应用开发非常感兴趣,我会每日分享大模型与 AI 领域的最新开源项目和应用,提供运行实例和实用教程,帮助你快速上手AI技术!
🥦 微信公众号|搜一搜:蚝油菜花 🥦
大家好,我是蚝油菜花,今天跟大家分享一下 JoyGen 这个由京东和香港大学联合推出的音频驱动的3D说话人脸视频生成框架。
🚀 快速阅读
JoyGen 是一个创新的3D说话人脸视频生成框架。
- 核心功能:支持多语言、高质量视觉效果和精确的唇部与音频同步。
- 技术原理:结合音频特征和面部深度图,驱动唇部运动的生成,并使用单步UNet架构进行高效的视频编辑。
JoyGen 是什么

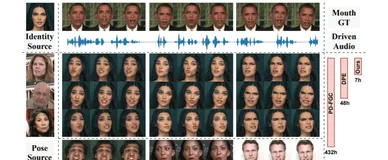
JoyGen 是京东科技和香港大学联合推出的一款音频驱动的3D说话人脸视频生成框架。它专注于实现精确的唇部与音频同步及高质量的视觉效果。通过结合音频特征和面部深度图,JoyGen 能够生成逼真的唇部运动,使用单步UNet架构进行高效的视频编辑。
在训练过程中,JoyGen 使用包含130小时中文视频的高质量数据集,并在开源的HDTF数据集上验证其优越性能。实验结果表明,JoyGen 在唇部与音频同步和视觉质量方面均达到行业领先水平,为说话人脸视频编辑领域提供了新的技术解决方案。
JoyGen 的主要功能
- 唇部与音频同步:基于音频驱动的唇部运动生成技术,确保视频中人物的唇部动作与音频内容精准对应。
- 高质量视觉效果:生成的视频具有逼真的视觉效果,包括自然的面部表情和清晰的唇部细节。
- 视频编辑与优化:在现有视频的基础上进行唇部运动的编辑和优化,无需重新生成整个视频。
- 多语言支持:支持中文和英文等不同语言的视频生成,适应多种应用场景。
JoyGen 的技术原理
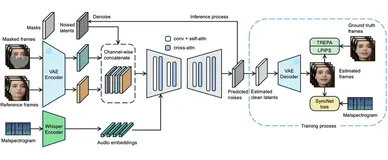
第一阶段:音频驱动的唇部运动生成
- 3D重建模型:从输入的面部图像中提取身份系数,用于描述人物的面部特征。
- 音频到运动模型:将音频信号转换为表情系数,控制唇部的运动。
- 深度图生成:结合身份系数和表情系数生成面部的3D网格,基于可微渲染技术生成面部深度图,用于后续的视频合成。
第二阶段:视觉外观合成
- 单步UNet架构:用单步UNet网络将音频特征和深度图信息整合到视频帧的生成过程中。UNet基于编码器将输入图像映射到低维潜在空间,结合音频特征和深度图信息进行唇部运动的生成。
- 跨注意力机制:音频特征基于跨注意力机制与图像特征交互,确保生成的唇部运动与音频信号高度一致。
- 解码与优化:生成的潜在表示基于解码器还原为图像空间,生成最终的视频帧。基于L1损失函数在潜在空间和像素空间进行优化,确保生成视频的高质量和同步性。
如何运行 JoyGen
1. 安装环境
创建 conda 环境并安装所需的依赖包:
conda create -n joygen python=3.8.19 ffmpeg
conda activate joygen
pip install -r requirements.txt
安装 Nvdiffrast 库:
git clone https://github.com/NVlabs/nvdiffrast
cd nvdiffrast
pip install .
下载预训练模型:
./pretrained_models/
├── BFM
│   ├── 01_MorphableModel.mat
│   └── ...
├── audio2motion
│   ├── 240210_real3dportrait_orig
│   │   └── audio2secc_vae
│   └── hubert
├── joygen
│   ├── config.json
│   └── diffusion_pytorch_model.safetensors
└── ...
2. 推理
运行推理脚本:
bash scripts/inference_pipeline.sh args1 args2 args3
逐步运行推理过程:
1. 获取音频驱动的面部表情系数:
python inference_audio2motion.py \
    --a2m_ckpt ./pretrained_models/audio2motion/240210_real3dportrait_orig/audio2secc_vae \
    --hubert_path ./pretrained_models/audio2motion/hubert \
    --drv_aud ./demo/xinwen_5s.mp3 \
    --seed 0 \
    --result_dir ./results/a2m \
    --exp_file xinwen_5s.npy
2. 渲染深度图帧:
python -u inference_edit_expression.py \
    --name face_recon_feat0.2_augment \
    --epoch=20 \
    --use_opengl False \
    --checkpoints_dir ./pretrained_models \
    --bfm_folder ./pretrained_models/BFM \
    --infer_video_path ./demo/example_5s.mp4 \
    --infer_exp_coeff_path ./results/a2m/xinwen_5s.npy \
    --infer_result_dir ./results/edit_expression
3. 生成面部动画:
CUDA_VISIBLE_DEIVCES=0 python -u inference_joygen.py \
 --unet_model_path pretrained_models/joygen \
 --vae_model_path pretrained_models/sd-vae-ft-mse \
 --intermediate_dir ./results/edit_expression \
 --audio_path demo/xinwen_5s.mp3 \
 --video_path demo/example_5s.mp4 \
 --enable_pose_driven \
 --result_dir results/talk \
 --img_size 256  \
 --gpu_id 0 \
资源
- GitHub 仓库:https://github.com/JOY-MM/JoyGen
❤️ 如果你也关注 AI 的发展现状,且对 AI 应用开发非常感兴趣,我会每日分享大模型与 AI 领域的最新开源项目和应用,提供运行实例和实用教程,帮助你快速上手AI技术!
🥦 微信公众号|搜一搜:蚝油菜花 🥦