RT-DETR改进策略【卷积层】| 利用MobileNetv4中的UIB、ExtraDW优化ResNetLayer

简介: RT-DETR改进策略【卷积层】| 利用MobileNetv4中的UIB、ExtraDW优化ResNetLayer

一、本文介绍

本文记录的是利用ExtraDW优化RT-DETR中的RepNCSPELAN4,详细说明了优化原因,注意事项等。ExtraDW是MobileNetv4模型中提出的新模块,允许以低成本增加网络深度和感受野,具有ConvNext和IB的组合优势。可以在提高模型精度的同时降低一定量的模型参数。


专栏目录:RT-DETR改进目录一览 | 涉及卷积层、轻量化、注意力、损失函数、Backbone、SPPF、Neck、检测头等全方位改进
专栏地址:RT-DETR改进专栏——以发表论文的角度,快速准确的找到有效涨点的创新点!

二、UIB介绍

Universal Inverted Bottleneck(UIB)通用反向瓶颈结构。

2.1 UIB结构设计

  1. 基于MobileNetV4

    • UIB建立在MobileNetV4之上,即采用深度可分离卷积和逐点扩展及投影的反向瓶颈结构。
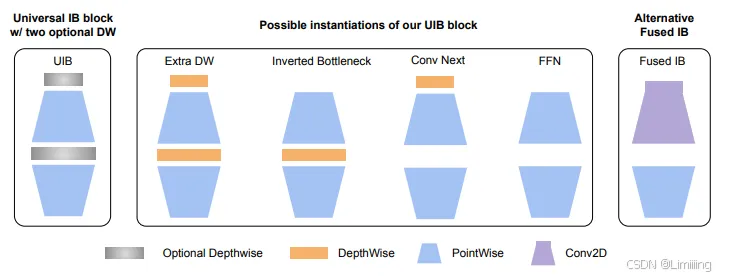
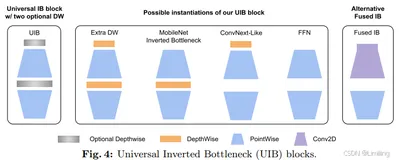
    • 在反向瓶颈块(IB)中引入两个==可选的==深度可分离卷积,一个在扩展层之前,另一个在扩展层和投影层之间。
  2. UIB有四种可能的实例化形式:

    • Inverted Bottleneck (IB):对扩展后的特征激活进行空间混合,以增加成本为代价提供更大的模型容量。
    • ConvNext:通过在扩展之前进行空间混合,使用更大的核尺寸实现更便宜的空间混合。
    • ExtraDW:文中引入的新变体,允许以低成本增加网络深度和感受野,具有ConvNext和IB的组合优势。
    • FFN:由两个1x1逐点卷积(PW)组成的栈,中间有激活和归一化层。

在这里插入图片描述

2.2 ExtraDW结构组成

结构组成:

  • 在IB块中加入两个可选的深度可分离卷积,==一个在扩展层之前,另一个在扩展层和投影层之间。==

2.3 ExtraDW特点

  1. 灵活性:

    • 在每个网络阶段,可以灵活地进行空间和通道混合的权衡调整,根据需要扩大感受野,并最大化计算利用率,增强模型对输入特征的感知能力。
  2. 效率提升:

    • 提供了一种廉价增加网络深度和感受野的方式。相比其他结构,它在增加网络深度和感受野的同时,不会带来过高的计算成本。
    • 在论文中,与其他注意力机制结合时,能有效提高模型的运算强度,减少内存访问需求,从而提高模型效率。

论文:http://arxiv.org/abs/2404.10518
源码:https://github.com/tensorflow/models/blob/master/official/vision/modeling/backbones/mobilenet.py

三、实现代码及RT-DETR修改步骤

模块完整介绍、个人总结、实现代码、模块改进、二次创新以及各模型添加步骤参考如下地址:

https://blog.csdn.net/qq_42591591/article/details/143911006

相关文章
|
机器学习/深度学习 编解码 数据可视化
【即插即用】涨点神器AFF:注意力特征融合(已经开源,附论文和源码链接)
9161 1
|
机器学习/深度学习 编解码 测试技术
RT-DETR改进策略【模型轻量化】| 替换骨干网络为 2024轻量化网络MoblieNetV4:移动生态系统的通用模型
1211 4
RT-DETR改进策略【模型轻量化】| 替换骨干网络为 2024轻量化网络MoblieNetV4:移动生态系统的通用模型
|
机器学习/深度学习 计算机视觉 iOS开发
RT-DETR改进策略【模型轻量化】| 替换骨干网络 CVPR-2024 RepViT 轻量级的Vision Transformers架构
1135 0
RT-DETR改进策略【模型轻量化】| 替换骨干网络 CVPR-2024 RepViT 轻量级的Vision Transformers架构
|
机器学习/深度学习 TensorFlow 算法框架/工具
YOLOv11改进策略【卷积层】| 利用MobileNetv4中的UIB、ExtraDW优化C3k2
1280 0
YOLOv11改进策略【卷积层】| 利用MobileNetv4中的UIB、ExtraDW优化C3k2
|
机器学习/深度学习 计算机视觉
YOLOv11改进策略【卷积层】| CVPR-2023 部分卷积 PConv 轻量化卷积,降低内存占用
1791 0
YOLOv11改进策略【卷积层】| CVPR-2023 部分卷积 PConv 轻量化卷积,降低内存占用
|
机器学习/深度学习 编解码 PyTorch
CVPR 2023 | 主干网络FasterNet 核心解读 代码分析
本文分享来自CVPR 2023的论文,提出了一种快速的主干网络,名为FasterNet。核心算子是PConv,partial convolution,部分卷积,通过减少冗余计算和内存访问来更有效地提取空间特征。
11607 58
|
机器学习/深度学习 TensorFlow 算法框架/工具
RT-DETR改进策略【注意力机制篇】| 引入MobileNetv4中的Mobile MQA,轻量化注意力模块 提高模型效率
599 2
|
人工智能 编解码 自动驾驶
RF-DETR:YOLO霸主地位不保?开源 SOTA 实时目标检测模型,比眨眼还快3倍!
RF-DETR是首个在COCO数据集上突破60 mAP的实时检测模型,结合Transformer架构与DINOv2主干网络,支持多分辨率灵活切换,为安防、自动驾驶等场景提供高精度实时检测方案。
3932 6
RF-DETR:YOLO霸主地位不保?开源 SOTA 实时目标检测模型,比眨眼还快3倍!
|
机器学习/深度学习 计算机视觉
RT-DETR改进策略【注意力机制篇】| 添加SE、CBAM、ECA、CA、Swin Transformer等注意力和多头注意力机制
1487 10
RT-DETR改进策略【注意力机制篇】| 添加SE、CBAM、ECA、CA、Swin Transformer等注意力和多头注意力机制
|
机器学习/深度学习 编解码 测试技术
YOLOv11改进策略【模型轻量化】| 替换骨干网络为 2024轻量化网络MoblieNetV4:移动生态系统的通用模型
1367 8
YOLOv11改进策略【模型轻量化】| 替换骨干网络为 2024轻量化网络MoblieNetV4:移动生态系统的通用模型

热门文章

最新文章