《C++与 SIMD 指令集:人工智能算法优化新动力》

简介: 在AI快速发展的今天,C++结合SIMD指令集成为优化算法性能的关键。SIMD通过并行处理多个数据,显著提升向量和矩阵运算速度,尤其在深度学习中表现突出。优化数据布局与算法设计,不仅提高计算效率,还降低能耗,但需注意代码的可读性和跨平台兼容性。随着技术进步,SIMD在C++中的应用将更加广泛,助力AI技术的发展。

在当今人工智能迅猛发展的时代,算法的优化成为了提升性能的关键所在。C++作为一种强大且高效的编程语言,在人工智能领域有着广泛的应用。而 SIMD(Single Instruction, Multiple Data)指令集的运用,则为 C++ 优化人工智能算法开启了一扇新的大门。

SIMD 指令集允许计算机在同一时间对多个数据执行相同的操作。这对于人工智能算法中大量存在的向量和矩阵运算来说,具有极大的优势。例如在深度学习中的神经网络计算,涉及到海量的矩阵乘法、加法等运算,SIMD 指令集可以大幅提高这些运算的速度。

从数据处理的角度来看,在 C++ 中利用 SIMD 指令集优化人工智能算法,首先要考虑数据的布局。数据在内存中的存储方式直接影响 SIMD 指令集的执行效率。一般来说,将数据按照 SIMD 指令集的要求进行对齐,可以减少数据加载和存储的时间开销。比如,对于一些特定的 SIMD 宽度,确保数据的起始地址是该宽度的倍数。这就好比将货物整齐地排列在仓库货架上,方便叉车一次性搬运更多货物,提高了整体的搬运效率。

在算法层面,许多传统的人工智能算法可以进行 SIMD 优化改造。以常见的图像卷积算法为例,在传统的 C++实现中,是逐个像素地进行卷积计算。而利用 SIMD 指令集,可以一次性处理多个像素的卷积操作。这就如同将多个工人组织起来,同时对一排像素进行加工,而不是单个工人依次处理,大大提高了工作效率。对于一些搜索算法,如在人工智能中的路径搜索或数据查找,SIMD 指令集可以并行地对多个搜索节点或数据元素进行比较操作,快速筛选出符合条件的结果。

在 C++ 程序的架构设计方面,要充分考虑 SIMD 指令集的特性。可以将 SIMD 相关的操作封装成独立的函数或模块,便于在不同的算法中复用。同时,要合理地管理数据的生命周期,确保数据在 SIMD 操作期间的有效性和一致性。这就像是在工厂中设计合理的生产线,各个环节紧密配合,高效运转。

SIMD 指令集的使用还能带来能耗方面的优化。在人工智能计算中,尤其是大规模数据处理时,能耗是一个不可忽视的问题。由于 SIMD 指令集能够在较短的时间内完成更多的计算任务,相对而言就减少了处理器的运行时间,从而降低了能耗。这对于一些移动设备或数据中心等对能耗敏感的场景下的人工智能应用具有重要意义。

从软件生态的角度来看,现代的 C++编译器也在不断地提升对 SIMD 指令集的支持。开发人员可以通过一些编译器的特定指令或编译选项,方便地启用 SIMD 优化。这降低了使用 SIMD 指令集的门槛,使得更多的 C++ 开发者能够在人工智能算法优化中运用这一强大的工具。

然而,使用 SIMD 指令集也并非一帆风顺。不同的硬件平台对 SIMD 指令集的支持程度有所差异,开发人员需要针对特定的硬件进行适配和优化。而且,过度地追求 SIMD 优化可能会导致代码的可读性和可维护性下降,因此需要在性能提升和代码质量之间找到一个平衡。

总之,在 C++ 中运用 SIMD 指令集优化人工智能算法是一个充满潜力和挑战的领域。它为人工智能算法的性能提升、能耗优化等多方面提供了有效的解决方案。随着硬件技术的不断发展和 C++ 编译器的持续优化,SIMD 指令集在 C++ 人工智能开发中的作用将会越来越重要,也将助力人工智能技术在更多领域的广泛应用和深入发展。开发人员若能熟练掌握这一优化手段,将在人工智能算法的开发竞赛中占据有利的地位,为推动人工智能技术的进步贡献更多的力量。
相关文章
|
2月前
|
人工智能 API 开发工具
最新版Qwen Code全解:核心功能详解与阿里云百炼Coding Plan、Token Plan接入教程
在AI赋能编程的浪潮中,终端级AI编程工具凭借轻量化、高效能的特性,成为开发者提升编码效率的重要选择。Qwen Code作为一款专为代码开发打造的终端AI工具,凭借强大的代码理解、生成与调试能力,以及对阿里云百炼生态的深度兼容,快速成为开发者的热门选择。最新版Qwen Code在功能上实现多项关键升级,同时提供便捷的接入方式,可无缝对接阿里云百炼的Coding Plan与Token Plan两大订阅方案,满足个人与团队不同场景的AI编程需求。本文将全面解析最新版Qwen Code的核心功能,并详细讲解接入阿里云百炼Coding Plan、Token Plan的完整流程,助力开发者快速上手,释放
314 2
|
机器学习/深度学习 数据采集 人工智能
阿里巴巴首次揭秘电商知识图谱AliCoCo!淘宝搜索原来这样玩!
电商技术进入认知智能时代,将给亿万用户带来更加智能的购物体验。经过两年的探索与实践,阿里巴巴的电商认知图谱 AliCoCo 已成体系规模,并在搜索推荐等电商核心业务场景上取得佳绩,关于 AliCoCo 的文章《AliCoCo: Alibaba E-commerce Cognitive Concept Net》也已被国际顶会 SIGMOD 接收,这是阿里巴巴首次正式揭秘领域知识图谱。 本文将通过介绍 AliCoCo 的背景、定义、底层设计、构建过程中的一些算法问题,以及在电商搜索和推荐上的广泛应用,分享 AliCoCo 从诞生到成为阿里巴巴核心电商引擎的基石这一路走来的思考。
21051 2
阿里巴巴首次揭秘电商知识图谱AliCoCo!淘宝搜索原来这样玩!
|
IDE Linux 开发工具
内存泄漏检测工具Valgrind:C++代码问题检测的利器(一)
内存泄漏检测工具Valgrind:C++代码问题检测的利器
3966 0
|
缓存 算法 搜索推荐
从O(n²)到O(n log n):深度剖析快速排序的内存优化与cache-friendly实现 🌟 Hello,我是摘星!
作为一名深耕算法优化领域多年的技术工程师,我见证了无数次关于排序算法性能讨论的激烈辩论,而快速排序(QuickSort)始终以其卓越的实践表现占据着核心地位。今天我想和大家深入探讨的,不仅仅是快速排序的基础实现,更是如何通过精妙的内存优化策略,将其从理论上的O(n²)最坏时间复杂度,提升到实际应用中稳定的O(n log n)性能表现,并实现真正的cache-friendly设计。在我的实践经验中,许多开发者对快速排序的理解还停留在基础的递归实现层面,而忽略了现代计算机体系结构下内存层次结构对算法性能的深刻影响。本文将系统地分析快速排序在内存访问模式、缓存局部性、尾递归优化等方面的核心技术要点,
515 0
从O(n²)到O(n log n):深度剖析快速排序的内存优化与cache-friendly实现 🌟 Hello,我是摘星!
|
存储 人工智能 监控
看得清、判得准、动得快:智能摄像头如何优化安全监控系统
385 3
|
搜索推荐 算法 大数据
基于python大数据的旅游景点可视化与推荐系统
本系统基于大数据与网络技术,构建个性化旅游推荐平台。通过收集用户偏好及行为数据,结合机器学习算法,提供精准的旅游目的地、住宿及交通推荐,旨在优化旅游信息传递,提升用户决策效率与旅行体验。
|
机器学习/深度学习 人工智能 程序员
MiniMind:3小时训练26MB微型语言模型,开源项目助力AI初学者快速入门
在大型语言模型(LLaMA、GPT等)日益流行的今天,一个名为MiniMind的开源项目正在AI学习圈内引起广泛关注。项目让初学者能够在3小时内从零开始训练出一个仅26.88MB大小的微型语言模型。
1015 1
|
人工智能 移动开发 开发工具
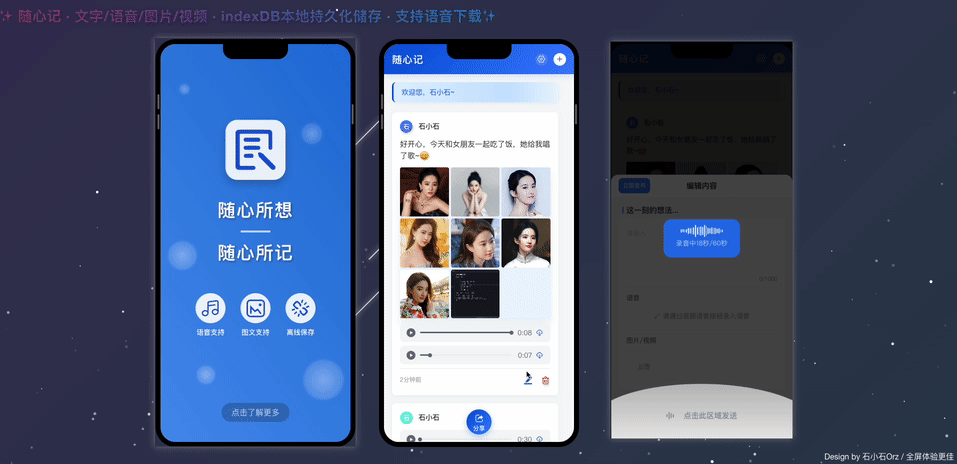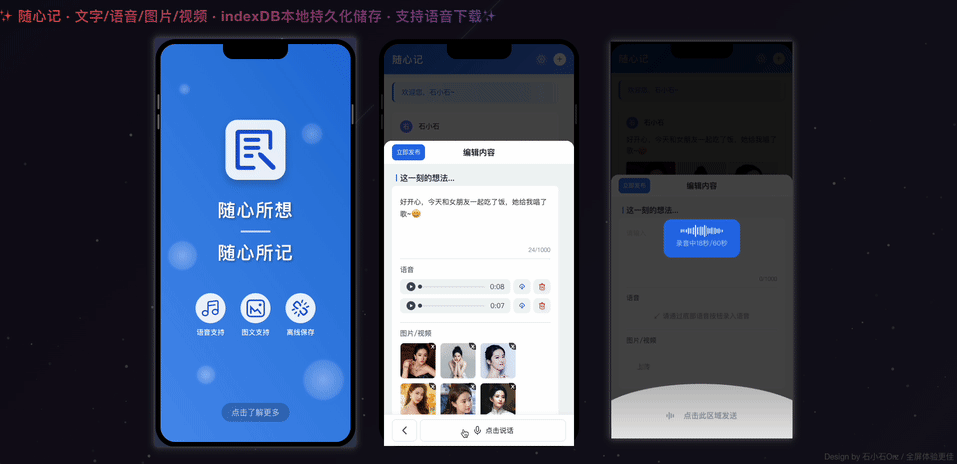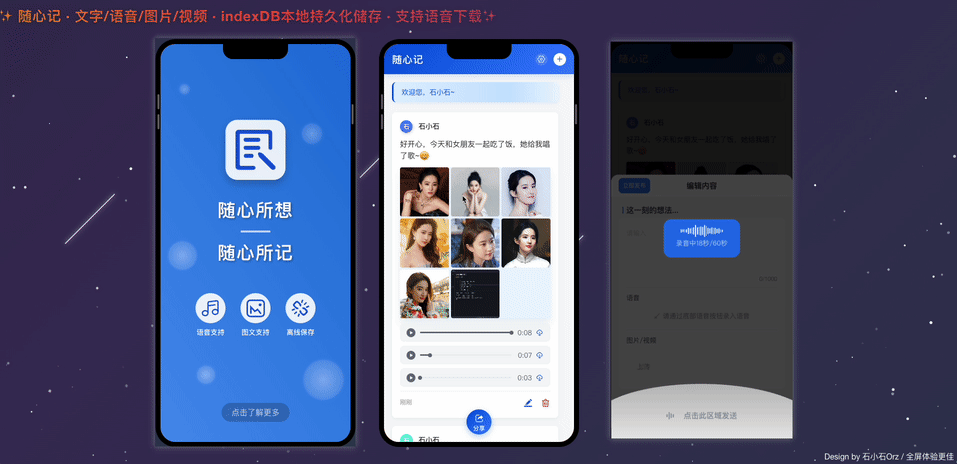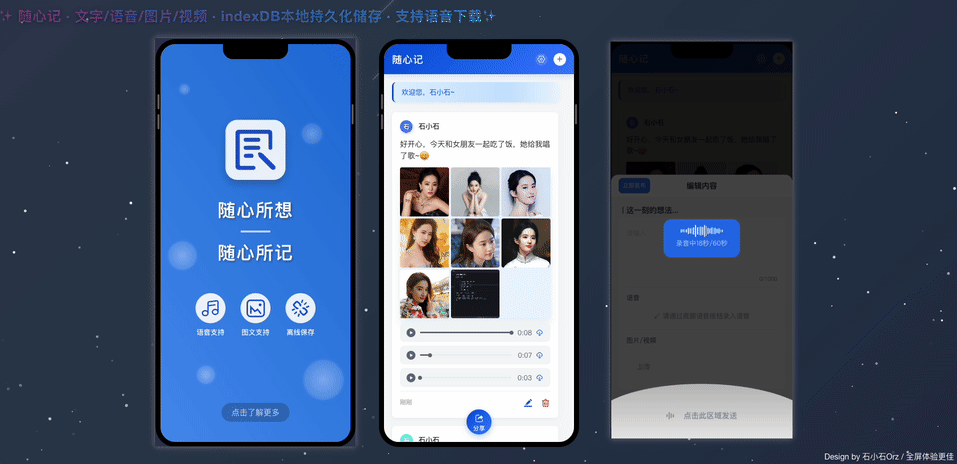
H5录音、图文视频IndexDB储存最佳实践:用AI生成语音备忘录
随心记是一个由 AI 生成的网页备忘录,它支持语音录入(可下载)、图文视频记录。最重要的是,它支持离线使用,所有数据都储存在浏览器中,不依赖后端,刷新页面数据也不会丢失!
624 0
H5录音、图文视频IndexDB储存最佳实践:用AI生成语音备忘录
|
机器学习/深度学习 自然语言处理 算法
机器学习核心:监督学习与无监督学习
本文深入解析了机器学习中的监督学习与无监督学习,涵盖理论基础、应用场景及典型算法实现,如线性回归、决策树、K均值聚类和主成分分析,并通过代码示例加深理解。适合初学者和进阶者阅读。
1229 5
|
Ubuntu Linux 开发工具
Windows11 WSL2 Ubuntu编译安装perf工具
1342 0