【YOLOv11改进 - 注意力机制】CoTAttention:上下文转换器注意力

简介: 【YOLOv11改进 - 注意力机制】CoTAttention:上下文转换器注意力Contextual Transformer (CoT) 是一种新型的Transformer风格模块,通过3×3卷积对输入键进行上下文编码,生成静态上下文表示,并通过两个1×1卷积学习动态多头注意力矩阵,增强视觉表示能力。CoTNet将CoT块应用于ResNet架构中,替代3×3卷积,提升图像识别、目标检测和实例分割等任务的性能。源码可在GitHub获取。

介绍

image-20240528110220667

摘要

Transformer自注意力机制已经引领了自然语言处理领域的革命,并且最近激发了Transformer风格架构设计在众多计算机视觉任务中取得竞争性结果。然而,大多数现有设计直接在二维特征图上使用自注意力机制,以基于每个空间位置的孤立查询和键对来获取注意力矩阵,但没有充分利用邻近键之间的丰富上下文信息。在这项工作中,我们设计了一种新颖的Transformer风格模块,即Contextual Transformer(CoT)块,用于视觉识别。该设计充分利用了输入键之间的上下文信息,以引导动态注意力矩阵的学习,从而增强视觉表示的能力。

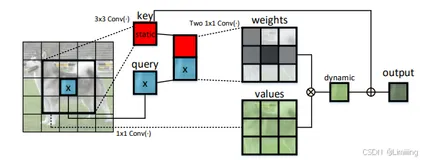
在技术上,CoT块首先通过一个3×3卷积对输入键进行上下文编码,导致输入的静态上下文表示。我们进一步将编码后的键与输入查询连接起来,通过两个连续的1×1卷积来学习动态多头注意力矩阵。学习到的注意力矩阵与输入值相乘,以实现输入的动态上下文表示。静态和动态上下文表示的融合最终作为输出。我们提出的CoT块非常有吸引力,因为它可以轻松替换ResNet架构中的每一个3×3卷积,从而生成一种名为Contextual Transformer Networks(CoTNet)的Transformer风格骨干网络。通过在广泛应用(例如图像识别、目标检测和实例分割)中的大量实验,我们验证了CoTNet作为更强骨干网络的优越性。源码可在https://github.com/JDAI-CV/CoTNet获取。

YOLOv11目标检测创新改进与实战案例专栏

点击查看文章目录: YOLOv11创新改进系列及项目实战目录 包含卷积,主干 注意力,检测头等创新机制 以及 各种目标检测分割项目实战案例

点击查看专栏链接: YOLOv11目标检测创新改进与实战案例

在这里插入图片描述

文章链接

论文地址:论文地址

代码地址:代码地址

基本原理

CoTNet是一种基于Contextual Transformer(CoT)模块的网络结构,其原理如下:

  1. CoTNet原理:
    • CoTNet采用Contextual Transformer(CoT)模块作为构建块,用于替代传统的卷积操作。
    • CoT模块利用3×3卷积来对输入键之间的上下文信息进行编码,生成静态上下文表示。
    • 将编码后的键与输入查询连接,通过两个连续的1×1卷积来学习动态多头注意力矩阵。
    • 学习到的注意力矩阵用于聚合所有输入数值,生成动态上下文表示。
    • 最终将静态和动态上下文表示融合作为输出。
  1. Contextual Transformer Attention在CoTNet中的作用和原理:

    Contextual Transformer Attention是Contextual Transformer(CoT)模块中的关键组成部分,用于引导动态学习注意力矩阵,从而增强视觉表示并提高计算机视觉任务的性能

    • Contextual Transformer Attention是CoT模块中的注意力机制,用于引导动态学习注意力矩阵。
    • 通过Contextual Transformer Attention,模型能够充分利用输入键之间的上下文信息,从而更好地捕捉动态关系。
    • 这种注意力机制有助于增强视觉表示,并提高计算机视觉任务的性能。
    • CoTNet通过整合Contextual Transformer Attention,实现了同时进行上下文挖掘和自注意力学习的优势,从而提升了深度网络的表征能力。

核心代码

import torch
from torch import flatten, nn
from torch.nn import functional as F

class CoTAttention(nn.Module):
    def __init__(self, dim=512, kernel_size=3):
        super().__init__()
        self.dim = dim  # 输入通道数
        self.kernel_size = kernel_size  # 卷积核大小

        # 关键信息嵌入层,使用分组卷积提取特征
        self.key_embed = nn.Sequential(
            nn.Conv2d(dim, dim, kernel_size=kernel_size, padding=kernel_size // 2, groups=4, bias=False),
            nn.BatchNorm2d(dim),  # 归一化层
            nn.ReLU()  # 激活函数
        )
        # 值信息嵌入层,使用1x1卷积进行特征转换
        self.value_embed = nn.Sequential(
            nn.Conv2d(dim, dim, 1, bias=False),
            nn.BatchNorm2d(dim)  # 归一化层
        )

        # 注意力机制嵌入层,先降维后升维,最终输出与卷积核大小和通道数相匹配的特征
        factor = 4  # 降维比例
        self.attention_embed = nn.Sequential(
            nn.Conv2d(2 * dim, 2 * dim // factor, 1, bias=False),
            nn.BatchNorm2d(2 * dim // factor),  # 归一化层
            nn.ReLU(),  # 激活函数
            nn.Conv2d(2 * dim // factor, kernel_size * kernel_size * dim, 1)  # 升维匹配卷积核形状
        )

task与yaml配置

详见:https://blog.csdn.net/shangyanaf/article/details/143099154

相关文章
|
10月前
|
机器学习/深度学习 算法 atlas
YOLOv11 改进 - 注意力机制 MCAttn 蒙特卡洛注意力:全局上下文与局部细节协同建模,破解微小目标特征表达难题
本文提出将蒙特卡洛注意力(MCAttn)模块融入YOLOv11,通过随机采样多尺度池化特征并加权融合,增强模型对小目标的敏感性。MCAttn兼顾局部细节与全局上下文,提升检测精度,尤其适用于医学图像中小面积病灶识别,显著改善特征丢失问题,且保持轻量化与高效推理。
YOLOv11 改进 - 注意力机制 MCAttn 蒙特卡洛注意力:全局上下文与局部细节协同建模,破解微小目标特征表达难题
|
机器学习/深度学习 计算机视觉 知识图谱
YOLOv11改进策略【Conv和Transformer】| 上下文转换器CoT 结合静态和动态上下文信息的注意力机制 (含二次创新C3k2)
647 10
YOLOv11改进策略【Conv和Transformer】| 上下文转换器CoT 结合静态和动态上下文信息的注意力机制 (含二次创新C3k2)
|
机器学习/深度学习 自然语言处理 数据可视化
22_注意力机制详解:从基础到2025年最新进展
在深度学习的发展历程中,注意力机制(Attention Mechanism)扮演着越来越重要的角色,特别是在自然语言处理(NLP)、计算机视觉(CV)和语音识别等领域。注意力机制的核心思想是模拟人类视觉系统的聚焦能力,让模型能够在处理复杂数据时,选择性地关注输入的不同部分,从而提高模型的性能和可解释性。
2006 0
|
机器学习/深度学习 计算机视觉
YOLOv11改进策略【注意力机制篇】| 添加SE、CBAM、ECA、CA、Swin Transformer等注意力和多头注意力机制
5069 2
YOLOv11改进策略【注意力机制篇】| 添加SE、CBAM、ECA、CA、Swin Transformer等注意力和多头注意力机制
|
机器学习/深度学习 数据可视化 算法
YOLOv11改进目录一览 | 涉及卷积层、轻量化、注意力、损失函数、Backbone、SPPF、Neck、检测头等全方位改进
2833 7
YOLOv11改进目录一览 | 涉及卷积层、轻量化、注意力、损失函数、Backbone、SPPF、Neck、检测头等全方位改进
|
机器学习/深度学习 PyTorch TensorFlow
YOLOv11改进策略【卷积层】| SPD-Conv 针对小目标和低分辨率图像的检测任务
1128 12
YOLOv11改进策略【卷积层】| SPD-Conv 针对小目标和低分辨率图像的检测任务
|
计算机视觉
YOLOv11改进策略【小目标改进】| 2024-TOP 自适应阈值焦点损失(ATFL)提升对小目标的检测能力
2391 11
YOLOv11改进策略【小目标改进】| 2024-TOP 自适应阈值焦点损失(ATFL)提升对小目标的检测能力
|
机器学习/深度学习
YOLOv11改进策略【Neck】| GSConv+Slim Neck:混合深度可分离卷积和标准卷积的轻量化网络设计
1719 8
YOLOv11改进策略【Neck】| GSConv+Slim Neck:混合深度可分离卷积和标准卷积的轻量化网络设计
|
机器学习/深度学习 计算机视觉
YOLOv8改进 | 损失函数篇 | SlideLoss、FocalLoss分类损失函数助力细节涨点(全网最全)
1956 0
|
计算机视觉 机器学习/深度学习 自然语言处理
【YOLOv8改进】CoTAttention:上下文转换器注意力(论文笔记+引入代码)
本文介绍了YOLO目标检测的创新改进,提出了一种名为Contextual Transformer (CoT)块的新型Transformer模块,用于增强视觉识别能力。CoT块通过3×3卷积编码上下文信息,并结合动态多头注意力矩阵,提高了视觉表示。此外,还提到了Large Separable Kernel Attention (LSKA)模块,它解决了大内核卷积的计算效率问题。CoTNet是基于CoT模块的Transformer风格骨干网络,可替代ResNet中的3×3卷积。CoTAttention类展示了如何在YOLOv8中集成此模块。文章还提供了源码链接和更多实战案例详情。