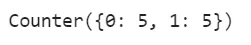模型预测笔记(二):结合SMOTE来进行数据不均衡处理实操

简介: 这篇文章介绍了SMOTE算法,这是一种通过合成新样本来处理数据不均衡问题的技术,旨在提高模型对少数类别的识别能力。

数据不均衡危害

在模型预测中,数据不均衡是指不同类别的样本数量差异很大。这种情况可能会对模型的性能和结果产生一些危害:

  • 偏斜的预测结果:由于某些类别的样本数量较少,模型可能会倾向于预测数量更多的类别,而忽略数量较少的类别。这会导致模型在预测时出现偏斜,对少数类别的预测效果较差。
  • 误导性的评估指标:在数据不均衡的情况下,使用传统的评估指标(如准确率)可能会产生误导。因为模型可以简单地将所有样本预测为数量更多的类别,从而获得较高的准确率,而忽略了对少数类别的预测能力。
  • 不稳定的模型训练:当数据不均衡时,模型可能会过度拟合数量较多的类别,而忽略数量较少的类别。这可能导致模型在实际应用中的泛化能力较差,对新样本的预测表现不佳。
  • 不准确的特征重要性:在数据不均衡的情况下,模型可能会错误地认为与数量更多的类别相关的特征更重要,而忽略了与数量较少的类别相关的特征。这可能导致模型对于不同类别的预测能力的偏差。

如何解决

为了解决数据不均衡的问题,可以采取以下一些方法:

  • 重采样技术:通过欠采样(随机删除数量较多的样本)或过采样(复制数量较少的样本)来平衡数据集中的类别数量。
  • 类别权重调整:通过为数量较少的类别赋予更高的权重,来平衡不同类别的重要性。
  • 引入合成样本:通过生成合成样本来增加数量较少的类别的样本数量,例如使用SMOTE(Synthetic Minority Over-sampling Technique)算法。
  • 使用集成方法:使用集成学习方法,如随机森林或梯度提升树,可以通过组合多个模型的预测结果来改善对少数类别的预测能力。

综上所述,数据不均衡可能会对模型预测的准确性和稳定性产生负面影响。通过合适的数据处理和模型调整方法,可以改善模型在不均衡数据集上的表现。

SMOTE

原理

SMOTE(Synthetic Minority Over-sampling Technique)是一种用于解决类别不平衡问题的数据增强算法。其原理如下:

  • 首先,对于数据集中的每一个少数类样本,计算其与其K个最近邻样本的差值:diff = neighbor - sample,其中neighbor是样本的一个最近邻样本,sample是当前样本。
  • 然后,对于每一个少数类样本,随机选择其中一个最近邻样本,并根据公式生成一个新的样本:new_sample = sample + random * diff,其中random是一个[0, 1]之间的随机数。
  • 最后,将生成的新样本添加到原始数据集中,使得少数类样本的数量增加,从而达到平衡数据集的目的。

SMOTE的关键思想是通过合成新的少数类样本来增加数据集中少数类样本的数量,从而达到平衡数据集的目的。通过引入合成样本,SMOTE可以更好地捕捉到少数类样本之间的特征分布,从而提高分类器的性能。也就是SMOTE 通过线性插值的方法在两个少数类样本间合成新的样本,从而有效缓解了由随机过采样引起的过拟合问题。

代码

# 遇到样本不均衡的问题,通过SMOTE来建立训练数据集和测试数据集
from sklearn.model_selection import train_test_split
sos = SMOTE(n_jobs=-1)
X_sos, y_sos = sos.fit_resample(X, y)
print('SMOTE过采样后,训练集 y_sos 中的分类情况:{}'.format(Counter(y_sos)))

X_train, X_test, y_train, y_test = train_test_split(X_sos,y_sos,test_size = 0.3, random_state = 0)
print("原始训练集包含样本数量: ", len(X_train))
print("原始测试集包含样本数量:  ", len(X_test))
print("原始样本总数: ", len(X_train)+len(X_test))

效果

初始:
在这里插入图片描述
处理后:

在这里插入图片描述

目录
相关文章
|
9月前
|
机器学习/深度学习 传感器 算法
Python | Stacking回归和SHAP可解释性分析回归预测及可视化算法
本教程基于Python实现Stacking回归与SHAP可解释性分析,涵盖地球科学、医学、工程等多领域回归预测应用。结合CatBoost、LightGBM、XGBoost等模型,采用贝叶斯、随机与网格搜索优化参数,并通过SHAP值可视化特征贡献,提升模型性能与可解释性,适用于科研与实际项目。
1054 2
|
NoSQL IDE 网络协议
Redis高级客户端Lettuce详解(下)
Lettuce是一个Redis的Java驱动包,初识她的时候是使用RedisTemplate的时候遇到点问题Debug到底层的一些源码,发现spring-data-redis的驱动包在某个版本之后替换为Lettuce。既然能被Spring生态所认可,Lettuce想必有过人之处,于是笔者花时间阅读她的官方文档,整理测试示例,写下这篇文章。
6575 0
|
数据处理
数据处理 过采样与欠采样 SMOTE与随机采样 达到样本均衡化
806 0
数据处理 过采样与欠采样 SMOTE与随机采样 达到样本均衡化
|
机器学习/深度学习 异构计算 Python
Bert-vits2最终版Bert-vits2-2.3云端训练和推理(Colab免费GPU算力平台)
对于深度学习初学者来说,JupyterNoteBook的脚本运行形式显然更加友好,依托Python语言的跨平台特性,JupyterNoteBook既可以在本地线下环境运行,也可以在线上服务器上运行。GoogleColab作为免费GPU算力平台的执牛耳者,更是让JupyterNoteBook的脚本运行形式如虎添翼。 本次我们利用Bert-vits2的最终版Bert-vits2-v2.3和JupyterNoteBook的脚本来复刻生化危机6的人气角色艾达王(ada wong)。
Bert-vits2最终版Bert-vits2-2.3云端训练和推理(Colab免费GPU算力平台)
|
7月前
|
数据采集 运维 监控
企业级BI系统建设方案(2026年3月)
2026年,BI已成企业必选项。本文聚焦BI选型核心命题,剖析数据孤岛、响应滞后等痛点,提出“全链路、智能化、自助式”新一代BI建设方案,推荐瓴羊Quick BI为引擎,构建云原生四层架构,6–12个月闭环落地,实现报表效率提升90%、决策响应达分钟级。(239字)
|
9月前
|
存储 弹性计算 关系型数据库
阿里云中小企业扶持权益中心内容说明及节省上云操作手册参考
本文将以技术视角,结合最新权益细则,用通俗语言全面拆解权益中心的核心内容、适用场景、申请步骤和实操技巧,还整理了不同规模企业的高性价比组合方案,帮助你避开误区,用合理成本实现稳定上云。全文无营销话术,所有内容基于实测体验和官方规则整理,可直接作为上云操作手册参考。
602 1
|
机器学习/深度学习 算法 Python
Python 使用SMOTE解决数据不平衡问题(最新推荐)
SMOTE是一种强大的过采样技术,可以有效地处理不平衡数据集,提升分类器的性能。通过imbalanced-learn库中的SMOTE实现,我们可以轻松地对少数类样本进行过采样,平衡数据集。在实际应用中,我们可以根据具体数据集的特点和需求,选择合适的过采样方法。
|
监控 异构计算
Jetson 学习笔记(八):htop查看CPU占用情况和jtop监控CPU和GPU
在NVIDIA Jetson平台上使用htop和jtop工具来监控CPU、GPU和内存的使用情况,并提供了安装和使用这些工具的具体命令。
1901 0
|
算法 Python
SMOTE
【6月更文挑战第26天】
2081 1
|
前端开发 Linux 网络安全
在Linux中,如何配置防火墙?
在Linux中,如何配置防火墙?

热门文章

最新文章