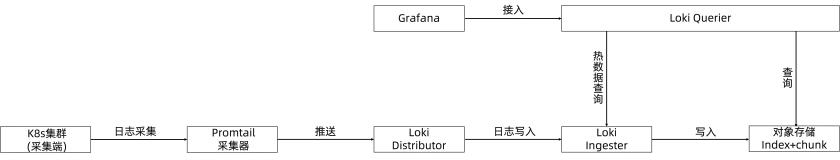
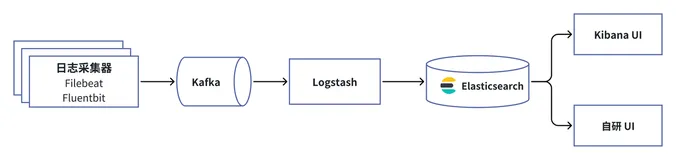
随着互联网应用和微服务架构的普及,系统产生的日志数据量日益增长。有效地收集、存储、检索和分析这些日志对于监控系统健康状态、快速定位问题以及优化性能至关重要。Elasticsearch 作为一种分布式的搜索和分析引擎,以其强大的全文检索能力和实时数据分析能力成为日志处理的理想选择。
本文将指导读者从零开始构建一个基于Elasticsearch的日志分析平台,并通过实际代码示例展示如何实现这一过程。我们将涵盖以下几个关键步骤:
- 环境搭建:安装并配置Elasticsearch集群。
- 数据采集:使用Filebeat进行日志文件的实时读取与转发。
- 索引设计:定义合理的Elasticsearch索引模式以优化查询性能。
- 数据导入:将收集到的日志数据导入Elasticsearch。
- 数据可视化:利用Kibana创建仪表盘来直观展示日志信息。
- 高级功能:探讨一些高级用例,如报警机制和异常检测。
环境搭建
首先,确保你的服务器上已经安装了Java运行时环境(JRE),因为Elasticsearch是基于Java开发的。接下来,下载并解压Elasticsearch发行版。
wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-7.10.2-linux-x86_64.tar.gz
tar -xzf elasticsearch-7.10.2-linux-x86_64.tar.gz
cd elasticsearch-7.10.2/
编辑config/elasticsearch.yml文件来配置节点名称、群集名称等基本设置。然后启动Elasticsearch服务。
./bin/elasticsearch
为了保证高可用性和负载均衡,建议至少部署三个节点形成一个小型集群。
数据采集
安装与配置Filebeat
Filebeat 是 Elastic Stack 的一部分,用于实时地从文件中读取日志并将它们发送到 Elasticsearch 或 Logstash。
wget https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-7.10.2-linux-x86_64.tar.gz
tar -xzf filebeat-7.10.2-linux-x86_64.tar.gz
cd filebeat-7.10.2-linux-x86_64/
编辑filebeat.yml配置文件以指定要监听的日志文件路径及输出目标。
filebeat.inputs:
- type: log
  enabled: true
  paths:
    - /var/log/*.log

output.elasticsearch:
  hosts: ["localhost:9200"]
  index: "filebeat-%{[agent.version]}-%{+yyyy.MM.dd}"
启动Filebeat服务:
./filebeat -e
索引设计
良好的索引设计可以显著提升查询效率。考虑到日志数据通常具有时间属性,我们可以按天为单位划分索引。
PUT _template/filebeat_template
{

  "index_patterns": ["filebeat-*"],
  "settings": {

    "number_of_shards": 1,
    "number_of_replicas": 1
  },
  "mappings": {

    "properties": {

      "@timestamp": {
    "type": "date" },
      "message": {
    "type": "text" }
    }
  }
}
上述模板定义了一个名为filebeat_*的索引模式,并设置了分片数和副本数。同时指定了@timestamp字段为日期类型,message字段为文本类型以便于全文搜索。
数据导入
一旦Filebeat开始向Elasticsearch发送数据,你就可以看到新创建的索引出现在集群中。可以通过以下命令检查索引列表:
curl -X GET "localhost:9200/_cat/indices?v"
数据可视化
Kibana 提供了一个用户友好的界面来探索和可视化存储在Elasticsearch中的数据。安装Kibana同样简单:
wget https://artifacts.elastic.co/downloads/kibana/kibana-7.10.2-linux-x86_64.tar.gz
tar -xzf kibana-7.10.2-linux-x86_64.tar.gz
cd kibana-7.10.2-linux-x86_64/
修改config/kibana.yml文件中的Elasticsearch地址后启动Kibana服务。
./bin/kibana
打开浏览器访问http://<your_server_ip>:5601,登录Kibana控制台。在这里你可以创建索引模式并开始构建可视化图表。
创建索引模式
进入Kibana管理界面,选择“Index Patterns”并点击“Create Index Pattern”。输入之前定义的索引模式名称(例如filebeat-*)并指定时间字段为@timestamp。
构建可视化视图
使用Discover功能浏览日志内容,并尝试不同的过滤条件。接着,在Visualize部分创建柱状图、饼图或其他类型的图表来表示不同维度的数据统计。
高级功能
报警机制
利用Watcher插件或X-Pack内置的Alerting功能,可以根据特定条件触发邮件通知或其他形式的警告。
PUT _watcher/watch/error_logs_alert
{

  "trigger": {

    "schedule": {

      "interval": "1m"
    }
  },
  "input": {

    "search": {

      "request": {

        "indices": [ "filebeat-*" ],
        "body": {

          "size": 0,
          "query": {

            "match_phrase": {

              "message": "ERROR"
            }
          }
        }
      }
    }
  },
  "condition": {

    "compare": {

      "ctx.payload.hits.total.value": {

        "gt": 0
      }
    }
  },
  "actions": {

    "send_email": {

      "email": {

        "to": "admin@example.com",
        "subject": "Error Logs Detected",
        "body": "There are {
   {ctx.payload.hits.total.value}} error logs in the system."
      }
    }
  }
}
这段配置定义了一个每分钟执行一次的监视器,当发现含有"ERROR"关键字的日志条目时,会自动发送一封电子邮件给管理员。
异常检测
借助Machine Learning模块,Elasticsearch能够自动识别出数据中的异常模式。首先需要启用ML功能,然后创建一个新的Job来进行异常检测。
PUT _ml/anomaly_detectors/my_log_analyzer
{

  "analysis_config": {

    "bucket_span": "1h",
    "detectors": [
      {

        "function": "count",
        "partition_field_name": "host.keyword"
      }
    ]
  },
  "data_description": {

    "time_field": "@timestamp"
  }
}
此Job将每小时聚合一次数据,并对每个主机上的日志数量进行计数。任何偏离正常范围的行为都会被标记为潜在的异常。
结论
通过结合Elasticsearch、Filebeat、Kibana以及其他相关工具和技术,我们成功构建了一个高效且可扩展的日志分析平台。这个平台不仅支持实时日志流处理,还提供了丰富的可视化选项以及先进的异常检测能力,极大地提升了运维团队的工作效率和响应速度。未来,随着技术的发展,该平台还可以进一步集成更多的自动化和智能化组件,为企业提供更加全面的日志管理和安全解决方案。