【Azure 事件中心】使用Apache Flink 连接 Event Hubs 出错 Kafka error: No resolvable bootstrap urls

简介: 【Azure 事件中心】使用Apache Flink 连接 Event Hubs 出错 Kafka error: No resolvable bootstrap urls

问题描述

参考Github上 Event Hub的示例代码(Using Apache Flink with Event Hubs for Apache Kafka Ecosystems : https://github.com/Azure/azure-event-hubs-for-kafka/tree/master/tutorials/flink),使用Apache Flink kafka连接中国区的Azure Event Hub,遇到 Kafka error: No resolvable bootstrap urls

kafkashaded.org.apache.kafka.common.KafkaException: Failed to construct kafka consumer


Caused by: kafkashaded.org.apache.kafka.common.config.ConfigException: No resolvable bootstrap urls given in bootstrap.servers

根据文档只修改了下图中红色标记的部分:


问题解答

根据错误消息,知道是 bootstrap servers url 的配置错误,bootstrap.servers=mynamespace.servicebus.windows.net:9093, 因为Github上的示例代码以Global Azure的Event Hub服务的终结点为例,而当前使用的是中国区的Azure Event Hub。中国区正确的 Endpoint 为: bootstrap.servers=mynamespace. servicebus.chinacloudapi.cn:9093

This error message occurs when an invalid hostname or IP address is passed to the kafka.bootstrap.servers configuration, The Kafka bootstrap server is not running at the given hostname or IP address.


参考资料

Using Apache Flink with Event Hubs for Apache Kafka Ecosystems : https://github.com/Azure/azure-event-hubs-for-kafka/tree/master/tutorials/flink

Kafka error: No resolvable bootstrap urls:https://learn.microsoft.com/en-us/azure/databricks/kb/streaming/kafka-no-resolvable-bootstrap-urls
相关文章
|
消息中间件 监控 Java
Apache Kafka 分布式流处理平台技术详解与实践指南
本文档全面介绍 Apache Kafka 分布式流处理平台的核心概念、架构设计和实践应用。作为高吞吐量、低延迟的分布式消息系统,Kafka 已成为现代数据管道和流处理应用的事实标准。本文将深入探讨其生产者-消费者模型、主题分区机制、副本复制、流处理API等核心机制,帮助开发者构建可靠、可扩展的实时数据流处理系统。
1065 4
消息中间件 存储 传感器
716 0
|
消息中间件 存储 监控
Apache Kafka 3.0与KRaft模式的革新解读
在该架构中,Kafka集群依旧包含多个broker节点,但已不再依赖ZooKeeper集群。被选中的Kafka集群Controller将从KRaft Quorum中加载其状态,并在必要时通知其他Broker节点关于元数据的变更。这种设计支持更多分区与快速Controller切换,并有效避免了因数据不一致导致的问题。
|
消息中间件 SQL 关系型数据库
Flink CDC + Kafka 加速业务实时化
Flink CDC 是一种支持流批一体的分布式数据集成工具,通过 YAML 配置实现数据传输过程中的路由与转换操作。它已从单一数据源的 CDC 数据流发展为完整的数据同步解决方案,支持 MySQL、Kafka 等多种数据源和目标端(如 Delta Lake、Iceberg)。其核心功能包括多样化数据输入链路、Schema Evolution、Transform 和 Routing 模块,以及丰富的监控指标。相比传统 SQL 和 DataStream 作业,Flink CDC 提供更灵活的 Schema 变更控制和原始 binlog 同步能力。
|
消息中间件 运维 Kafka
直播预告|Kafka+Flink 双引擎实战:手把手带你搭建分布式实时分析平台!
475 11
|
消息中间件 运维 Kafka
直播预告|Kafka+Flink双引擎实战:手把手带你搭建分布式实时分析平台!
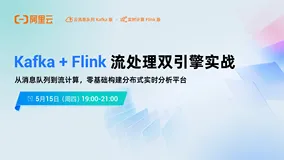
在数字化转型中,企业亟需从海量数据中快速提取价值并转化为业务增长动力。5月15日19:00-21:00,阿里云三位技术专家将讲解Kafka与Flink的强强联合方案,帮助企业零门槛构建分布式实时分析平台。此组合广泛应用于实时风控、用户行为追踪等场景,具备高吞吐、弹性扩缩容及亚秒级响应优势。直播适合初学者、开发者和数据工程师,参与还有机会领取定制好礼!扫描海报二维码或点击链接预约直播:[https://developer.aliyun.com/live/255088](https://developer.aliyun.com/live/255088)
892 35
直播预告|Kafka+Flink双引擎实战:手把手带你搭建分布式实时分析平台!
|
存储 分布式计算 数据处理
「48小时极速反馈」阿里云实时计算Flink广招天下英雄
阿里云实时计算Flink团队,全球领先的流计算引擎缔造者,支撑双11万亿级数据处理,推动Apache Flink技术发展。现招募Flink执行引擎、存储引擎、数据通道、平台管控及产品经理人才,地点覆盖北京、杭州、上海。技术深度参与开源核心,打造企业级实时计算解决方案,助力全球企业实现毫秒洞察。
1215 0
「48小时极速反馈」阿里云实时计算Flink广招天下英雄
|
消息中间件 关系型数据库 MySQL
Flink CDC 在阿里云实时计算Flink版的云上实践
本文整理自阿里云高级开发工程师阮航在Flink Forward Asia 2024的分享,重点介绍了Flink CDC与实时计算Flink的集成、CDC YAML的核心功能及应用场景。主要内容包括:Flink CDC的发展及其在流批数据处理中的作用;CDC YAML支持的同步链路、Transform和Route功能、丰富的监控指标;典型应用场景如整库同步、Binlog原始数据同步、分库分表同步等;并通过两个Demo展示了MySQL整库同步到Paimon和Binlog同步到Kafka的过程。最后,介绍了未来规划,如脏数据处理、数据限流及扩展数据源支持。
1330 0
Flink CDC 在阿里云实时计算Flink版的云上实践
|
存储 关系型数据库 BI
实时计算UniFlow:Flink+Paimon构建流批一体实时湖仓
实时计算架构中,传统湖仓架构在数据流量管控和应用场景支持上表现良好,但在实际运营中常忽略细节,导致新问题。为解决这些问题,提出了流批一体的实时计算湖仓架构——UniFlow。该架构通过统一的流批计算引擎、存储格式(如Paimon)和Flink CDC工具,简化开发流程,降低成本,并确保数据一致性和实时性。UniFlow还引入了Flink Materialized Table,实现了声明式ETL,优化了调度和执行模式,使用户能灵活调整新鲜度与成本。最终,UniFlow不仅提高了开发和运维效率,还提供了更实时的数据支持,满足业务决策需求。

推荐镜像

更多