EMR Serverless Spark服务最佳实践测评

简介: EMR Serverless Spark服务最佳实践测评

数据分析实践场景

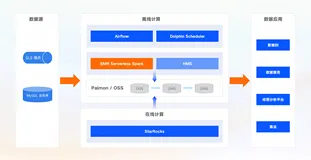
  • 用户行为分析:利用EMR Serverless Spark[1]的弹性扩展能力,可以迅速处理大规模用户行为日志,进行实时分析,如点击流分析、用户路径分析等,助力产品优化与个性化推荐。[1]
  • 标签画像构建:集成多样化数据源,如数据库、日志服务等,运用Spark的高级分析功能,高效构建用户标签体系,提升营销精准度和用户体验。[1]

性能与运维对比

  • 稳定性与性能:相比自建Spark集群,EMR Serverless Spark通过云原生优化,提供更稳定的运行环境和更高的执行效率,特别是在与云存储(如OSS)集成的场景下,性能提升可达3-5倍。[1]
  • 运维简便性:0运维特性显著降低运营成本,用户无需关注基础设施配置、扩缩容等操作,极大简化了管理复杂度。[1]

成本与收益分析

  • 成本效益:Serverless模式按需计费,作业完成后才计费,无闲置成本,适合波动性大的数据处理需求,显著降低了总体拥有成本(TCO)。[1]
  • 收益提升:一站式数据开发平台加速了数据价值的转化周期,快速响应市场变化,提升决策效率和业务创新能力。[1]

EMR Serverless Spark服务体验评测

产品引导与文档

  • 引导与文档:体验中发现产品内引导清晰,文档覆盖广泛,但针对特定场景的最佳实践案例和故障排查指南可以进一步丰富,以提升用户自助解决问题的能力。[1]

功能满足度

  • 功能全面性:接入便捷,数据开发体验流畅,弹性伸缩功能有效应对突发流量,但用户权限管理的细化程度和跨地域数据处理能力仍有提升空间。[1]

改进建议

  • 改进方向:增强与阿里云生态内其他产品的集成,如与DataWorks、MaxCompute的无缝对接,以及提供更多开箱即用的机器学习算法库,以支持更复杂的AI驱动的数据分析场景。[1]

OLAP引擎对比测评

Spark引擎体验

  • 优势:EMR Serverless Spark在功能上支持广泛的大数据处理需求,性能优化显著,尤其是与云存储集成的场景。弹性扩缩容能力满足了动态资源需求,内置的Fusion Engine提升了数据查询速度。[1]
  • 待改进:虽然提供了良好的版本控制和环境隔离,但在某些高度定制化需求或特定行业标准支持方面,可能需要更多定制化选项和更细致的权限管理策略。[1]

综上所述,EMR Serverless Spark作为一款全托管、一站式的数据计算服务,在简化大数据处理流程、降低成本、提升性能与稳定性方面表现出色,但仍有一定的优化空间,尤其是在深度集成与定制化服务方面,以更好地适应多样化的业务场景需求。

相关链接
Serverless Spark概述 解决方案 https://help.aliyun.com/document_detail/124303.html
应用场景 建立数据平台 https://help.aliyun.com/zh/emr/emr-serverless-spark/product-overview/use-scenarios
什么是EMR Serverless Spark https://help.aliyun.com/zh/emr/emr-serverless-spark/product-overview/what-is-emr-serverless-spark
E-MapReduce Serverless Spark 版 https://www.aliyun.com/product/bigdata/serverlessspark

相关实践学习
【玩转ComfyUI】基于函数计算一键部署AI生图平台ComfyUI
本次实验将带大家通过使用阿里云产品函数计算FC,快速使用ComfyUI实现更高质量的图像生成。
从 0 入门函数计算
在函数计算的架构中,开发者只需要编写业务代码,并监控业务运行情况就可以了。这将开发者从繁重的运维工作中解放出来,将精力投入到更有意义的开发任务上。
相关文章
|
SQL 分布式计算 Serverless
鹰角网络:EMR Serverless Spark 在《明日方舟》游戏业务的应用
鹰角网络为应对游戏业务高频活动带来的数据潮汐、资源弹性及稳定性需求,采用阿里云 EMR Serverless Spark 替代原有架构。迁移后实现研发效率提升,支持业务快速发展、计算效率提升,增强SLA保障,稳定性提升,降低运维成本,并支撑全球化数据架构部署。
1746 56
鹰角网络:EMR Serverless Spark 在《明日方舟》游戏业务的应用
|
分布式计算 运维 搜索推荐
立马耀:通过阿里云 Serverless Spark 和 Milvus 构建高效向量检索系统,驱动个性化推荐业务
蝉妈妈旗下蝉选通过迁移到阿里云 Serverless Spark 及 Milvus,解决传统架构性能瓶颈与运维复杂性问题。新方案实现离线任务耗时减少40%、失败率降80%,Milvus 向量检索成本降低75%,支持更大规模数据处理,查询响应提速。
937 57
|
人工智能 分布式计算 DataWorks
一体系数据平台的进化:基于阿里云 EMR Serverless Spark 的持续演进
本文介绍了一体系汽配供应链平台如何借助阿里云EMR Serverless Spark实现从传统Hadoop平台向云原生架构的迁移。通过融合高质量零部件供应与创新互联网科技,一体系利用EMR Serverless Spark和DataWorks构建高效数据分析体系,解决大规模数据处理瓶颈。方案涵盖实时数据集成、Lakehouse搭建、数仓分层设计及BI/ML应用支持,显著提升数据处理性能与业务响应速度,降低运维成本,为数字化转型奠定基础。最终实现研发效率提升、运维压力减轻,并推动AI技术深度整合,迈向智能化云原生数据平台。
657 4
|
分布式计算 运维 监控
Fusion 引擎赋能:流利说如何用阿里云 Serverless Spark 实现数仓计算加速
本文介绍了流利说与阿里云合作,利用EMR Serverless Spark优化数据处理的全过程。流利说是科技驱动的教育公司,通过AI技术提升用户英语水平。原有架构存在资源管理、成本和性能等痛点,采用EMR Serverless Spark后,实现弹性资源管理、按需计费及性能优化。方案涵盖数据采集、存储、计算到查询的完整能力,支持多种接入方式与高效调度。迁移后任务耗时减少40%,失败率降低80%,成本下降30%。未来将深化合作,探索更多行业解决方案。
1263 1
|
人工智能 分布式计算 大数据
大数据≠大样本:基于Spark的特征降维实战(提升10倍训练效率)
本文探讨了大数据场景下降维的核心问题与解决方案,重点分析了“维度灾难”对模型性能的影响及特征冗余的陷阱。通过数学证明与实际案例,揭示高维空间中样本稀疏性问题,并提出基于Spark的分布式降维技术选型与优化策略。文章详细展示了PCA在亿级用户画像中的应用,包括数据准备、核心实现与效果评估,同时深入探讨了协方差矩阵计算与特征值分解的并行优化方法。此外,还介绍了动态维度调整、非线性特征处理及降维与其他AI技术的协同效应,为生产环境提供了最佳实践指南。最终总结出降维的本质与工程实践原则,展望未来发展方向。
|
分布式计算 大数据 Apache
ClickHouse与大数据生态集成:Spark & Flink 实战
【10月更文挑战第26天】在当今这个数据爆炸的时代,能够高效地处理和分析海量数据成为了企业和组织提升竞争力的关键。作为一款高性能的列式数据库系统,ClickHouse 在大数据分析领域展现出了卓越的能力。然而,为了充分利用ClickHouse的优势,将其与现有的大数据处理框架(如Apache Spark和Apache Flink)进行集成变得尤为重要。本文将从我个人的角度出发,探讨如何通过这些技术的结合,实现对大规模数据的实时处理和分析。
1407 2
ClickHouse与大数据生态集成:Spark & Flink 实战
|
存储 分布式计算 Hadoop
从“笨重大象”到“敏捷火花”:Hadoop与Spark的大数据技术进化之路
972 79
|
存储 分布式计算 算法
大数据-106 Spark Graph X 计算学习 案例:1图的基本计算、2连通图算法、3寻找相同的用户
601 0
|
消息中间件 分布式计算 NoSQL
大数据-104 Spark Streaming Kafka Offset Scala实现Redis管理Offset并更新
474 0

热门文章

最新文章